Bài viết này là phiên bản văn bản của bài giảng đầu tiên trong khóa học “Nền tảng các Mô hình Ngôn ngữ Lớn” (Foundations of Large Language Models) mà tôi giảng dạy tại chương trình Thạc sĩ MVA ở Paris.
Triết lý mà tôi muốn truyền tải xuyên suốt chuỗi bài giảng này là học qua thực hành (learn by doing) — và điều đó lại càng thấm thía hơn trong kỷ nguyên mà các tác tử AI (AI agents) đã có thể viết code thay bạn. Bài viết có rất nhiều bài tập thực hành, hầu hết đều có thể hoàn thành trong chưa đầy 30 phút với tối đa vài chục dòng lệnh. Nếu thực sự muốn nắm vững các nguyên lý nền tảng của Mô hình Ngôn ngữ Lớn (LLM), tôi đặc biệt khuyên bạn hãy tự tay làm các bài tập này… mà không nhờ đến sự trợ giúp của bất kỳ công cụ sinh code AI nào!
Mỗi bài tập đều đi kèm phần phát biểu bài toán và một đoạn mã khởi đầu (starter code) để nạp dữ liệu. Các gợi ý và lời giải được thu gọn lại để bạn không vô tình nhìn thấy ngay từ đầu, đồng thời mục kiểm tra (checkpoint) sẽ cho bạn biết kết quả kỳ vọng để đối chiếu.
Chúc bạn tìm thấy nhiều niềm vui khi vừa học vừa làm! (và đừng ngần ngại liên hệ với tôi nếu bạn phát hiện bất kỳ sai sót nào)
Bài viết đầu tiên này bàn về Xử lý Ngôn ngữ Tự nhiên (Natural Language Processing — NLP) cổ điển, trước kỷ nguyên của các LLM.
Tôi biết bạn đang nghĩ gì. Việc học lại NLP thế hệ cũ nghe có vẻ như đang lãng phí thời gian, bởi phần lớn những kỹ thuật này đều đã bị thay thế bởi các LLM hiện đại.
Tuy vậy, tôi tin rằng dành ra vài giờ cho chặng đường này là hoàn toàn xứng đáng. Trước hết, bạn sẽ nắm được những khái niệm cốt lõi vẫn còn nguyên giá trị cho đến tận ngày nay. Bạn cũng sẽ hiểu rõ hơn “phả hệ của các ý tưởng” — một nền tảng vô cùng quan trọng để rèn luyện gu thẩm mỹ nghiên cứu (research taste) của riêng mình. Đặc biệt, bạn sẽ thấy rõ vì sao và bằng cách nào kiến trúc Transformer lại ra đời rồi nhanh chóng thống lĩnh toàn bộ lĩnh vực. Cuối cùng, bài viết này điểm qua vài chục công trình khoa học kinh điển mà bất kỳ ai muốn theo đuổi chủ đề này một cách nghiêm túc cũng nên đọc qua ít nhất một lần trong đời.
Trong chương đầu tiên này, chúng ta sẽ lần theo hai câu hỏi lớn từng định hình sự phát triển của toàn bộ lĩnh vực NLP:
- Làm thế nào để xây dựng một mô hình học máy nhận đầu vào là một đoạn văn bản, khi mà văn bản đó không hề có độ dài cố định?
- Làm thế nào để chuyển giao (transfer) những gì mô hình đã học được từ tác vụ này sang tác vụ khác, dựa trên thực tế rằng ở mọi bài toán NLP, bản chất của ngôn ngữ về cơ bản vẫn là một?
Để khám phá hai câu hỏi trên, chúng ta sẽ thực hành chủ yếu với hai tác vụ và hai bộ dữ liệu:
- Đánh giá phim IMDB (IMDB movie reviews) cho bài toán phân loại cảm xúc (sentiment classification)
- WikiText-2 cho bài toán mô hình hóa ngôn ngữ (language modeling).
- IMDB (Maas et al., 2011): bộ dữ liệu gồm 50.000 bài đánh giá phim được gán nhãn tích cực (positive) hoặc tiêu cực (negative), chia thành 25.000 mẫu huấn luyện và 25.000 mẫu kiểm tra. Bạn có thể tải về trên Hugging Face Hub tại stanfordnlp/imdb. Lưu ý rằng bộ dữ liệu này còn có một tập con chứa 50.000 bài đánh giá chưa gán nhãn.
- WikiText-2 (Merity et al., 2016): gồm khoảng 2 triệu từ huấn luyện trích từ các bài viết trên Wikipedia, với vốn từ vựng (vocabulary) khoảng 33.000 từ. Hãy sử dụng phiên bản đã tách từ (
wikitext-2-v1): dấu câu đã được tách sẵn bằng khoảng trắng, và các từ hiếm đã được thay thế bằng token<unk>. Tải về trên Hugging Face Hub tại Salesforce/wikitext.
Các bộ dữ liệu hữu ích khác gồm có:
- TinyShakespeare: khoảng 1 triệu ký tự từ các vở kịch của Shakespeare, bắt nguồn từ dự án char-rnn của Andrej Karpathy. Bộ dữ liệu này chỉ được dùng làm minh họa phụ cho bài toán sinh văn bản ở cấp độ ký tự (character-level generation). Tải về trên Hugging Face Hub tại jchwenger/tiny_shakespeare.
- text8: 100 MB đầu tiên của bản trích xuất Wikipedia tiếng Anh đã qua làm sạch (ban đầu do Matt Mahoney tổng hợp), là kho ngữ liệu (corpus) tiêu chuẩn để huấn luyện mô hình word2vec. Tải về trên Hugging Face Hub tại afmck/text8.
1. Các tác vụ điển hình của NLP
Ngày nay, khi đang sống trong thế giới của các LLM, chúng ta rất dễ mặc định rằng mô hình hóa ngôn ngữ tự hồi quy (autoregressive language modeling) là tất cả những gì thuộc về NLP. Thế nhưng trước năm 2019 — thời điểm giới nghiên cứu nhận ra GPT-2 có khả năng sinh văn bản mạch lạc và nhờ đó giải quyết được nhiều bài toán khác mà không cần huấn luyện chuyên biệt cho từng bài toán — mô hình hóa ngôn ngữ chỉ là một trong số rất nhiều tác vụ của NLP cổ điển.
Suốt nhiều thập kỷ, phân loại văn bản (text classification), gán nhãn chuỗi (tagging) và dịch máy (translation) mới là những thách thức quan trọng bậc nhất được giải quyết bằng các công cụ học máy.
Mỗi tác vụ trong số bốn tác vụ này đều có thể được biểu diễn một cách hình thức thành bài toán học các phân phối xác suất có điều kiện dựa trên một đoạn văn bản đầu vào, trong đó văn bản được xem như một chuỗi các từ. Minh họa dưới đây thể hiện trực quan góc nhìn này.
Hãy cùng điểm qua từng tác vụ này.
1.1 Phân loại văn bản (Classification)
Đây là tác vụ dễ phát biểu nhất trong NLP: bạn nhận vào một đoạn văn bản và phải phân loại nó vào một danh sách các danh mục (lớp) đã được định nghĩa trước. Đó có thể là phát hiện thư rác (spam detection), phân tích cảm xúc (sentiment analysis — “Bài đánh giá phim này khen hay chê?”), hoặc phân loại chủ đề (“Bài báo này viết về thể thao, chính trị hay công nghệ…?”).
Để làm được điều đó, bộ phân loại (classifier) cần học được xác suất có điều kiện:
biểu thị khả năng một chuỗi từ thuộc về lớp , trong đó độ dài không cố định trước (a priori) mà thay đổi tùy theo từng chuỗi văn bản.
Như đã thấy ở ví dụ mở đầu bài viết (“Chà, quả là một kiệt tác. […] Một bộ phim hoàn hảo nếu bạn thích ngủ gật.”), bài toán phân loại cảm xúc có thể rất tinh vi và đòi hỏi mô hình phải nhận diện được những sắc thái như sự mỉa mai, châm biếm (sarcasm).
1.2 Mô hình hóa ngôn ngữ (Language modeling)
Về mặt nguyên lý, mô hình hóa một ngôn ngữ đồng nghĩa với việc học phân phối xác suất của mọi chuỗi từ khả dĩ trong ngôn ngữ đó. Tuy nhiên trong thực tế, việc học xác suất của từ tiếp theo (next-word probability) thường thuận tiện hơn rất nhiều:
Từ xác suất dự đoán từ tiếp theo này, chúng ta có thể dễ dàng khôi phục lại xác suất của toàn bộ chuỗi bằng quy tắc dây chuyền (chain rule), chẳng hạn:
Dưới góc nhìn hiện đại, ứng dụng chính của phân phối xác suất này là sinh văn bản theo cơ chế tự hồi quy (autoregression): lấy mẫu một từ từ phân phối từ tiếp theo, nối từ đó vào cuối văn bản hiện tại, rồi lặp lại quá trình. Đây chính là nguyên lý vận hành đằng sau các chatbot và tác tử LLM ngày nay.
Thế nhưng việc nắm được phân phối xác suất của ngôn ngữ còn mang lại nhiều ứng dụng khác, ví dụ như chấm điểm xác suất cho các câu ứng viên trong một danh sách. Hãy hình dung một mô hình Nhận dạng Giọng nói Tự động (Automatic Speech Recognition — ASR) đưa ra hai bản gỡ băng ứng viên đều khớp khá hợp lý với mẫu âm thanh thu được: ta có thể bổ sung một bước hậu xử lý dùng mô hình ngôn ngữ để chấm điểm hai ứng viên này và chọn ra câu đúng. Chẳng hạn, với bất kỳ mô hình ngôn ngữ hợp lý nào, xác suất của câu “Thuyết tương đối rộng được xây dựng bởi Alfred Einstein” chắc chắn sẽ thấp hơn nhiều so với câu “Thuyết tương đối rộng được xây dựng bởi Albert Einstein”.
Mặc dù tôi trình bày tách biệt hai mục, nhưng có một nhận thức rất quan trọng cần ghi nhớ: dự đoán từ tiếp theo thực chất chính là một dạng bài toán phân loại! Thay vì gán xác suất cho một tập hữu hạn các lớp phân loại, bạn gán xác suất cho một tập hữu hạn các từ nằm trong bộ từ vựng đã định trước. Khác biệt thực tiễn lớn nhất nằm ở quy mô: các bài toán phân loại trong NLP thường chỉ có một vài lớp, trong khi kích thước bộ từ vựng trong mô hình hóa ngôn ngữ thường lên tới hàng chục nghìn từ.
1.3 Dịch máy (Translation)
Dịch từ ngôn ngữ này sang ngôn ngữ khác từ lâu đã là một trong những tác vụ quan trọng nhất của NLP, đồng thời cũng là một bài toán vô cùng hóc búa. Một cách hình thức, chúng ta muốn học xác suất của một câu dịch ứng viên khi biết câu gốc . Tương tự như trên, trong thực tế, ta thường tìm cách ước lượng xác suất của từ tiếp theo trong chuỗi dịch, có điều kiện trên câu gốc và những từ đã được dịch ra trước đó:
Lưu ý rằng việc học phân phối xác suất này hoàn toàn không hề hiển nhiên, bởi hai câu ở hai ngôn ngữ vốn không có cùng độ dài, và phép dịch nhìn chung không phải là sự tương ứng một-đối-một giữa từng từ.
Hơn thế nữa, trật tự từ giữa các ngôn ngữ có thể khác biệt hoàn toàn. Hãy xem ví dụ thú vị dưới đây thể hiện cùng một câu trong 4 ngôn ngữ… bạn nhất định nên thử so sánh giữa tiếng Anh và tiếng Thổ Nhĩ Kỳ!
1.4 Gán nhãn chuỗi (Tagging)
Cuối cùng, một tác vụ tiêu biểu khác trong NLP là gán nhãn chuỗi (tagging). Mục tiêu của bài toán là gán một lớp (nhãn) cho từng từ (hoặc từng cụm từ). Đó có thể là phát hiện lỗi ngữ pháp, hoặc gán nhãn từ loại cho mỗi từ trong câu (danh từ, động từ,…), một tác vụ được gọi là gán nhãn từ loại (part-of-speech tagging — POS tagging).
Đó cũng có thể là bài toán Nhận diện Thực thể có Tên (Named Entity Recognition — NER), chẳng hạn như đánh dấu tất cả tên người (hoặc tất cả địa danh) xuất hiện trong văn bản.
Có thể xem bài toán gán nhãn chuỗi như “một bộ phân loại được áp dụng cho từng từ”, nhưng ở mỗi vị trí đều có xét đến ngữ cảnh xung quanh:
Trong khuôn khổ bài viết này, tôi sẽ không đi sâu vào bài toán gán nhãn chuỗi.
2. Đếm từ: các mô hình ngôn ngữ đơn giản nhất dựa trên n-gram
Vì các mô hình ngôn ngữ sẽ là mối quan tâm chính của chúng ta ở những phần sau của chuỗi bài giảng, rất đáng để bắt đầu bằng một ví dụ mang tính lịch sử, đại diện cho cách thức đơn giản nhất để sinh ngôn ngữ theo kiểu tự hồi quy: mô hình Markov (Markov model).
2.1 Mô hình Markov (Markov model)
Nếu bạn thực sự muốn có một mô hình ngôn ngữ đơn giản nhất (và cũng kém hiệu quả nhất), bạn chỉ việc bốc ngẫu nhiên các từ trong bộ từ vựng theo đúng tần suất xuất hiện tự nhiên của chúng trong ngôn ngữ. Đây được gọi là mô hình unigram (1-gram), trong đó:
với là số lần xuất hiện (tần số đếm) của từ trong kho ngữ liệu huấn luyện, và là tổng quy mô của kho ngữ liệu. Đây là một mô hình vô cùng thô sơ! Ít nhất chúng ta có thể cải thiện nó bằng cách xét các cặp từ liên tiếp — tức bigram (2-gram), hay chính là mô hình chuỗi Markov.
Chuỗi Markov đơn giản (Simple Markov chain)
Trong mô hình chuỗi Markov bigram đơn giản nhất, xác suất xuất hiện của một từ trong chuỗi chỉ phụ thuộc vào duy nhất từ đứng ngay trước nó:
Giả định này tất nhiên là không đúng với ngôn ngữ tự nhiên của con người, nhưng đổi lại nó cho phép mô hình hóa cực kỳ đơn giản chỉ bằng một ma trận chuyển trạng thái (transition matrix).
Sử dụng tập huấn luyện, chúng ta chỉ cần đếm số lần xuất hiện của mỗi từ và của mỗi cặp từ liên tiếp . Sau đó, ta dùng các số đếm này để tính xác suất để từ xuất hiện ngay sau từ . Các xác suất này xác định một ma trận chuyển trạng thái, có thể dùng trực tiếp để sinh văn bản tự hồi quy bằng mô hình Chuỗi Markov.
Hãy thử nghiệm ngay ý tưởng đó qua bài tập dưới đây.
Bài tập 2.1 Xây dựng mô hình chuỗi Markov
Sử dụng dữ liệu WikiText-2, hãy đếm số lần xuất hiện của các cặp từ liên tiếp và dùng chúng để sinh ra một chuỗi gồm 50 từ bằng mô hình chuỗi Markov.
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")
print(wikitext["train"][4]["text"][:70])   # 70 ký tự đầu của dòng 4
The game began development in 2010 , carrying over a large portion of
Hint
Hãy quan sát một mẫu dữ liệu của WikiText-2. Văn bản đã được tiền xử lý sẵn, bạn chỉ cần tách chuỗi theo khoảng trắng để thu được các từ. Hãy giữ nguyên mọi từ như hiện trạng, bao gồm cả các dấu = trong tiêu đề mục (những dòng như = = History = =), ký hiệu @-@ đại diện cho dấu gạch nối (role @-@ playing), cũng như @,@ và @.@ đại diện cho dấu phẩy và dấu chấm thập phân bên trong các con số (14 @,@ 000, 5 @.@ 5).
Lưu ý rằng bộ dữ liệu đã thay thế các từ hiếm (những từ có số lần xuất hiện dưới 3) bằng từ <unk>. Nhờ vậy, mọi từ trong tập xác thực (validation set) và tập kiểm tra (test set) đều có mặt trong văn bản huấn luyện, không có từ nào bị gán xác suất bằng 0 vì lý do ngoài từ vựng.
Hint
Bộ từ vựng quá lớn để có thể lưu trữ hiệu quả toàn bộ ma trận đếm kích thước — vốn dĩ sẽ cực kỳ thưa (sparse). Hãy sử dụng một từ điển lồng nhau (nested dictionary) dạng {'the' : {'dog' : 3, ...}, ...} để đếm số lần xuất hiện của từng cặp từ.
Hint
Hàm random.choices(words, weights=counts) giúp lấy mẫu ngẫu nhiên một từ với xác suất tỷ lệ thuận với số đếm của nó; bước chuẩn hóa xác suất được thực hiện tự động.
Điểm kiểm tra kết quả bạn cần đạt được
Tập huấn luyện có 2.051.910 từ. Bộ từ vựng gồm 33.277 từ, bao gồm cả <unk> và =. Có 618.405 cặp từ phân biệt trên tổng số tỷ cặp từ khả dĩ.
Với một hạt giống ngẫu nhiên (seed) khác, đoạn văn bản mẫu của bạn sẽ khác đi nhưng nhìn chung vẫn mang đặc điểm tương tự: từng cặp từ liên tiếp nghe rất hợp lý, nhưng tổng thể cả câu lại hoàn toàn vô nghĩa.
text: 2051910 words
vocabulary: 33277 words
distinct pairs: 618405

The institute . " and long , Mortimer Wheeler secured by worry over the Song military officer notable example of willows along the Richmond Chamber of the opening sequence stars except those produced , In November 23 January 1908 Distinguished Service before dissipating as a more able to bring the
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")
print(wikitext["train"][4]["text"][:70])   # 70 ký tự đầu của dòng 4
The game began development in 2010 , carrying over a large portion of
# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# (2) Dùng từ điển lồng nhau để đếm các cặp từ (bigram)
bigram_counts = {}
for a, b in zip(train_sequence, train_sequence[1:]):
    if a not in bigram_counts:
        bigram_counts[a] = {}
    if b not in bigram_counts[a]:
        bigram_counts[a][b] = 0
    bigram_counts[a][b] += 1

print(f"distinct pairs: {sum(len(f) for f in bigram_counts.values())}")


# (3) Sinh chuỗi từ bằng random.choices với trọng số là số lần xuất hiện
first_word = "The"
length = 50

import random
random.seed(0)

sample_words = [first_word]
while len(sample_words) < length:
    followers = bigram_counts[sample_words[-1]]
    options, weights = list(followers), list(followers.values())
    next_word = random.choices(options, weights)[0]
    sample_words.append(next_word)

print("\n" + " ".join(sample_words))
text: 2051910 words
vocabulary: 33277 words
distinct pairs: 618405

The institute . " and long , Mortimer Wheeler secured by worry over the Song military officer notable example of willows along the Richmond Chamber of the opening sequence stars except those produced , In November 23 January 1908 Distinguished Service before dissipating as a more able to bring the
Như bạn có thể thấy, văn bản sinh ra không có ý nghĩa mạch lạc, nhưng trật tự từ cục bộ nhìn chung khá đúng ngữ pháp.
Mô hình n-gram (n-gram models)
Chúng ta cũng có thể mở rộng mô hình bằng cách sử dụng các n-gram, tức các cụm gồm từ liên tiếp. Khi đó, để dự đoán từ tiếp theo, ta lấy chuỗi từ đứng ngay trước nó làm đầu vào. Mô hình chuỗi Markov ở mục 2.1 ứng với , còn mô hình unigram ứng với (không sử dụng bất kỳ ngữ cảnh nào).
Khi dùng n-gram, ma trận chuyển trạng thái sẽ có kích thước , con số này bùng nổ cực kỳ nhanh chóng (chẳng hạn với và , ta có khoảng phần tử). Trong thực tế, một lần nữa chúng ta chỉ lưu trữ những n-gram thực sự xuất hiện vào một từ điển đếm, chứ không lưu toàn bộ bảng.
Dưới đây bạn có thể khám phá các ví dụ thực tế trên tập WikiText-2 với nhiều giá trị khác nhau.
2.2 So sánh các phân phối xác suất
Trong bài toán mô hình hóa ngôn ngữ, mục tiêu của chúng ta là xấp xỉ phân phối xác suất “thực” của từ tiếp theo. Hãy ký hiệu phân phối thực này là . Bất kỳ mô hình ngôn ngữ ứng viên nào cũng sẽ đưa ra một phân phối dự đoán (trong mô hình Markov n-gram, phân phối này chỉ phụ thuộc vào ).
Làm thế nào để đo lường mức độ thành công? Nói cách khác, làm sao ta định lượng được mức độ giống nhau giữa và ?
Phân kỳ KL (KL Divergence) và hàm mất mát entropy chéo (cross-entropy loss)
Để đánh giá xem một phân phối xác suất có phải là xấp xỉ tốt cho một phân phối khác hay không, công cụ tiêu chuẩn được lựa chọn là phân kỳ Kullback–Leibler (Kullback–Leibler divergence — KL divergence):
Ở đây tôi viết công thức với hai phân phối tổng quát và , nhưng lưu ý rằng định nghĩa này hoàn toàn áp dụng được cho các xác suất có điều kiện, chẳng hạn trong trường hợp của chúng ta là và .
Việc tìm phân phối xấp xỉ tốt nhất một phân phối cho trước đồng nghĩa với việc cực tiểu hóa phân kỳ KL. Tuy nhiên trong bài toán của chúng ta, vì phân phối thực chưa biết trước (a priori), việc tính chính xác đại lượng này thoạt nhìn có vẻ bất khả thi. Thế nhưng để cực tiểu hóa phân kỳ KL, trước hết ta có thể nhận xét rằng biểu thức logarit bên trong có thể tách thành hai phần:
Số hạng đầu tiên chính là (trừ) entropy của (đại lượng này hoàn toàn không phụ thuộc vào ), còn số hạng thứ hai được gọi là entropy chéo (cross-entropy).
Vì entropy chéo:
là thành phần duy nhất thực sự phụ thuộc vào , nên bài toán quy về việc tìm phân phối sao cho đại lượng này đạt giá trị nhỏ nhất.
Việc tìm để cực tiểu hóa phân kỳ KL hoàn toàn tương đương với việc cực tiểu hóa entropy chéo .
Bạn có thể trực tiếp trải nghiệm trực giác này trên một ví dụ rất đơn giản dưới đây bằng cách kéo thả các cột của phân phối màu cam.
Hợp lý cực đại (Likelihood)
Bây giờ hãy quay lại với hệ thống ký hiệu của bài toán và nhớ rằng chúng ta đang làm việc với các xác suất có điều kiện và để từ xuất hiện tiếp theo khi biết ngữ cảnh .
Nếu phân phối phụ thuộc vào bộ tham số , ta cần cực tiểu hóa entropy chéo:
biểu thức này có thể được hiểu như kỳ vọng toán học trên phân phối xác suất :
Một lần nữa, chúng ta không thể tính trực tiếp đại lượng này vì không biết phân phối thực , nhưng kho ngữ liệu văn bản của chúng ta chính là một mẫu dữ liệu được rút ra từ .
Tại mỗi vị trí trong văn bản, ngữ cảnh được nối tiếp bởi từ thực sự xuất hiện tại đó. Hầu hết các ngữ cảnh dài chỉ xuất hiện đúng một lần, nên ta không bao giờ quan sát được toàn bộ phân phối , mà chỉ thấy duy nhất một từ được lấy mẫu từ phân phối ấy. Tuy nhiên, giá trị trung bình tính trên toàn bộ vị trí của văn bản sẽ cho ta một ước lượng của entropy chéo, lấy trung bình theo đúng tần suất xuất hiện tự nhiên của các ngữ cảnh trong ngôn ngữ:
Giá trị trung bình này mang một ý nghĩa rất trực quan. Tổng của các logarit chính là logarit của một tích, và theo quy tắc dây chuyền ở mục 1.2, tích chính là xác suất mà mô hình gán cho toàn bộ văn bản — hay còn gọi là độ hợp lý (likelihood) của văn bản. Do đó, là trung bình log-hợp lý âm (negative log-likelihood — NLL) tính trên mỗi từ của văn bản, và việc cực tiểu hóa entropy chéo hoàn toàn tương đương với việc cực đại hóa độ hợp lý (maximizing likelihood) của kho ngữ liệu.
Để huấn luyện mô hình, chúng ta chọn bộ tham số (chẳng hạn như các trọng số của mạng nơ-ron) sao cho cực tiểu hóa trên một văn bản huấn luyện. Bản thân mỗi số hạng trong tổng trên cũng là một entropy chéo: đó là entropy chéo giữa và phân phối dồn toàn bộ xác suất bằng 1 vào đúng từ thực tế quan sát được (phân phối one-hot), đóng vai trò đại diện cho phân phối chưa biết:
Đây chính là hàm mất mát entropy chéo (cross-entropy loss) được sử dụng để huấn luyện mọi mô hình ngôn ngữ, bao gồm cả các LLM hiện đại. Một số hạng đơn lẻ như vậy là một ước lượng nhiều nhiễu, nhưng khi lấy trung bình trên toàn bộ các từ của văn bản, đạo hàm (gradient) của nó chính là . Vì entropy của không phụ thuộc vào , đại lượng này cũng chính bằng .
Cực đại hóa độ hợp lý (Likelihood) = Cực tiểu hóa hàm mất mát entropy chéo (Cross-entropy loss) = Cực tiểu hóa phân kỳ KL (KL divergence).
Đối với các mô hình n-gram, chúng ta thậm chí không cần dùng đến gradient: tỷ số đếm ở mục 2.1 chính là nghiệm giải tích giúp cực đại hóa độ hợp lý trên văn bản huấn luyện.
Độ hỗn loạn (Perplexity)
Tuy nhiên, giá trị entropy chéo thường khó đọc và khó diễn giải trực quan, nên trong thực tế người ta thường báo cáo hàm mũ của nó, gọi là độ hỗn loạn (perplexity) của mô hình trên văn bản:
Về mặt toán học, đây là nghịch đảo của trung bình nhân các xác suất mà mô hình gán cho từng từ trong văn bản. Một mô hình dự đoán phân phối đều (uniform) trên từ sẽ có perplexity bằng đúng ; vì vậy, độ hỗn loạn (perplexity) có thể được diễn giải trực quan là số lượng từ mà mô hình đang phải phân vân lựa chọn ở mỗi bước dự đoán.
Đọc thêm Tập xác thực (validation) và tập kiểm tra (test): vì sao chúng ta cần hai văn bản tách biệt ngoài tập huấn luyện
Vậy chúng ta nên đo perplexity trên văn bản nào? Chắc chắn không phải trên văn bản huấn luyện: mô hình được khớp trực tiếp vào chính những từ đó, nên perplexity đo trên tập huấn luyện sẽ lạc quan một cách giả tạo. Một mô hình chỉ học thuộc lòng văn bản huấn luyện sẽ gán xác suất cực cao cho văn bản đó, nhưng lại dự đoán rất tệ trên văn bản mới. Để đánh giá khách quan mức độ xấp xỉ tốt đến đâu, ta cần một mẫu dữ liệu khác cũng sinh ra từ mà mô hình chưa từng nhìn thấy: một tập dữ liệu tách biệt (held-out set).
Bộ dữ liệu WikiText-2 đi kèm với hai tập tách biệt như vậy. Tập xác thực (validation set) được dùng cho mọi quyết định lựa chọn siêu tham số của mô hình, chẳng hạn như giá trị của (hoặc các trọng số nội suy mà ta sẽ giới thiệu ở mục 2.3): ta thử nghiệm nhiều giá trị và giữ lại cấu hình có perplexity trên tập xác thực thấp nhất. Tuy nhiên, việc lựa chọn theo cách này cũng khiến mô hình bị khớp nhẹ vào tập xác thực, nên perplexity trên tập xác thực của mô hình được chọn vẫn hơi lạc quan quá mức. Do đó, tập kiểm tra (test set) chỉ được sử dụng duy nhất một lần vào lúc cuối cùng, để đo con số perplexity chính thức được công bố.
Trong các bài tập thực hành, chúng ta sẽ đo perplexity trên tập xác thực, và chỉ tính perplexity trên tập kiểm tra để so sánh tổng thể các mô hình ở mục 6.
Bài tập 2.2 Đo độ hỗn loạn (perplexity) của mô hình unigram và bigram
Sử dụng kết quả đếm từ bài tập 2.1, hãy tính perplexity của mô hình unigram và mô hình bigram trên tập xác thực của WikiText-2. Bạn có nhận thấy vấn đề gì không? Sau đó, hãy tính perplexity của mô hình unigram trên tập kiểm tra.
Đoạn mã khởi đầu lặp lại bước (1) và (2) trong lời giải bài tập 2.1 nhằm xây dựng chuỗi từ huấn luyện và bảng đếm bigram. Mã nguồn cũng tách sẵn tập xác thực và tập kiểm tra thành danh sách các từ theo đúng cách tương tự.
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# (2) Dùng từ điển lồng nhau để đếm các cặp từ (bigram)
# [Sao chép từ lời giải bài 2.1, bước (2)]
bigram_counts = {}
for a, b in zip(train_sequence, train_sequence[1:]):
    if a not in bigram_counts:
        bigram_counts[a] = {}
    if b not in bigram_counts[a]:
        bigram_counts[a][b] = 0
    bigram_counts[a][b] += 1

print(f"distinct pairs: {sum(len(f) for f in bigram_counts.values())}")


# -------------------------
#  Phần mới trong bài này
# -------------------------
# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")
text: 2051910 words
vocabulary: 33277 words
distinct pairs: 618405
validation: 213886 words
test: 241211 words
Hint
Hãy cộng dồn các log-xác suất thay vì nhân trực tiếp các xác suất với nhau: tích của 200.000 xác suất là một con số quá nhỏ, vượt quá khả năng biểu diễn của số thực dấu phẩy động (floating-point underflow).
Hint
Đối với mô hình bigram, hãy kiểm tra những cặp từ xuất hiện trong tập xác thực nhưng lại có số đếm bằng 0 trong tập huấn luyện.
Điểm kiểm tra kết quả bạn cần đạt được
Mọi từ đơn lẻ trong tập xác thực đều xuất hiện trong văn bản huấn luyện, do đó mô hình unigram gán cho tất cả chúng xác suất khác 0, và đạt perplexity là 996,5. Thế nhưng có tới 46.338 cặp từ trong tập xác thực (chiếm 21,7%) chưa từng xuất hiện trong lúc huấn luyện: mỗi cặp này đều nhận xác suất bằng 0, khiến perplexity của mô hình bigram tiến ra vô cùng ().
Trên tập kiểm tra, perplexity của mô hình unigram là 941,7 — thấp hơn so với trên tập xác thực. Đây không phải là lỗi lập trình: các bài viết trong tập kiểm tra của WikiText-2 tình cờ dễ dự đoán hơn một chút. Các mô hình công bố trong các bài báo khoa học cũng cho thấy độ lệch tương tự: mô hình 5-gram Kneser-Ney đạt 219,3 trên tập kiểm tra và 233,9 trên tập xác thực (Herel & Mikolov, 2023).
unigram perplexity, validation set: 996.5

validation pairs never seen in training: 46338
out of 213885, or 21.7%
bigram perplexity, validation set: inf

unigram perplexity, test set: 941.7
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# (2) Dùng từ điển lồng nhau để đếm các cặp từ (bigram)
# [Sao chép từ lời giải bài 2.1, bước (2)]
bigram_counts = {}
for a, b in zip(train_sequence, train_sequence[1:]):
    if a not in bigram_counts:
        bigram_counts[a] = {}
    if b not in bigram_counts[a]:
        bigram_counts[a][b] = 0
    bigram_counts[a][b] += 1

print(f"distinct pairs: {sum(len(f) for f in bigram_counts.values())}")


# -------------------------
#  Phần mới trong bài này
# -------------------------
# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")
text: 2051910 words
vocabulary: 33277 words
distinct pairs: 618405
validation: 213886 words
test: 241211 words
# (1) Đếm số lần xuất hiện của từng từ trong chuỗi huấn luyện
unigram_counts = {}
for word in train_sequence:
    if word not in unigram_counts:
        unigram_counts[word] = 0
    unigram_counts[word] += 1


# (2) Độ bối rối (perplexity) của mô hình unigram: hàm mũ của trừ
# trung bình log-xác suất trên các từ thuộc tập xác thực
import math

def perplexity(log_probs):
    return math.exp(-sum(log_probs) / len(log_probs))

n_train = len(train_sequence)
log_probs = []
for word in val_sequence:
    log_probs.append(math.log(unigram_counts[word] / n_train))

print(f"unigram perplexity, validation set: "
      f"{perplexity(log_probs):.1f}")


# (3) Độ bối rối của mô hình bigram. Một cặp từ chưa từng gặp khi
# huấn luyện sẽ có xác suất bằng 0, và log(0) bằng âm vô cùng.
follower_totals = {}
for a in bigram_counts:
    follower_totals[a] = sum(bigram_counts[a].values())

log_probs = []
unseen_pairs = 0
for a, b in zip(val_sequence, val_sequence[1:]):
    count = bigram_counts[a].get(b, 0)
    if count == 0:
        unseen_pairs += 1
        log_probs.append(-math.inf)
    else:
        log_probs.append(math.log(count / follower_totals[a]))

n_pairs = len(log_probs)
print(f"\nvalidation pairs never seen in training: {unseen_pairs}")
print(f"out of {n_pairs}, or {100 * unseen_pairs / n_pairs:.1f}%")
print(f"bigram perplexity, validation set: {perplexity(log_probs)}")


# (4) Độ bối rối của mô hình unigram trên tập kiểm tra (test)
log_probs = []
for word in test_sequence:
    log_probs.append(math.log(unigram_counts[word] / n_train))

test_perplexity = perplexity(log_probs)
print(f"\nunigram perplexity, test set: {test_perplexity:.1f}")
unigram perplexity, validation set: 996.5

validation pairs never seen in training: 46338
out of 213885, or 21.7%
bigram perplexity, validation set: inf

unigram perplexity, test set: 941.7
Chỉ cần nắm được tần suất xuất hiện của từng từ, mô hình unigram đã thu hẹp phạm vi phân vân xuống còn khoảng 1.000 từ, thay vì 33.277 từ như khi đoán mò đồng đều. Đáng lẽ mô hình bigram phải làm tốt hơn nhiều vì biết thêm từ đứng liền trước, nhưng cứ năm cặp từ trong tập xác thực lại có một cặp chưa từng xuất hiện trong tập huấn luyện. Chỉ cần một xác suất bằng 0 duy nhất cũng đủ đẩy perplexity lên vô cùng!
2.3 Lời nguyền số chiều (Curse of dimensionality)
Hiện tượng số đếm bằng 0 xảy ra cực kỳ nhanh khi làm việc với các từ trích từ kho ngữ liệu huấn luyện. Với bộ từ vựng 33.000 từ, có khoảng 1,1 tỷ cặp từ khả dĩ, nhưng một văn bản huấn luyện dài 2 triệu từ thì tối đa cũng chỉ chứa được 2 triệu cặp (trong bài tập 2.1 chúng ta chỉ thu được khoảng 618.000 cặp từ phân biệt, tức vỏn vẹn 0,06%). Các tổ hợp từ chưa từng thấy đã xuất hiện dày đặc trên văn bản kiểm tra ngay từ hoặc . Đây chính là một biểu hiện điển hình của lời nguyền số chiều (curse of dimensionality): số lượng ngữ cảnh khả dĩ tăng theo hàm mũ , trong khi kích thước văn bản huấn luyện lại giữ nguyên.
Bài tập 2.3a Đếm n-gram với n từ 1 đến 5
Hãy mở rộng bộ đếm ở bài tập 2.1 cho đến , sử dụng từ điển lồng nhau có khóa (key) là bộ tuple gồm từ đứng trước. Hãy sinh một đoạn văn bản mẫu ứng với mỗi giá trị . Sau đó, với mỗi , hãy đo tỷ lệ các n-gram trong tập xác thực chưa từng xuất hiện trong tập huấn luyện.
Đoạn mã khởi đầu xây dựng chuỗi huấn luyện theo bước (1) trong lời giải bài tập 2.1, cùng các chuỗi xác thực và kiểm tra giống như ở bài tập 2.2.
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
# [Sao chép từ mã khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words
Hint
Với , ngữ cảnh là một tuple rỗng (). Bảng đếm cho đến sẽ tiêu tốn khoảng 1,5 GB bộ nhớ RAM.
Hint
Khi sinh văn bản, những từ đầu tiên sẽ có ít hơn từ đứng trước chúng: hãy dùng bảng đếm của giá trị nhỏ hơn tương ứng cho những vị trí đầu này.
Điểm kiểm tra kết quả bạn cần đạt được
Tỷ lệ n-gram trong tập xác thực chưa từng xuất hiện trong tập huấn luyện tăng vọt từ 0% ở (mọi từ đơn đều nằm trong từ vựng nhờ token <unk>) lên 21,7% ở và tới 95,2% ở . Các đoạn văn bản mẫu sinh ra của bạn sẽ khác nhau, trừ khi bạn dùng cùng hạt giống ngẫu nhiên (seed) và cùng từ bắt đầu.
n = 1: The island Several was a three with Coast and at 500 Stefani five game expressed 15 is oxidation Abd Beginning digital and continuing F closed down . that built weekly

n = 2: The institute . " and long , Mortimer Wheeler secured by worry over the Song military officer notable example of willows along the Richmond Chamber of the opening sequence stars

n = 3: The institute is part of the river also served as the negative critical reviews , but the studio floor were often built in 1858 on the south of Romani marked

n = 4: The institute is part of the first stone of the original route of Highway 36 was first assumed by the Department of Highways were accused of cowardice by fellow officers

n = 5: The institute is part of Florida Atlantic 's Department of Ocean Engineering which was founded in 1870 . By 20 April 1914 , when the residents passed Act to <unk>

n = 1: 0.0% never seen
n = 2: 21.7% never seen
n = 3: 60.8% never seen
n = 4: 85.8% never seen
n = 5: 95.2% never seen
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
# [Sao chép từ mã khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words
# (1) Với mỗi n, đếm các n-gram trong một từ điển lồng nhau:
# counts[n][context][word] là số lần `word` xuất hiện ngay sau
# `context` (tuple gồm n - 1 từ đứng trước nó).
# Với n = 1, ngữ cảnh là tuple rỗng ().
counts = {}
for n in range(1, 6):
    counts[n] = {}
    for i in range(n - 1, len(train_sequence)):
        context = tuple(train_sequence[i - n + 1:i])
        word = train_sequence[i]
        if context not in counts[n]:
            counts[n][context] = {}
        if word not in counts[n][context]:
            counts[n][context][word] = 0
        counts[n][context][word] += 1


# (2) Sinh 30 từ với mỗi giá trị n, bắt đầu bằng từ "The"
import random

first_word = "The"
length = 30

for n in range(1, 6):
    random.seed(0)
    sample_words = [first_word]
    while len(sample_words) < length:
        # Lấy n - 1 từ cuối, hoặc ít hơn ở những từ đầu tiên
        if n == 1:
            context = ()
        else:
            context = tuple(sample_words[-(n - 1):])
        followers = counts[len(context) + 1][context]
        options, weights = list(followers), list(followers.values())
        next_word = random.choices(options, weights)[0]
        sample_words.append(next_word)
    print(f"n = {n}: " + " ".join(sample_words) + "\n")


# (3) Với mỗi n, tính tỷ lệ n-gram trong chuỗi xác thực
# chưa từng xuất hiện khi huấn luyện
for n in range(1, 6):
    unseen = 0
    total = 0
    for i in range(n - 1, len(val_sequence)):
        context = tuple(val_sequence[i - n + 1:i])
        word = val_sequence[i]
        if context not in counts[n] or word not in counts[n][context]:
            unseen += 1
        total += 1
    print(f"n = {n}: {100 * unseen / total:.1f}% never seen")
n = 1: The island Several was a three with Coast and at 500 Stefani five game expressed 15 is oxidation Abd Beginning digital and continuing F closed down . that built weekly

n = 2: The institute . " and long , Mortimer Wheeler secured by worry over the Song military officer notable example of willows along the Richmond Chamber of the opening sequence stars

n = 3: The institute is part of the river also served as the negative critical reviews , but the studio floor were often built in 1858 on the south of Romani marked

n = 4: The institute is part of the first stone of the original route of Highway 36 was first assumed by the Department of Highways were accused of cowardice by fellow officers

n = 5: The institute is part of Florida Atlantic 's Department of Ocean Engineering which was founded in 1870 . By 20 April 1914 , when the residents passed Act to <unk>

n = 1: 0.0% never seen
n = 2: 21.7% never seen
n = 3: 60.8% never seen
n = 4: 85.8% never seen
n = 5: 95.2% never seen
Khi tăng lên, các đoạn văn bản sinh ra ngày càng dễ đọc hơn, và đến thì chúng trông gần như những câu văn thực thụ. Nhưng đừng để vẻ ngoài đó đánh lừa: 95% số 5-gram của tập xác thực chưa từng xuất hiện trong tập huấn luyện, đồng nghĩa với việc hầu hết các ngữ cảnh 4 từ trong tập huấn luyện chỉ xuất hiện đúng một lần và mô hình 5-gram hiếm khi có nhiều hơn một lựa chọn tiếp theo. Thực chất, nó đang sao chép nguyên văn từng đoạn dài từ văn bản huấn luyện (dài từ 12 đến 30 từ trong mẫu của chúng ta), và chỉ nhảy từ đoạn này sang đoạn khác khi hai đoạn tình cờ có chung một cụm 4 từ. Mô hình 5-gram viết có vẻ hay chỉ vì nó học thuộc lòng văn bản huấn luyện.
Có một số phương pháp giúp tránh tình trạng perplexity tiến ra vô cùng do các xác suất bằng 0 gây ra bởi lời nguyền số chiều:
- Làm mượt (Smoothing): gán cho các chuỗi chưa từng xuất hiện một xác suất nhỏ khác 0. Cách đơn giản nhất là làm mượt cộng một (add-one smoothing / Laplace smoothing) — cộng thêm 1 vào mọi ô đếm — nhưng cách này hoạt động rất tệ với dữ liệu từ vựng: nó san sẻ quá nhiều tổng xác suất cho hàng tỷ cặp từ chưa từng xuất hiện.
- Nội suy (Interpolation) cho kết quả tốt hơn hẳn: phương pháp này pha trộn ước lượng xác suất của n-gram với ước lượng của -gram theo một trọng số được tinh chỉnh trên tập xác thực. Công thức ước lượng được áp dụng đệ quy từng bước lùi dần về đến tận unigram; và vì xác suất unigram luôn khác 0 với mọi từ trong từ vựng, xác suất pha trộn cuối cùng sẽ không bao giờ bằng 0.
- Nhiều kỹ thuật tinh vi hơn đã được phát triển sau đó, tiêu biểu là phương pháp Kneser-Ney dưới đây — vốn giữ ngôi vị tối tân (state-of-the-art) suốt một thời gian dài.
Đọc thêm Backoff và Kneser-Ney: kỹ thuật làm mượt tốt nhất của kỷ nguyên đếm từ
Nhiều biến thể làm mượt khác đã nối tiếp ra đời, chẳng hạn như backoff (Katz, 1987) — chỉ lùi về dùng ước lượng -gram khi và chỉ khi cụm n-gram hoàn toàn chưa từng xuất hiện. Phương pháp xuất sắc nhất trong số đó, theo nghiên cứu đối chiếu quy mô lớn của Chen và Goodman (Chen & Goodman, 1999), là làm mượt Kneser-Ney (Kneser-Ney smoothing). Bí quyết của nó nằm ở cách xử lý các ngữ cảnh ngắn hơn: thay vì gán xác suất cho một từ dựa trên tổng số lần từ đó xuất hiện, Kneser-Ney gán xác suất dựa trên sự đa dạng của các từ có thể đứng ngay trước nó (hãy nghĩ đến từ “Francisco”: xuất hiện rất nhiều lần trong văn bản, nhưng hầu như chỉ đi sau duy nhất từ “San”). Suốt nhiều năm trời, Kneser-Ney chính là cột mốc cơ sở (baseline) sừng sững mà các mô hình ngôn ngữ mạng nơ-ron phải nỗ lực vượt qua.
Kỹ thuật làm mượt giải quyết bài toán các chuỗi từ mới được ghép từ những từ đã biết. Còn bản thân các từ mới chưa từng gặp (unseen words / out-of-vocabulary) lại là một vấn đề khác, vốn đã được WikiText-2 che giấu đi bằng cách thay thế toàn bộ các từ hiếm bằng token <unk>. Đây là lần đầu tiên chúng ta chạm trán với bài toán từ vựng: vấn đề này sẽ quay lại ở mục 3.2, và các bộ tách từ (tokenizers) — chủ đề của bài viết tiếp theo — sẽ giải quyết triệt để nó.
Bài tập 2.3b★ Làm mượt các mô hình n-gram
Với các bảng đếm từ bài tập 2.3a, hãy tính perplexity của các mô hình n-gram trên tập xác thực với đến , sử dụng phương pháp làm mượt cộng một (add-one smoothing) và phương pháp nội suy (interpolation). Hãy tinh chỉnh các trọng số nội suy trên tập xác thực, và vẽ biểu đồ perplexity theo . Sau đó, hãy tính perplexity trên tập kiểm tra của mô hình 5-gram nội suy.
Đoạn mã khởi đầu xây dựng ba chuỗi văn bản như ở bài tập 2.1 và 2.2, sau đó tạo các bảng đếm cho đến theo bước (1) trong lời giải bài tập 2.3a: counts[n][context][word].
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
# [Sao chép từ mã khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")


# (1) Với mỗi n, đếm các n-gram trong một từ điển lồng nhau:
# counts[n][context][word] là số lần `word` xuất hiện ngay sau
# `context` (tuple gồm n - 1 từ đứng trước nó).
# Với n = 1, ngữ cảnh là tuple rỗng ().
# [Sao chép từ lời giải bài 2.3a, bước (1)]
counts = {}
for n in range(1, 6):
    counts[n] = {}
    for i in range(n - 1, len(train_sequence)):
        context = tuple(train_sequence[i - n + 1:i])
        word = train_sequence[i]
        if context not in counts[n]:
            counts[n][context] = {}
        if word not in counts[n][context]:
            counts[n][context][word] = 0
        counts[n][context][word] += 1
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words
Hint
Hãy tính toán với log-xác suất giống như ở bài tập 2.2. Rất nhiều n-gram trong tập xác thực không nằm trong từ điển đếm: hãy tra cứu chúng bằng phương thức .get() để trả về giá trị mặc định khi khóa không tồn tại. Với làm mượt cộng một, số đếm của mọi n-gram khả dĩ đều tăng thêm 1, do đó tổng số đếm ở mẫu số của mỗi ngữ cảnh sẽ tăng thêm một lượng bằng đúng (kích thước bộ từ vựng).
Hint
Đối với phương pháp nội suy, hãy bắt đầu với hai bậc và một trọng số duy nhất : , trong đó và là xác suất tính từ bảng đếm bigram và unigram. Tinh chỉnh bằng cách tìm kiếm lưới (grid search) trên tập xác thực. Sau đó, lần lượt thêm từng bậc cao hơn vào, mỗi bậc đi kèm một trọng số riêng. Khi gặp một ngữ cảnh chưa từng xuất hiện trong tập huấn luyện, hãy bỏ qua bậc tương ứng của ngữ cảnh đó.
Hint
Để thử nghiệm nhanh nhiều bộ trọng số, với mỗi từ trong tập xác thực và mỗi giá trị , hãy tính sẵn một lần số đếm của cụm n-gram kết thúc bằng từ đó cùng tổng số đếm của ngữ cảnh đứng trước nó. Khi đó, việc tính perplexity cho một bộ trọng số bất kỳ chỉ còn là vài phép tính mảng vector đơn giản.
Điểm kiểm tra kết quả bạn cần đạt được
Với làm mượt cộng một, perplexity trên tập xác thực lại tăng vọt theo , từ 999,1 ở lên tới 31.024,1 ở . Ngược lại, với phương pháp nội suy, perplexity giảm mạnh từ 996,5 ở xuống còn 296,2 ở , và mô hình 5-gram nội suy đạt perplexity trên tập kiểm tra là 277,7. Biểu đồ trong lời giải thể hiện đầy đủ tất cả các giá trị này.
n = 1: add-one perplexity 999.1
n = 2: add-one perplexity 2207.8
n = 3: add-one perplexity 13327.0
n = 4: add-one perplexity 26020.8
n = 5: add-one perplexity 31024.1

n = 2: weight 0.68, interpolated perplexity 345.5
n = 3: weight 0.23, interpolated perplexity 303.7
n = 4: weight 0.11, interpolated perplexity 297.3
n = 5: weight 0.09, interpolated perplexity 296.2

test perplexity, n = 5: 277.7
Lời giải 3 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
# [Sao chép từ mã khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")


# (1) Với mỗi n, đếm các n-gram trong một từ điển lồng nhau:
# counts[n][context][word] là số lần `word` xuất hiện ngay sau
# `context` (tuple gồm n - 1 từ đứng trước nó).
# Với n = 1, ngữ cảnh là tuple rỗng ().
# [Sao chép từ lời giải bài 2.3a, bước (1)]
counts = {}
for n in range(1, 6):
    counts[n] = {}
    for i in range(n - 1, len(train_sequence)):
        context = tuple(train_sequence[i - n + 1:i])
        word = train_sequence[i]
        if context not in counts[n]:
            counts[n][context] = {}
        if word not in counts[n][context]:
            counts[n][context][word] = 0
        counts[n][context][word] += 1
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words
# (1) Với mỗi từ trong chuỗi và mỗi n, tra cứu hai số đếm từ tập
# huấn luyện: số lần xuất hiện của n-gram kết thúc tại từ đó, và
# số lần xuất hiện của ngữ cảnh. Bắt đầu từ từ thứ 5 để mọi từ
# đều có đủ 4 từ đứng trước. Lưu kết quả vào mảng numpy.
import numpy as np

context_totals = {}
for n in range(1, 6):
    context_totals[n] = {}
    for context in counts[n]:
        context_totals[n][context] = sum(counts[n][context].values())

def lookup_counts(sequence):
    ngram_count = {}
    context_count = {}
    for n in range(1, 6):
        ngram_list = []
        context_list = []
        for i in range(4, len(sequence)):
            context = tuple(sequence[i - n + 1:i])
            followers = counts[n].get(context, {})
            ngram_list.append(followers.get(sequence[i], 0))
            context_list.append(context_totals[n].get(context, 0))
        ngram_count[n] = np.array(ngram_list)
        context_count[n] = np.array(context_list)
    return ngram_count, context_count

val_ngram, val_context = lookup_counts(val_sequence)

def perplexity(probs):
    return np.exp(-np.mean(np.log(probs)))


# (2) Làm mịn cộng một (add-one): cộng 1 vào số đếm của mọi
# n-gram khả dĩ, nên tổng số đếm của mỗi ngữ cảnh tăng thêm V
# (kích thước từ vựng)
V = len(set(train_sequence))
add_one = []
for n in range(1, 6):
    probs = (val_ngram[n] + 1) / (val_context[n] + V)
    add_one.append(perplexity(probs))
    print(f"n = {n}: add-one perplexity {add_one[-1]:.1f}")


# (3) Nội suy: q_n = w * p_n + (1 - w) * q_(n-1), trong đó p_n
# là xác suất tính từ số đếm n-gram. Khi ngữ cảnh chưa từng gặp
# trong tập huấn luyện, đặt q_n = q_(n-1).
def interpolate(ngram_count, context_count, weights):
    q = ngram_count[1] / context_count[1]   # n = 1
    for n in range(2, len(weights) + 2):
        w = weights[n - 2]   # weights[0] là trọng số của n = 2
        seen = context_count[n] > 0
        p = np.zeros(len(q))
        p[seen] = ngram_count[n][seen] / context_count[n][seen]
        q = np.where(seen, w * p + (1 - w) * q, q)
    return q

# Tinh chỉnh lần lượt trọng số của từng n bằng tìm kiếm lưới
weights = []
interpolation = [perplexity(interpolate(val_ngram, val_context, []))]
print()
for n in range(2, 6):
    best_w, best_perplexity = 0, np.inf
    for k in range(1, 100):
        w = k / 100
        q = interpolate(val_ngram, val_context, weights + [w])
        if perplexity(q) < best_perplexity:
            best_w, best_perplexity = w, perplexity(q)
    weights.append(best_w)
    interpolation.append(best_perplexity)
    print(f"n = {n}: weight {best_w}, "
          f"interpolated perplexity {best_perplexity:.1f}")


# (4) Độ bối rối trên tập kiểm tra của mô hình 5-gram nội suy
test_ngram, test_context = lookup_counts(test_sequence)
q = interpolate(test_ngram, test_context, weights)
test_perplexity = perplexity(q)
print(f"\ntest perplexity, n = 5: {test_perplexity:.1f}")
n = 1: add-one perplexity 999.1
n = 2: add-one perplexity 2207.8
n = 3: add-one perplexity 13327.0
n = 4: add-one perplexity 26020.8
n = 5: add-one perplexity 31024.1

n = 2: weight 0.68, interpolated perplexity 345.5
n = 3: weight 0.23, interpolated perplexity 303.7
n = 4: weight 0.11, interpolated perplexity 297.3
n = 5: weight 0.09, interpolated perplexity 296.2

test perplexity, n = 5: 277.7
import matplotlib.pyplot as plt

orders = [1, 2, 3, 4, 5]
plt.figure(figsize=(5, 3.5))
plt.plot(orders, add_one, "o-", label="add-one")
plt.plot(orders, interpolation, "o-", label="interpolation")
plt.yscale("log")
plt.xticks(orders)
plt.xlabel("n")
plt.ylabel("validation perplexity")
plt.legend()
plt.show()
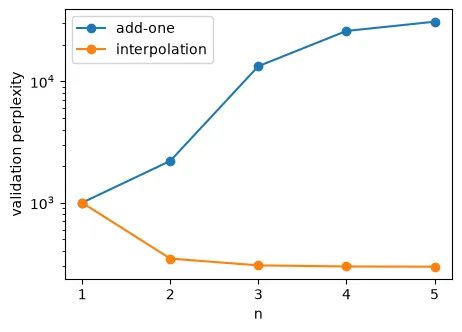
Làm mượt cộng một thực sự là một thảm họa: ở , perplexity của nó lên tới 31.024, hầu như chẳng khá hơn việc đoán mò đồng đều trên toàn bộ 33.277 từ! Phương pháp nội suy hoạt động tốt hơn nhiều, nhưng hãy nhìn vào biểu đồ: gần như toàn bộ mức cải thiện đều đến từ bước nhảy , còn việc tăng từ lên chỉ giúp giảm perplexity từ 346 xuống 296. Các trọng số sau khi tinh chỉnh cũng phản ánh đúng điều đó: trọng số dành cho bigram là 0,68, nhưng trọng số dành cho 5-gram chỉ vỏn vẹn 0,09. Ngữ cảnh dài hơn đáng lẽ phải giúp ích rất nhiều, nhưng với phương pháp đếm thuần túy, chúng ta hầu như không thể khai thác được chúng.
Nếu bạn muốn đào sâu hơn, dưới đây là một số bài tập mở rộng.
Làm mượt Kneser-Ney. Hãy tự cài đặt thuật toán này và so sánh nó với phương pháp nội suy. Kết quả của nó tiến gần đến mức nào so với các mô hình mạng nơ-ron ở các phần tiếp theo? Để tham khảo, một mô hình 5-gram Kneser-Ney đạt perplexity trên tập kiểm tra là 219 trên bộ dữ liệu WikiText-2 (Herel & Mikolov, 2023).
Ký tự thay vì từ. Hãy huấn luyện các mô hình n-gram cấp độ ký tự trên tập dữ liệu TinyShakespeare (jchwenger/tiny_shakespeare, nạp với tham số sample_by="document"), với đến . Ở giá trị nào thì các n-gram chưa từng thấy bắt đầu xuất hiện? Ở giá trị nào thì văn bản sinh ra bắt đầu đọc được? Lưu ý rằng không thể so sánh trực tiếp perplexity của chúng với perplexity của mô hình cấp độ từ, vì đơn vị đo lường cơ sở không giống nhau (xem khung giải thích ở mục 7.3).
Albert hay Alfred? Hãy dùng các mô hình bạn vừa xây dựng để chấm điểm hai câu “General relativity was formulated by Albert Einstein” và “General relativity was formulated by Alfred Einstein” (ví dụ ở mục 1.2). Cần đến bậc bằng bao nhiêu để mô hình ưu tiên chọn Albert?
Trật tự từ. Hãy so sánh perplexity của một vài câu văn bình thường với chính những câu văn đó sau khi đã xáo trộn ngẫu nhiên thứ tự các từ.
Bộ nhớ. Với mỗi giá trị , mô hình phải lưu trữ bao nhiêu n-gram phân biệt trong bộ nhớ?
3. Phân loại văn bản với Túi từ (Bag of Words)
Bây giờ, chúng ta hãy tạm gác lại bài toán mô hình hóa ngôn ngữ để chuyển sang tác vụ trọng tâm thứ hai của bài viết: phân loại các bài đánh giá phim thành tích cực (positive) hoặc tiêu cực (negative).
3.1 Khuôn mẫu chung: Bộ mã hóa (Encoder) → Biểu diễn kích thước cố định → Đầu phân loại (Head)
Trong một bài toán phân loại, chẳng hạn như phân tích cảm xúc của các bài đánh giá phim, văn bản đầu vào luôn có độ dài biến thiên. Và chúng ta không thể dùng lại mẹo đã áp dụng cho mô hình ngôn ngữ Markov — tức là chỉ giữ lại từ cuối cùng. Thật vậy, chẳng có lý do gì để giả định rằng thông tin quan trọng nhất của cả bài đánh giá lại luôn nằm ở từ cuối cùng, nhất là khi chỉ nhỏ hơn 3 hoặc 4!
Vì tất cả các phương pháp học máy cổ điển (hồi quy logistic, mạng nơ-ron truyền thẳng, các phương pháp dựa trên cây quyết định…) đều đòi hỏi đầu vào có kích thước cố định, chúng ta cần một cơ chế để chuyển đổi một đoạn văn bản có độ dài bất kỳ thành một biểu diễn có kích thước cố định (fixed-size representation) tóm lược nội dung của văn bản đó.
Nhìn chung, một mô hình phân loại trong NLP luôn có thể tách thành hai bước: bộ mã hóa (encoder) — làm nhiệm vụ tạo ra một biểu diễn có kích thước cố định cho văn bản (đôi khi được gọi là biểu diễn tiềm ẩn — latent representation), và đầu phân loại (classification head) — nhận biểu diễn này làm đầu vào để tính ra xác suất của từng lớp.
Khuôn mẫu này được minh họa trực quan ở hình dưới đây.
Lưu ý rằng các mô hình n-gram ở mục 2 thực chất cũng tuân theo khuôn mẫu này cho bài toán mô hình hóa ngôn ngữ: bộ mã hóa giữ lại từ cuối cùng của văn bản (một biểu diễn có kích thước cố định), còn đầu dự đoán chính là bảng đếm tần số dùng để tra cứu xác suất của từ tiếp theo.
Vậy chúng ta có những lựa chọn nào để xây dựng một biểu diễn có kích thước cố định cho một bài đánh giá phim? Hãy bắt đầu với phương pháp đơn giản nhất.
3.2 Túi từ (Bag of words)
Hãy xét câu đánh giá phim sau đây:
Great acting, great lighting, and a flabbergasting soundtrack, but not even Zendaya could save this boring, boring plot. (Diễn xuất tuyệt vời, ánh sáng tuyệt vời và nhạc phim xuất sắc đến kinh ngạc, nhưng ngay cả Zendaya cũng không cứu nổi cốt truyện nhàm chán, vô cùng nhàm chán này.)
Chúng ta có thể đơn giản đếm số lần xuất hiện của từng từ trong câu.
| Word | Count | Word | Count | Word | Count | Word | Count |
|---|---|---|---|---|---|---|---|
| a | 1 | but | 1 | great | 2 | save | 1 |
| acting | 1 | could | 1 | lighting | 1 | soundtrack | 1 |
| and | 1 | even | 1 | not | 1 | this | 1 |
| boring | 2 | flabbergasting | 1 | plot | 1 | Zendaya | 1 |
Ta chưa thể dùng trực tiếp bảng này làm biểu diễn đầu vào cho mô hình được, bởi kích thước của bảng (cũng như các từ bên trong nó) sẽ thay đổi tùy theo từng bài đánh giá. Giải pháp là chọn trước một bộ từ vựng gồm từ, chẳng hạn như từ xuất hiện phổ biến nhất trong tập các bài đánh giá huấn luyện. Khi đó, mỗi bài đánh giá sẽ trở thành một vector có kích thước , trong đó phần tử thứ chính là số lần xuất hiện của từ thứ (trong bộ từ vựng) ở bài đánh giá đang xét.
Hầu hết các phần tử của vector này đều bằng 0: một bài đánh giá IMDB trung vị chỉ dài khoảng 178 từ, trong khi bộ từ vựng chứa tới hàng nghìn từ. Đây là một vector thưa (sparse vector). Bạn cũng có thể hiểu vector này như tổng của các vector one-hot của từng từ xuất hiện trong bài đánh giá — tổng này luôn có cùng kích thước bất kể bài đánh giá dài hay ngắn. Vậy là chúng ta đã có được biểu diễn kích thước cố định, sẵn sàng đưa vào bất kỳ bộ phân loại cổ điển nào.
Cách biểu diễn này được gọi là túi từ (bag of words — BoW): cứ như thể chúng ta cắt rời bài đánh giá thành từng từ lẻ rồi trút tất cả vào chung một chiếc túi. Chúng ta biết chính xác mỗi từ xuất hiện bao nhiêu lần, nhưng đã đánh mất hoàn toàn trật tự xuất hiện của chúng (hãy ghi nhớ chi tiết này, chúng ta sẽ sớm quay lại với nó).
Tất nhiên, sẽ có những từ không nằm trong bộ từ vựng đã chọn, chẳng hạn như tên riêng “Zendaya” trong ví dụ của chúng ta. Những từ này đơn giản sẽ bị bỏ qua. Với , từ “flabbergasting” (kinh ngạc) nhiều khả năng cũng sẽ bị bỏ qua: nó chỉ xuất hiện trong đúng 2 trên tổng số 25.000 bài đánh giá huấn luyện của IMDB.
Về phần đầu phân loại (head), lựa chọn đơn giản nhất là hồi quy logistic (logistic regression). Mô hình này gán một trọng số cho mỗi từ trong bộ từ vựng, rồi tính xác suất bài đánh giá mang sắc thái tích cực theo công thức:
trong đó là độ chệch (bias), và hàm sigmoid nén tổng điểm thành một giá trị xác suất nằm trong khoảng từ 0 đến 1. Nói cách khác, mỗi lần một từ xuất hiện sẽ đẩy tổng điểm tăng lên hoặc giảm xuống một lượng bằng đúng trọng số của từ đó, và mô hình sẽ kết luận là “tích cực” khi tổng điểm lớn hơn 0. Các trọng số này được học từ các bài đánh giá đã gán nhãn bằng cách cực tiểu hóa hàm mất mát entropy chéo ở mục 2.2 (với hai lớp thay vì toàn bộ từ vựng các từ tiếp theo).
Bạn có thể tương tác trực tiếp với mô hình này ở hình bên dưới: đây chính là mô hình bạn sẽ tự tay huấn luyện trong bài tập 3.2. Hãy thử chỉnh sửa nội dung bài đánh giá và quan sát vector đếm thay đổi. Để thấy rõ giới hạn của phương pháp này, hãy thử viết một câu chê bai thậm tệ nhưng vẫn bị mô hình phân loại nhầm thành tích cực, chẳng hạn bằng cách dùng giọng điệu mỉa mai.
Hãy cùng huấn luyện một mô hình như vậy trên bộ dữ liệu IMDB.
Đọc thêm Đừng quên hiện tượng quá khớp (overfitting)
Hãy nhớ rằng với 10.000 trọng số được học trên 20.000 bài đánh giá, mô hình rất dễ bị quá khớp (overfit): nó có thể tìm ra bộ trọng số khớp hoàn hảo với các bài đánh giá huấn luyện — bao gồm cả nhiễu ngẫu nhiên — và dẫn đến khả năng khái quát hóa kém trên dữ liệu mới. Đó là lý do vì sao hồi quy logistic thường đi kèm với điều chuẩn (regularization): một lượng phạt tỷ lệ thuận với tổng bình phương các trọng số (điều chuẩn ) được cộng thêm vào hàm mất mát nhằm giữ cho các trọng số không phình quá lớn. Trong thư viện scikit-learn, tham số C là nghịch đảo của cường độ điều chuẩn: C càng nhỏ thì lực phạt càng mạnh và các trọng số càng bị ép nhỏ lại. Giống như cách ta đã làm với trọng số nội suy ở mục 2.3, chúng ta sẽ chọn giá trị C dựa trên một tập xác thực, ở đây là 5.000 bài đánh giá được tách ra từ tập huấn luyện.
Bài tập 3.2 Phân loại đánh giá phim IMDB bằng túi từ
Hãy biểu diễn mỗi bài đánh giá bằng vector đếm trên 10.000 từ phổ biến nhất của tập huấn luyện, và huấn luyện một mô hình hồi quy logistic trên các vector này. Giữ riêng 5.000 bài đánh giá huấn luyện làm tập xác thực và dùng nó để chọn tham số điều chuẩn C. Sau đó, hãy đo độ chính xác trên tập kiểm tra (test accuracy), đồng thời in ra 10 từ có trọng số dương lớn nhất và 10 từ có trọng số âm lớn nhất.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")

example = imdb["train"][0]
print(f"label {example['label']} (0 = negative, 1 = positive)")
print(example["text"][:70])
label 0 (0 = negative, 1 = positive)
I rented I AM CURIOUS-YELLOW from my video store because of all the co
Hint
Các bài đánh giá có chứa thẻ ngắt dòng HTML <br />: hãy thay thế chúng bằng khoảng trắng. Để tạo tập xác thực, hãy sử dụng phương thức train_test_split(test_size=5000, seed=0) trên tập huấn luyện. Đừng chỉ cắt lấy 5.000 bài đánh giá cuối cùng: các bài đánh giá trong tập huấn luyện gốc được sắp xếp theo nhãn!
Hint
Lớp CountVectorizer(max_features=10000) của scikit-learn sẽ xây dựng bộ từ vựng gồm các từ phổ biến nhất từ những văn bản bạn truyền vào phương thức fit_transform, đồng thời trả về các vector đếm tương ứng. Sau đó, phương thức transform sẽ dùng bộ từ vựng cố định này để đếm từ cho bất kỳ văn bản nào khác. Mặc định, công cụ này bỏ qua các từ chỉ có một chữ cái (như chữ “a”): hãy truyền tham số token_pattern=r"\b\w+\b" để giữ lại chúng. Các vector được lưu trữ dưới dạng ma trận thưa (sparse matrices), chỉ lưu các phần tử khác 0 nhằm tiết kiệm bộ nhớ.
Hint
Hãy sử dụng LogisticRegression(C=C, max_iter=1000) từ scikit-learn, và thử các giá trị C = 0.01, 0.03, 0.1, 0.3, 1, 3 và 10. Sau khi mô hình được huấn luyện xong, thuộc tính model.coef_[0] sẽ chứa mảng trọng số của các từ, theo đúng thứ tự từ vựng trả về bởi vectorizer.get_feature_names_out().
Điểm kiểm tra kết quả bạn cần đạt được
Giá trị tốt nhất là C = 0.1 với độ chính xác trên tập xác thực đạt 88,9%, và độ chính xác trên tập kiểm tra đạt 87,6%. Những từ mang trọng số tiêu cực mạnh nhất bao gồm “worst”, “waste” và “awful”; còn những từ tích cực nhất gồm có “perfect”, “excellent” và “superb”. Nếu bạn tách từ theo quy tắc hơi khác một chút, các con số và danh sách từ của bạn có thể xê dịch đôi chút.
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews

C = 0.01: validation accuracy 0.883
C = 0.03: validation accuracy 0.887
C = 0.1: validation accuracy 0.889
C = 0.3: validation accuracy 0.886
C = 1: validation accuracy 0.875
C = 3: validation accuracy 0.870
C = 10: validation accuracy 0.862

test accuracy, C = 0.1: 0.876

negative: worst waste disappointment awful poorly boring lacks fails avoid mess
positive: 7 8 perfect excellent refreshing wonderfully superb amazing favorite rare
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")

example = imdb["train"][0]
print(f"label {example['label']} (0 = negative, 1 = positive)")
print(example["text"][:70])
label 0 (0 = negative, 1 = positive)
I rented I AM CURIOUS-YELLOW from my video store because of all the co
# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ trong mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Biểu thức chính quy coi mọi chuỗi chữ cái
# hoặc chữ số là một từ, kể cả từ chỉ gồm một chữ cái như "a".
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# (3) Huấn luyện hồi quy logistic với nhiều giá trị C (nghịch đảo
# cường độ điều chuẩn) và giữ lại mô hình tốt nhất trên tập xác thực
from sklearn.linear_model import LogisticRegression

print()
best_accuracy = 0
for C in [0.01, 0.03, 0.1, 0.3, 1, 3, 10]:
    model = LogisticRegression(C=C, max_iter=1000)
    model.fit(X_train, train_labels)
    accuracy = model.score(X_val, val_labels)
    print(f"C = {C}: validation accuracy {accuracy:.3f}")
    if accuracy > best_accuracy:
        best_accuracy, best_C, best_model = accuracy, C, model


# (4) Đo độ chính xác trên tập kiểm tra của mô hình tốt nhất
test_accuracy = best_model.score(X_test, test_labels)
print(f"\ntest accuracy, C = {best_C}: {test_accuracy:.3f}")


# (5) In ra các từ có trọng số lớn nhất nghiêng về tiêu cực và
# tích cực. np.argsort sắp xếp các trọng số theo thứ tự tăng dần
# và trả về chỉ số vị trí của chúng.
import numpy as np

words = vectorizer.get_feature_names_out()
weights = best_model.coef_[0]   # mỗi từ một trọng số
order = np.argsort(weights)
most_negative = [words[i] for i in order[:10]]
most_positive = [words[i] for i in order[-10:]]
most_positive.reverse()
print("\nnegative:", " ".join(most_negative))
print("positive:", " ".join(most_positive))
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews

C = 0.01: validation accuracy 0.883
C = 0.03: validation accuracy 0.887
C = 0.1: validation accuracy 0.889
C = 0.3: validation accuracy 0.886
C = 1: validation accuracy 0.875
C = 3: validation accuracy 0.870
C = 10: validation accuracy 0.862

test accuracy, C = 0.1: 0.876

negative: worst waste disappointment awful poorly boring lacks fails avoid mess
positive: 7 8 perfect excellent refreshing wonderfully superb amazing favorite rare
Dù hoàn toàn mù tịt về trật tự từ trong câu, mô hình túi từ vẫn phân loại đúng tới 87,6% các bài đánh giá trong tập kiểm tra! Hơn nữa, các trọng số của nó cực kỳ dễ diễn giải: mô hình đã tự động trích xuất từ dữ liệu một danh sách các từ khen và chê của riêng mình. Nhưng hãy nhìn kỹ vào hai “từ” mang trọng số tích cực lớn nhất: con số “7” và “8”. Chúng chẳng phải là từ chỉ cảm xúc, mà là điểm số chấm phim: rất nhiều người viết kết thúc bài đánh giá bằng cụm “7/10” hoặc “8/10”, và mô hình đã tự tìm ra lối tắt (shortcut) này. Mô hình không hề hiểu nội dung bài đánh giá: nó chỉ đơn thuần đếm những từ thường hay đi kèm với từng nhãn.
Việc để máy tự học trọng số của các từ từ dữ liệu hiệu quả hơn gấp bội so với việc con người tự chọn từ thủ công, và đây chính là một trong những bài học đầu tiên của bài toán phân loại cảm xúc bằng học máy.
3.3 Đánh trọng số TF-IDF (TF-IDF weighting)
Trong ví dụ vừa rồi, những từ như “a” hay “and” chắc chắn không mang lại nhiều thông tin phân loại, bởi chúng xuất hiện ở khắp mọi nơi: từ “the” có mặt trong 99% số bài đánh giá huấn luyện của IMDB, còn “a” và “and” xuất hiện trong 97% số bài. Ngược lại, từ “boring” chỉ xuất hiện trong 6% số bài đánh giá và chắc chắn mang thông tin rất có giá trị.
Một giải pháp để cải thiện biểu diễn túi từ là giảm trọng số của những từ xuất hiện ở hầu hết mọi tài liệu, đồng thời tăng trọng số cho những từ hiếm gặp hơn. Đó chính là vai trò của nghịch đảo tần suất tài liệu (inverse document frequency — IDF): nhân số lần xuất hiện của mỗi từ với của tỷ lệ các tài liệu có chứa từ đó:
trong đó là tổng số tài liệu và là số lượng tài liệu có chứa từ . Khi đó, phần tử thứ trong vector biểu diễn của một tài liệu sẽ trở thành — đó là nguồn gốc của cái tên TF-IDF, viết tắt của “term frequency times inverse document frequency” (tần suất từ nhân với nghịch đảo tần suất tài liệu). Nếu dùng logarit cơ số 2, từ “the” sẽ nhận trọng số IDF là 0,01 (gần như bằng 0), từ “boring” nhận trọng số là 4, còn từ “flabbergasting” (chỉ xuất hiện trong 2 trên 25.000 bài đánh giá) sẽ nhận trọng số lên tới 13,6.
Một biến thể đơn giản khác là chỉ giữ lại thông tin về sự hiện diện (presence) của mỗi từ: gán bằng 1 nếu từ đó có mặt trong bài đánh giá, và bằng 0 nếu không. Đây chính là cách biểu diễn cho kết quả tốt nhất trong nghiên cứu của Pang và cộng sự (xem ghi chú bên lề ở mục 3.2). Hãy cùng so sánh ba phương pháp đánh trọng số này trên tập dữ liệu IMDB.
Bài tập 3.3 Đánh trọng số cho các từ trong túi từ
Hãy làm lại bài tập 3.2 với hai cách đánh trọng số khác cho các từ: sự hiện diện nhị phân (có/không) và TF-IDF. Với mỗi cách đánh trọng số, hãy chọn tham số C tối ưu trên tập xác thực, sau đó so sánh độ chính xác trên tập kiểm tra của cả ba phương pháp.
Đoạn mã khởi đầu lặp lại bước (1) trong lời giải của bài tập 3.2, đảm bảo các tập huấn luyện, xác thực và kiểm tra giống hệt như ở bài tập 3.2.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
Hint
CountVectorizer(binary=True) trả về vector biểu diễn sự hiện diện của từ, còn TfidfVectorizer trả về trọng số TF-IDF. Cả hai lớp này đều nhận các tham số giống hệt như ở bài tập 3.2.
Hint
TfidfVectorizer trong scikit-learn có hai điểm khác biệt nhỏ so với công thức lý thuyết ở trên. Thứ nhất, nó dùng logarit tự nhiên và cộng thêm 1 vào giá trị idf để những từ xuất hiện trong mọi bài đánh giá không bị triệt tiêu hoàn toàn về 0. Thứ hai, nó chuẩn hóa mỗi vector bằng cách chia cho độ dài Euclid () của chính vector đó, sao cho mọi bài đánh giá đều có vector độ dài bằng 1 bất kể bài viết dài hay ngắn.
Hint
Giá trị C tốt nhất sẽ không giống nhau giữa ba phương pháp đánh trọng số, bởi các phần tử trong vector của chúng có độ lớn chênh lệch nhau rất nhiều.
Điểm kiểm tra kết quả bạn cần đạt được
Độ chính xác trên tập kiểm tra đạt 87,6% khi dùng số đếm tần số (C = 0.1), 88,2% khi dùng sự hiện diện nhị phân (C = 0.03), và 88,4% khi dùng TF-IDF (C = 3).
counts: C = 0.1, test accuracy 0.876
presence: C = 0.03, test accuracy 0.882
TF-IDF: C = 3, test accuracy 0.884
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
# (1) Ba cách gán trọng số trên 10.000 từ phổ biến nhất
# của các bài đánh giá huấn luyện
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.feature_extraction.text import TfidfVectorizer

V = 10000
pattern = r"\b\w+\b"   # mọi từ, kể cả từ chỉ gồm một chữ cái
vectorizers = {
    "counts": CountVectorizer(max_features=V, token_pattern=pattern),
    "presence": CountVectorizer(max_features=V, token_pattern=pattern,
                                binary=True),
    "TF-IDF": TfidfVectorizer(max_features=V, token_pattern=pattern),
}


# (2) Với mỗi cách gán trọng số, chọn C trên tập xác thực như ở
# bài 3.2, rồi đo độ chính xác trên tập kiểm tra của mô hình tốt nhất
from sklearn.linear_model import LogisticRegression

test_accuracies = {}
for name in vectorizers:
    vectorizer = vectorizers[name]
    X_train = vectorizer.fit_transform(train_texts)
    X_val = vectorizer.transform(val_texts)
    X_test = vectorizer.transform(test_texts)

    best_accuracy = 0
    for C in [0.01, 0.03, 0.1, 0.3, 1, 3, 10]:
        model = LogisticRegression(C=C, max_iter=1000)
        model.fit(X_train, train_labels)
        accuracy = model.score(X_val, val_labels)
        if accuracy > best_accuracy:
            best_accuracy, best_C, best_model = accuracy, C, model

    test_accuracies[name] = best_model.score(X_test, test_labels)
    print(f"{name}: C = {best_C}, "
          f"test accuracy {test_accuracies[name]:.3f}")
counts: C = 0.1, test accuracy 0.876
presence: C = 0.03, test accuracy 0.882
TF-IDF: C = 3, test accuracy 0.884
TF-IDF giành chiến thắng, nhưng cách biệt chưa tới 1 điểm phần trăm. Tại sao mức cải thiện lại ít ỏi đến vậy? Bởi vì bản thân mô hình hồi quy logistic đã tự học một trọng số riêng cho từng từ rồi! Việc nhân số đếm của một từ với một hằng số cố định (như giá trị IDF của nó) hoàn toàn có thể được bù trừ bằng cách chia trọng số học được của từ đó cho chính hằng số ấy: về mặt lý thuyết, mô hình có thể học ra cùng một hàm quyết định dù có hay không có IDF; chỉ có thành phần điều chuẩn (và bước chuẩn hóa độ dài vector) mới tạo ra một chút khác biệt nhỏ. TF-IDF sẽ phát huy vai trò lớn hơn rất nhiều khi không có trọng số nào được học cả — chẳng hạn khi đo trực tiếp độ tương đồng cosine giữa hai tài liệu, vốn chính là bài toán truy xuất thông tin của Sparck Jones và Salton. Dù đánh trọng số theo cách nào đi nữa, mô hình túi từ của chúng ta vẫn dậm chân ở dưới ngưỡng 89%.
Những con số này rất điển hình đối với mô hình túi từ trên tập dữ liệu IMDB: bài báo gốc giới thiệu bộ dữ liệu này cũng báo cáo mức 87,8% khi sử dụng đặc trưng hiện diện của từ (Maas et al., 2011). Một mô hình cơ sở (baseline) rất mạnh dựa trên túi từ của Wang và Manning từng đạt tới 91,2% (Wang & Manning, 2012). Mô hình đó bổ sung thêm cả các cặp từ liên tiếp (bigram) vào bộ từ vựng — nhờ vậy cụm “not good” trở thành một mục từ độc lập — đồng thời kết hợp bộ phân loại Naive Bayes với SVM. Việc đưa thêm các cặp từ giúp khôi phục lại một phần nhỏ thông tin về trật tự từ, và trật tự từ chính là mảnh ghép quan trọng mà mô hình túi từ đang đánh mất.
3.4 Giới hạn của phương pháp
Hãy xét hai câu đánh giá ngắn sau đây:
A: Excellent movie, awesome soundtrack. (Phim xuất sắc, nhạc phim tuyệt đỉnh.)
B: Superb film, wonderful score. (Tác phẩm điện ảnh siêu phàm, phần âm nhạc tuyệt diệu.)
Cả hai câu về cơ bản đều diễn đạt cùng một ý khen ngợi, nhưng lại sử dụng những từ hoàn toàn khác nhau. Do đó, trong không gian túi từ, chúng nhận hai vector biểu diễn hoàn toàn trực giao (vuông góc) với nhau: không có bất kỳ vị trí nào cùng khác 0 ở cả hai vector.
| excellent | movie | awesome | soundtrack | superb | film | wonderful | score | |
|---|---|---|---|---|---|---|---|---|
| A | 1 | 1 | 1 | 1 | 0 | 0 | 0 | 0 |
| B | 0 | 0 | 0 | 0 | 1 | 1 | 1 | 1 |
Đối với mô hình túi từ, từ “superb” (siêu phàm) khác biệt với từ “excellent” (xuất sắc) chẳng kém gì sự khác biệt giữa nó với từ “boring” (nhàm chán). Biểu diễn túi từ không hề hỗ trợ gì cho đầu phân loại: đầu phân loại buộc phải tự học trọng số của từng từ một cách hoàn toàn tách biệt, chỉ dựa vào những bài đánh giá đã gán nhãn có chứa chính từ đó. Với một từ phổ biến như “excellent” (xuất hiện trong 1.780 bài đánh giá huấn luyện), cách này hoạt động ổn thỏa. Thế nhưng một từ hiếm hơn như “mesmerizing” (mê hoặc — chỉ có trong 62 bài đánh giá) sẽ phải học trọng số từ vỏn vẹn vài chục ví dụ ít ỏi, còn một từ nằm ngoài bộ từ vựng như “flabbergasting” thì thậm chí chẳng có lấy một trọng số nào.
Giới hạn thứ hai nằm ngay ở tên gọi của phương pháp: túi từ quên sạch trật tự của các từ. Hai câu đánh giá dưới đây chứa các từ giống hệt nhau, dẫn đến hai vector biểu diễn giống hệt nhau, và vì thế mô hình buộc phải gán cho chúng cùng một xác suất như nhau:
A: I expected it to be terrible, but it was great. (Tôi cứ tưởng phim sẽ dở tệ, nhưng hóa ra lại rất hay.)
B: I expected it to be great, but it was terrible. (Tôi cứ tưởng phim sẽ rất hay, nhưng hóa ra lại dở tệ.)
Điều tương tự cũng xảy ra với cấu trúc phủ định. Trong cụm “not bad at all” (không tệ chút nào), mô hình chỉ nhìn thấy các từ rời rạc “not”, “bad”, “at” và “all”, trong đó từ “bad” mang trọng số âm rất nặng. Còn sự mỉa mai (sarcasm) lại càng đánh lừa mô hình thê thảm hơn, bởi người viết cố tình dùng toàn những từ tích cực để diễn đạt một ý chê bai.
Để theo dõi xem các mô hình tiếp theo vượt qua những giới hạn này như thế nào xuyên suốt bài viết, tôi đã biên soạn một tập nhỏ gồm các bài đánh giá khó (hard reviews). Chúng đều là những câu ngắn gọn mà bất kỳ độc giả con người nào cũng nhận ra ngay sắc thái khen chê. Các câu này được nhóm theo từng loại thử thách: phủ định (negation), tương phản (contrast), mỉa mai (sarcasm), trật tự từ (word order), từ đồng nghĩa (synonyms) và từ hiếm (rare words). Chúng ta sẽ cho mọi mô hình phân loại IMDB trong bài viết chạy thử trên tập câu khó này, bắt đầu ngay với mô hình túi từ vừa xây dựng.
Bài tập 3.4 Thử nghiệm mô hình túi từ trên tập đánh giá khó
Hãy chạy mô hình ở bài tập 3.2 trên 13 câu đánh giá khó có sẵn trong đoạn mã khởi đầu. Với mỗi câu đánh giá, hãy in ra nhãn thực tế và xác suất tích cực mà mô hình dự đoán. Mô hình đoán sai những câu nào, và tại sao?
Đoạn mã khởi đầu huấn luyện lại mô hình này theo bước (1) và (2) trong lời giải bài tập 3.2 với giá trị C = 0.1 đã chọn ở đó, sau đó liệt kê danh sách các câu đánh giá khó.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ trong mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Biểu thức chính quy coi mọi chuỗi chữ cái
# hoặc chữ số là một từ, kể cả từ chỉ gồm một chữ cái như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# -------------------------
#  Phần mới trong bài này
# -------------------------
# Mô hình hồi quy logistic của bài 3.2 với C = 0.1, giá trị đã
# được chọn trên tập xác thực
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(C=0.1, max_iter=1000)
model.fit(X_train, train_labels)

# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai / Châm biếm
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm gặp
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews
Hint
Phương thức model.predict_proba trả về một hàng cho mỗi câu đánh giá, chứa xác suất của hai lớp: lớp tiêu cực ở cột 0 và lớp tích cực ở cột 1.
Hint
Để hiểu lý do đằng sau một dự đoán cụ thể, hãy quan sát trọng số của từng từ trong câu đánh giá đó: bạn có thể dán câu đánh giá vào hình minh họa tương tác “Biểu diễn một bài đánh giá dưới dạng túi từ” ở mục 3.2 (hình này sử dụng chính xác cùng một mô hình).
Điểm kiểm tra kết quả bạn cần đạt được
Mô hình chỉ đoán đúng 7 trên tổng số 13 câu đánh giá khó. Hai câu đánh giá có cùng tập từ vựng nhận xác suất dự đoán giống hệt nhau đến từng chữ số thập phân: 0,495.
label     p(positive)  right  review
positive  0.335        NO     Not bad at all, actually.
negative  0.423        yes    Nothing about this movie is good.
positive  0.470        NO     I wouldn't call it a masterpiece, b…
negative  0.109        yes    Great acting, great lighting and a …
positive  0.513        yes    The first hour is slow and the dial…
negative  0.685        NO     Everyone told me it would be the fi…
negative  0.761        NO     Wow, what a masterpiece. Two hours …
negative  0.598        NO     Brilliant. Another sequel nobody as…
positive  0.495        NO     I expected it to be terrible, but i…
negative  0.495        yes    I expected it to be great, but it w…
positive  0.779        yes    Excellent movie, awesome soundtrack.
positive  0.810        yes    Superb film, wonderful score.
positive  0.521        yes    A flabbergasting, mesmerizing tour …

7 right out of 13
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ trong mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Biểu thức chính quy coi mọi chuỗi chữ cái
# hoặc chữ số là một từ, kể cả từ chỉ gồm một chữ cái như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# -------------------------
#  Phần mới trong bài này
# -------------------------
# Mô hình hồi quy logistic của bài 3.2 với C = 0.1, giá trị đã
# được chọn trên tập xác thực
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(C=0.1, max_iter=1000)
model.fit(X_train, train_labels)

# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai / Châm biếm
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm gặp
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews
# (1) Đếm các từ của những bài đánh giá khó trên từ vựng của
# mô hình, và tính xác suất để chúng thuộc lớp tích cực
hard_texts = [review for review, label in hard_reviews]
X_hard = vectorizer.transform(hard_texts)
probabilities = model.predict_proba(X_hard)
p_positive = probabilities[:, 1]   # cột 0: tiêu cực, 1: tích cực


# (2) In bảng kết quả: mô hình đoán đúng khi gán xác suất lớn hơn
# 0.5 cho nhãn thực tế của bài đánh giá
names = ["negative", "positive"]
print("label     p(positive)  right  review")
right_count = 0
for (review, label), p in zip(hard_reviews, p_positive):
    right = (p > 0.5) == (label == 1)
    if right:
        right_count += 1
    mark = "yes" if right else "NO"
    short = review if len(review) <= 36 else review[:35] + "…"
    print(f"{names[label]:9} {p:.3f}        {mark:5}  {short}")
print(f"\n{right_count} right out of {len(hard_reviews)}")
label     p(positive)  right  review
positive  0.335        NO     Not bad at all, actually.
negative  0.423        yes    Nothing about this movie is good.
positive  0.470        NO     I wouldn't call it a masterpiece, b…
negative  0.109        yes    Great acting, great lighting and a …
positive  0.513        yes    The first hour is slow and the dial…
negative  0.685        NO     Everyone told me it would be the fi…
negative  0.761        NO     Wow, what a masterpiece. Two hours …
negative  0.598        NO     Brilliant. Another sequel nobody as…
positive  0.495        NO     I expected it to be terrible, but i…
negative  0.495        yes    I expected it to be great, but it w…
positive  0.779        yes    Excellent movie, awesome soundtrack.
positive  0.810        yes    Superb film, wonderful score.
positive  0.521        yes    A flabbergasting, mesmerizing tour …

7 right out of 13
Mô hình túi từ thất bại ở đúng những chỗ chúng ta đã dự đoán. Sự mỉa mai dễ dàng đánh lừa nó: hai từ “perfect” và “masterpiece” khiến câu châm biếm về việc ngủ gật trong rạp được chấm tới 76% tích cực, còn từ “Brilliant” khiến câu chê phần tiếp theo đạt 60% tích cực. Cấu trúc phủ định cũng chịu chung số phận: câu “Not bad at all, actually” chỉ được chấm 34% tích cực vì bị từ “bad” kéo tụt điểm. Hai câu có cùng tập từ vựng nhưng ngược nghĩa nhận cùng một mức xác suất, nên chắc chắn ít nhất một trong hai câu phải sai. Ở chiều ngược lại, hai câu dùng các từ đồng nghĩa lại đều được phân loại đúng: mỗi từ trong hai câu đó đều xuất hiện ở hàng trăm bài đánh giá có nhãn, nên mô hình đã học tốt trọng số riêng của từng từ. Mô hình túi từ biết từ nào là tích cực, nhưng hoàn toàn không biết bài đánh giá thực sự đang nói điều gì.
Làm sao chúng ta có thể làm tốt hơn? Để giải quyết giới hạn đầu tiên, ta cần một cách biểu diễn sao cho những từ có nghĩa tương tự nhau sẽ nhận được các vector gần giống nhau — nhờ đó những gì mô hình học được từ chữ “excellent” cũng sẽ tự động giúp ích khi nó gặp chữ “superb”, và thậm chí giúp ích cho cả những từ hiếm khi xuất hiện. Đó chính là chủ đề của mục tiếp theo. Còn đối với bài toán trật tự từ, chúng ta sẽ phải đợi đến mục 7.
Nếu bạn muốn đào sâu hơn, dưới đây là một số bài tập mở rộng.
Một mạng nơ-ron nhỏ. Hãy thay thế hồi quy logistic bằng một mạng perceptron có một tầng ẩn (MLPClassifier trong scikit-learn). Liệu nó có vượt qua được hồi quy logistic không? Nó có đoán đúng thêm câu nào trong tập đánh giá khó không?
Naive Bayes. Hãy huấn luyện bộ phân loại Naive Bayes trên các vector đếm (MultinomialNB trong scikit-learn) — một trong ba bộ phân loại được sử dụng bởi Pang và cộng sự (Pang et al., 2002). Kết quả của nó so với hồi quy logistic như thế nào?
Các cặp từ (Bigrams). Hãy thêm các cặp từ liên tiếp vào bộ từ vựng (ngram_range=(1, 2)), giống như cách làm của Wang và Manning (Wang & Manning, 2012). Độ chính xác cải thiện được bao nhiêu? Nó khắc phục được những câu nào trong tập đánh giá khó?
Kích thước bộ từ vựng. Độ chính xác trên tập kiểm tra thay đổi như thế nào khi tăng dần từ 1.000 từ cho đến toàn bộ từ vựng của tập huấn luyện (khoảng 75.000 từ)?
Loại bỏ các lối tắt (Shortcuts). Hãy xóa toàn bộ các chữ số khỏi các bài đánh giá trước khi đếm từ. Mô hình bị giảm bao nhiêu độ chính xác khi không còn dựa dẫm được vào các điểm số “7/10” hay “8/10”?
4. Biểu diễn nhúng từ đặc (Dense word embeddings)
Ở cuối mục 3, chúng ta đã thấy giới hạn đầu tiên của mô hình túi từ: mỗi từ chiếm một chiều không gian riêng biệt, nên đối với mô hình, từ “superb” (siêu phàm) khác biệt với từ “excellent” (xuất sắc) chẳng kém gì so với từ “boring” (nhàm chán). Hãy cùng khắc phục nhược điểm này.
4.1 Ma trận nhúng (The embedding matrix)
Ý tưởng cốt lõi ở đây là biểu diễn mỗi từ bằng một vector đặc (dense vector) gồm các số thực, nằm trong một không gian có số chiều nhỏ hơn rất nhiều so với kích thước của bộ từ vựng: chỉ vài trăm chiều (chẳng hạn ) cho hàng chục nghìn từ. Vector này được gọi là biểu diễn nhúng (embedding) của từ đó.
Biểu diễn nhúng của toàn bộ các từ trong từ vựng được lưu trữ chung trong một ma trận nhúng (embedding matrix) , với mỗi cột tương ứng với một từ:
Việc tra cứu vector nhúng của một từ về mặt toán học hoàn toàn tương đương với việc nhân ma trận với vector one-hot của từ đó: phép nhân ma trận này sẽ trích xuất ra đúng cột tương ứng với từ đang xét.
Lợi thế to lớn của các biểu diễn nhúng đặc so với các vector thưa của túi từ là chúng ta có thể so sánh trực tiếp chúng với nhau và đo lường mức độ tương đồng giữa hai từ bất kỳ. Thước đo tiêu chuẩn thường dùng là độ tương đồng cosine (cosine similarity) — tức cosine của góc hợp bởi hai vector, một đại lượng chỉ phụ thuộc vào hướng chứ không phụ thuộc vào độ dài của chúng:
Độ tương đồng cosine bằng khi hai vector cùng hướng, bằng khi chúng trực giao (vuông góc), và bằng khi chúng ngược hướng nhau hoàn toàn. Lưu ý rằng các vector one-hot của hai từ khác nhau thì luôn luôn vuông góc: trong không gian túi từ, độ tương đồng giữa hai từ khác nhau bất kỳ luôn bằng 0.
Tạm thời hãy giả sử rằng chúng ta đã có sẵn một ma trận nhúng tốt (chúng ta sẽ sớm thấy cách tạo ra nó, và như bạn có thể đoán được, ta sẽ để máy tự học ma trận này). Khi đó, ta có quyền kỳ vọng rằng những từ có nghĩa gần nhau sẽ nhận được các vector gần nhau: độ tương đồng rất cao giữa “excellent” (xuất sắc) và “superb” (siêu phàm), nhưng lại rất thấp giữa “ball” (quả bóng) và “crocodile” (cá sấu). Đó chính là phẩm chất làm nên một biểu diễn nhúng tốt: độ tương đồng hình học giữa các vector phản ánh độ tương đồng ngữ nghĩa giữa các từ. Nhờ vậy, một mô hình đã học được điều gì đó về từ “excellent” thì nghiễm nhiên cũng hiểu được phần nào về từ “superb”.
Đọc thêm Phân tích Ngữ nghĩa Tiềm ẩn (Latent Semantic Analysis): một con đường khác để thu được các vector đặc
Có nhiều phương pháp khác để tạo ra các vector từ đặc mà không cần dùng đến mạng nơ-ron. Chẳng hạn, hãy lấy ma trận đếm ở mục 3 (với mỗi hàng là một từ và mỗi cột là một tài liệu), sau đó nén nó lại bằng phép phân rã giá trị kỳ dị rút gọn (truncated Singular Value Decomposition — SVD): mỗi từ sẽ nhận được một vector đặc, và những từ thường xuất hiện trong cùng các tài liệu sẽ có các vector gần giống nhau. Phương pháp này được gọi là Phân tích Ngữ nghĩa Tiềm ẩn (Latent Semantic Analysis — LSA).
Tuy nhiên, việc chỉ thay từng từ bằng vector nhúng vẫn chưa giải quyết được bài toán độ dài đầu vào biến thiên. Khi thay thế từ của một văn bản bằng vector có kích thước , thứ ta thu được vẫn chưa phải là một biểu diễn có kích thước cố định! Do đó, chúng ta cần một phép tổng hợp (aggregation / pooling) để gộp vector này lại thành một vector duy nhất có kích thước không phụ thuộc vào . Dưới đây là ba lựa chọn đơn giản:
- lấy trung bình cộng (average) của vector, thu được một vector kích thước ;
- lấy trung bình có trọng số (weighted average) để ưu tiên một số từ quan trọng hơn, cũng cho ra kích thước ;
- ghép nối (concatenation) các vector của từ cuối cùng lại với nhau, thu được một vector có kích thước , tương tự như cách mô hình n-gram ở mục 2 chỉ giữ lại từ cuối.
Phép ghép nối giữ nguyên được trật tự của những từ cuối cùng, nhưng lại bỏ quên toàn bộ phần văn bản đứng trước đó. Đặc điểm này rất phù hợp với bài toán mô hình hóa ngôn ngữ — nơi từ tiếp theo phụ thuộc chủ yếu vào vài từ ngay trước nó — vì vậy chúng ta sẽ bắt đầu từ phương pháp này.
4.2 Ghép nối (Concatenation) → Mô hình ngôn ngữ nơ-ron của Bengio
Hãy quay lại với bài toán mô hình hóa ngôn ngữ một lát. Ở các mô hình n-gram trong mục 2, chúng ta đã giả định rằng xác suất của từ tiếp theo chỉ phụ thuộc vào từ đứng ngay trước nó. Bây giờ, ta vẫn giữ nguyên giả định Markov này, nhưng thay thế bảng đếm tần số bằng một mạng nơ-ron nhận đầu vào là vector ghép nối của các biểu diễn nhúng của từ đứng trước: một vector có kích thước cố định bằng .
Đây chính là ý tưởng cốt lõi trong bài báo có tầm ảnh hưởng sâu rộng của Bengio và cộng sự năm 2003, công trình được xem là mô hình ngôn ngữ nơ-ron đầu tiên trong lịch sử. Kiến trúc của nó rất sáng sủa: tra cứu các vector nhúng của từ cuối cùng trong ma trận , ghép nối chúng lại thành một vector ngữ cảnh duy nhất , rồi đưa đi qua một mạng truyền thẳng (feedforward network) có một tầng ẩn:
trong đó và là ma trận trọng số và vector độ chệch (bias) của tầng ẩn, còn và là trọng số và độ chệch của tầng đầu ra. Tầng đầu ra tính một điểm số (logit) cho mỗi từ trong bộ từ vựng, và hàm softmax, , chuyển đổi điểm số này thành một phân phối xác suất hợp lệ (các giá trị đều dương và có tổng bằng 1), đóng vai trò tương tự như hàm sigmoid ở mục 3.2 nhưng mở rộng cho lớp thay vì hai lớp.
Ma trận nhúng cũng là một tham số của mô hình giống hệt như , , và : các biểu diễn nhúng từ và các trọng số của mạng nơ-ron được học đồng thời cùng nhau (jointly learned) bằng cách cực tiểu hóa hàm mất mát entropy chéo ở mục 2.2 trên văn bản huấn luyện. Ở mỗi bước cập nhật, đạo hàm (gradient) của hàm mất mát được lan truyền ngược (backpropagation) xuyên qua mạng nơ-ron về tới tận các cột của ma trận ứng với các từ trong ngữ cảnh, qua đó dịch chuyển dần vị trí của các vector nhúng này trong không gian.
Ở đây tôi giả định rằng bạn đã biết cách huấn luyện một mạng nơ-ron cơ bản với thư viện PyTorch. Nếu chưa quen, khóa học của Andrej Karpathy là một điểm khởi đầu tuyệt vời — bài giảng thứ ba trong chuỗi đó xây dựng chính xác một mô hình kiểu này ở cấp độ ký tự.
Đọc thêm PyTorch: những thành phần chúng ta sử dụng trong bài viết này
Từ phần này trở đi, các bài tập thực hành sẽ huấn luyện mạng nơ-ron bằng PyTorch. Chúng chỉ sử dụng một tập con rất nhỏ và nhất quán của thư viện:
- Tensor. Hàm
torch.tensorchuyển đổi danh sách các chỉ số từ (word indices) thành các tensor. Phương thức.to(device)đưa chúng lên GPU nếu máy có trang bị, hoặc chạy mặc định trên CPU. - Các tầng mạng (Layers). Một mô hình được ghép từ chuỗi các tầng đặt trong
nn.Sequential:nn.Embeddinglưu trữ ma trận nhúng ở mục 4.1;nn.Flattenghép nối các vector nhúng trong ngữ cảnh lại thành một vector dài;nn.Linearthực hiện phép biến đổi tuyến tính; cùng các hàm kích hoạt phi tuyếnnn.Tanhvànn.ReLU. - Hàm mất mát (Losses). Hàm
F.cross_entropynhận đầu vào là điểm số chưa chuẩn hóa (logits) từ tầng đầu ra cùng chỉ số của từ đúng thực tế, sau đó tự động áp dụng hàm softmax và tính hàm mất mát entropy chéo ở mục 2.2. Lớpnn.BCEWithLogitsLossthực hiện điều tương tự cho bài toán phân loại nhị phân hai lớp với hàm sigmoid ở mục 3.2.
Vòng lặp huấn luyện được viết tường minh hoàn toàn bằng tay và giữ nguyên cấu trúc ở mọi bài tập:
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
for epoch in range(n_epochs):
    order = torch.randperm(len(targets))  # xáo trộn thứ tự các mẫu huấn luyện
    for start in range(0, len(order), batch_size):
        batch = order[start:start + batch_size]
        scores = model(inputs[batch])
        loss = F.cross_entropy(scores, targets[batch])
        optimizer.zero_grad()
        loss.backward()   # tính đạo hàm ngược (gradients)
        optimizer.step()  # cập nhật các tham số mô hình
Khi đánh giá mô hình trên tập xác thực, hãy đặt khối lệnh tính toán bên trong ngữ cảnh with torch.no_grad(): để bỏ qua việc lưu đồ thị tính đạo hàm. Để lưu lại mô hình ở epoch tốt nhất, hãy tạo một bản sao sâu bằng copy.deepcopy. Chúng ta không cần dùng đến Dataset hay DataLoader: toàn bộ dữ liệu của mỗi bài tập đều nằm gọn trong bộ nhớ dưới dạng vài tensor, và ta tự cắt các lô dữ liệu (batches) trực tiếp bằng chỉ số mảng.
Các mục sau sẽ bổ sung thêm một vài công cụ nhỏ: requires_grad_(False) để đóng băng các biểu diễn nhúng tiền huấn luyện trong quá trình học (mục 5); các tầng hồi quy nn.LSTM và nn.GRU, cùng kỹ thuật cắt xén đạo hàm (gradient clipping) bằng nn.utils.clip_grad_norm_ (mục 7); và cách viết mô hình dưới dạng lớp con kế thừa từ nn.Module với phương thức forward tùy chỉnh khi kiến trúc không còn là một chuỗi tầng nối tiếp đơn giản — chẳng hạn như mạng LSTM ở mục 7 và kiến trúc bộ mã hóa–bộ giải mã (encoder–decoder) ở mục 9.
Tại sao kiến trúc này lại hoạt động hiệu quả hơn phương pháp đếm? Hãy nhớ lại lời nguyền số chiều ở mục 2.3: hầu hết các ngữ cảnh dài 3 hoặc 4 từ chưa từng xuất hiện trong văn bản huấn luyện, và đối với phương pháp đếm, gặp một ngữ cảnh mới đồng nghĩa với việc đi vào ngõ cụt. Ngược lại, mô hình nơ-ron không hề bị bó tay: nếu nó từng nhìn thấy cụm “the cat is walking”, và nếu từ “dog” có vector nhúng nằm gần vector nhúng của từ “cat”, thì mạng nơ-ron nghiễm nhiên đã biết cách xử lý cụm “the dog is walking”. Và quả thực, những từ tương tự nhau sẽ tự động hội tụ về các vector nhúng gần nhau, bởi chúng thường xuất hiện trong các ngữ cảnh giống nhau và đòi hỏi mô hình đưa ra các phân phối dự đoán tương tự nhau. Mô hình có khả năng khái quát hóa từ những ngữ cảnh đã từng gặp sang những ngữ cảnh hoàn toàn mới chưa từng thấy bao giờ.
Hãy huấn luyện mô hình này trên tập dữ liệu WikiText-2 và so sánh trực tiếp với các mô hình n-gram ở mục 2. Vì mạng nơ-ron này có số lượng tham số lớn hơn rất nhiều so với mô hình hồi quy logistic ở mục 3 và bắt đầu bị quá khớp (overfit) chỉ sau vài epoch, chúng ta sẽ theo dõi và chọn số epoch tối ưu dựa trên tập xác thực.
Bài tập 4.2★ Huấn luyện mô hình ngôn ngữ nơ-ron của Bengio
Hãy huấn luyện mô hình ngôn ngữ nơ-ron của Bengio trên bộ dữ liệu WikiText-2: tra cứu vector nhúng của 3 từ đứng ngay trước mỗi từ cần dự đoán (), ghép nối chúng lại, đưa qua một tầng ẩn gồm 200 nút (hàm kích hoạt tanh) rồi tới tầng softmax trên toàn bộ từ vựng. Huấn luyện trong 4 epoch, đo perplexity trên tập xác thực sau mỗi epoch, và tính perplexity trên tập kiểm tra của mô hình tốt nhất. Hãy so sánh kết quả với các mô hình n-gram đã làm mượt ở bài tập 2.3b. Sau đó, hãy in ra 5 từ láng giềng gần nhất (nearest neighbors) của các từ “three”, “he”, “city”, “film”, “excellent” và “terrible” trong ma trận nhúng vừa học được, tính theo độ tương đồng cosine.
Đoạn mã khởi đầu xây dựng ba chuỗi văn bản như ở bài tập 2.1 và 2.2, tiếp đó gán cho mỗi từ trong từ vựng một chỉ số nguyên (index), rồi biến đổi mỗi chuỗi văn bản thành các cặp mẫu dữ liệu: chỉ số của 3 từ liên tiếp làm đầu vào, và chỉ số của từ đứng ngay sau chúng làm nhãn mục tiêu.
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
# [Sao chép từ mã khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")


# -------------------------
#  Phần mới trong bài này
# -------------------------
# Gán một chỉ số (index) cho mỗi từ trong từ vựng
vocabulary = sorted(set(train_sequence))
word_index = {word: i for i, word in enumerate(vocabulary)}

# Chuyển chuỗi từ thành các cặp chỉ số (ngữ cảnh, từ tiếp theo):
# hàng i của contexts chứa 3 từ đứng trước từ targets[i]
import torch

context_size = 3

def make_pairs(sequence):
    indices = [word_index[word] for word in sequence]
    contexts = [indices[i - context_size:i]
                for i in range(context_size, len(indices))]
    targets = indices[context_size:]
    return torch.tensor(contexts), torch.tensor(targets)

train_contexts, train_targets = make_pairs(train_sequence)
val_contexts, val_targets = make_pairs(val_sequence)
test_contexts, test_targets = make_pairs(test_sequence)

print(f"train: {len(train_targets)} pairs")
context = [vocabulary[i] for i in train_contexts[30].tolist()]
print(f"example: {context} -> {vocabulary[train_targets[30]]}")
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words
train: 2051907 pairs
example: ['Valkyria', 'Chronicles', 'III'] -> outside
Hint
Lớp nn.Embedding(V, D) lưu trữ ma trận nhúng: khi nhận một tensor chứa chỉ số từ có kích thước (batch, 3), nó sẽ trả về các vector nhúng tương ứng có kích thước (batch, 3, D). Tiếp theo, nn.Flatten() sẽ ghép nối 3 vector nhúng trên mỗi hàng lại thành một vector dài kích thước 3 * D. Hãy khởi tạo các vector nhúng với giá trị nhỏ bằng nn.init.normal_(embedding.weight, std=0.1): nếu để độ lệch chuẩn mặc định bằng 1, các từ hiếm sẽ hầu như không kịp dịch chuyển khỏi vị trí ngẫu nhiên ban đầu sau 4 epoch.
Hint
Tầng đầu ra trả về điểm số. Hàm F.cross_entropy(scores, targets) sẽ tự động áp dụng softmax và tính luôn hàm mất mát entropy chéo chỉ trong một bước. Độ hỗn loạn (perplexity) chính là hàm mũ () của giá trị mất mát trung bình trên toàn bộ các mẫu của tập xác thực.
Hint
Hãy huấn luyện bằng thuật toán tối ưu torch.optim.Adam (tốc độ học lr=0.001) với kích thước lô (batch size) là 512 cặp: mỗi epoch sẽ gồm khoảng 4.000 batch. Trên CPU của máy tính xách tay, mỗi epoch mất khoảng một phút rưỡi, còn trên GPU sẽ nhanh hơn rất nhiều. Hãy lưu lại một bản sao của mô hình (copy.deepcopy) tại epoch đạt perplexity xác thực thấp nhất.
Hint
Lưu ý rằng nn.Embedding lưu trữ ma trận ở dạng chuyển vị: hàng thứ của embedding.weight chính là vector nhúng của từ thứ . Hãy chuẩn hóa từng hàng bằng cách chia cho độ dài Euclid của nó: khi đó, độ tương đồng cosine giữa một từ với tất cả các từ còn lại có thể tính cực nhanh chỉ bằng một phép nhân ma trận với vector.
Điểm kiểm tra kết quả bạn cần đạt được
Perplexity trên tập xác thực giảm từ 260,1 sau epoch đầu tiên xuống 223,9 sau epoch thứ ba, rồi tăng ngược lên 228,5 ở epoch thứ tư: mô hình bắt đầu bị quá khớp. Perplexity trên tập kiểm tra của mô hình ở epoch 3 đạt 208,5. Các láng giềng gần nhất của từ “three” đều là các con số khác, còn láng giềng của “film” bao gồm “book”, “novel” và “album”. Nếu chạy trên GPU, các con số và danh sách từ láng giềng của bạn có thể xê dịch đôi chút.
epoch 1: validation perplexity 260.1
epoch 2: validation perplexity 226.2
epoch 3: validation perplexity 223.9
epoch 4: validation perplexity 228.5

test perplexity, epoch 3: 208.5

three: two, four, five, eight, six
he: she, He, Torres, McCall, Colby
city: town, park, community, sightings, formations
film: book, novel, album, What, bird
excellent: actual, reduce, ultimate, ideological, immense
terrible: my, ought, interesting, wrong, physical
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực (validation) và kiểm tra (test), tạo tương tự
# [Sao chép từ mã khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")


# -------------------------
#  Phần mới trong bài này
# -------------------------
# Gán một chỉ số (index) cho mỗi từ trong từ vựng
vocabulary = sorted(set(train_sequence))
word_index = {word: i for i, word in enumerate(vocabulary)}

# Chuyển chuỗi từ thành các cặp chỉ số (ngữ cảnh, từ tiếp theo):
# hàng i của contexts chứa 3 từ đứng trước từ targets[i]
import torch

context_size = 3

def make_pairs(sequence):
    indices = [word_index[word] for word in sequence]
    contexts = [indices[i - context_size:i]
                for i in range(context_size, len(indices))]
    targets = indices[context_size:]
    return torch.tensor(contexts), torch.tensor(targets)

train_contexts, train_targets = make_pairs(train_sequence)
val_contexts, val_targets = make_pairs(val_sequence)
test_contexts, test_targets = make_pairs(test_sequence)

print(f"train: {len(train_targets)} pairs")
context = [vocabulary[i] for i in train_contexts[30].tolist()]
print(f"example: {context} -> {vocabulary[train_targets[30]]}")
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words
train: 2051907 pairs
example: ['Valkyria', 'Chronicles', 'III'] -> outside
# (1) Xây dựng mô hình: tra cứu vector nhúng của 3 từ ngữ cảnh,
# ghép nối chúng lại, đi qua tầng ẩn (tanh) và xuất ra một điểm
# cho mỗi từ trong từ vựng. Khởi tạo các vector nhúng nhỏ: nếu
# dùng mặc định (cỡ 1), các từ hiếm sẽ giữ nguyên vector ngẫu nhiên.
from torch import nn

V = len(vocabulary)
D = 100   # kích thước vector nhúng
H = 200   # kích thước tầng ẩn
torch.manual_seed(0)
model = nn.Sequential(
    nn.Embedding(V, D),   # (batch, 3) -> (batch, 3, D)
    nn.Flatten(),         # ghép nối: (batch, 3 * D)
    nn.Linear(context_size * D, H),
    nn.Tanh(),
    nn.Linear(H, V),      # mỗi từ một điểm số
)
nn.init.normal_(model[0].weight, std=0.1)

# Chạy trên GPU nếu có
device = "cuda" if torch.cuda.is_available() else "cpu"
model = model.to(device)


# (2) Độ bối rối của mô hình trên tập các cặp từ: hàm mũ của
# hàm mất mát entropy chéo trung bình. F.cross_entropy áp dụng
# softmax lên điểm số rồi tính độ mất mát như ở mục 2.2.
import math
import torch.nn.functional as F

def perplexity(model, contexts, targets):
    total_loss = 0
    with torch.no_grad():
        for start in range(0, len(targets), 10000):
            scores = model(contexts[start:start + 10000].to(device))
            batch_targets = targets[start:start + 10000].to(device)
            total_loss += F.cross_entropy(scores, batch_targets,
                                          reduction="sum").item()
    return math.exp(total_loss / len(targets))


# (3) Huấn luyện bằng Adam trên từng lô 512 cặp. Sau mỗi epoch,
# đo độ bối rối trên tập xác thực và lưu bản sao mô hình tốt nhất.
import copy

optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
batch_size = 512
best_perplexity = math.inf
for epoch in range(4):
    order = torch.randperm(len(train_targets))   # xáo trộn các cặp
    for start in range(0, len(order), batch_size):
        batch = order[start:start + batch_size]
        scores = model(train_contexts[batch].to(device))
        batch_targets = train_targets[batch].to(device)
        loss = F.cross_entropy(scores, batch_targets)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    val_perplexity = perplexity(model, val_contexts, val_targets)
    print(f"epoch {epoch + 1}: validation perplexity "
          f"{val_perplexity:.1f}")
    if val_perplexity < best_perplexity:
        best_perplexity, best_epoch = val_perplexity, epoch + 1
        best_model = copy.deepcopy(model)


# (4) Độ bối rối trên tập kiểm tra của mô hình tốt nhất
test_perplexity = perplexity(best_model, test_contexts, test_targets)
print(f"\ntest perplexity, epoch {best_epoch}: {test_perplexity:.1f}")


# (5) Các láng giềng gần nhất của một vài từ. nn.Embedding lưu W
# ở dạng chuyển vị: hàng i là vector nhúng của từ i. Chia mỗi hàng
# cho độ dài của nó để tích vô hướng trở thành độ tương đồng cosine.
embeddings = best_model[0].weight.detach().cpu()
embeddings = embeddings / embeddings.norm(dim=1, keepdim=True)

print()
for word in ["three", "he", "city", "film", "excellent", "terrible"]:
    similarities = embeddings @ embeddings[word_index[word]]
    ranking = similarities.argsort(descending=True).tolist()
    nearest = [vocabulary[i] for i in ranking[1:6]]   # [0]: chính từ đó
    print(f"{word}: {', '.join(nearest)}")
epoch 1: validation perplexity 260.1
epoch 2: validation perplexity 226.2
epoch 3: validation perplexity 223.9
epoch 4: validation perplexity 228.5

test perplexity, epoch 3: 208.5

three: two, four, five, eight, six
he: she, He, Torres, McCall, Colby
city: town, park, community, sightings, formations
film: book, novel, album, What, bird
excellent: actual, reduce, ultimate, ideological, immense
terrible: my, ought, interesting, wrong, physical
Chỉ với 3 từ ngữ cảnh, mô hình mạng nơ-ron đã đạt perplexity trên tập kiểm tra là 208,5 — bỏ xa mức 277,7 của mô hình 5-gram nội suy ở mục 2.3 (vốn được nhìn nhiều hơn một từ ngữ cảnh). Nó thậm chí còn đánh bại cả mô hình 5-gram Kneser-Ney (219,3) — đỉnh cao của kỷ nguyên đếm từ! Và hãy nhìn vào các biểu diễn nhúng mà mô hình tự học được: láng giềng của “three” toàn là các con số, “he” nằm gần nhất với “she”, còn “film” nằm cạnh “book”, “novel” và “album”. Chẳng ai dạy cho mô hình biết rằng những từ này có liên hệ với nhau: nó tự khám phá ra điều đó bởi chúng thường xuất hiện trong những ngữ cảnh giống nhau. Tuy nhiên, láng giềng của hai từ “excellent” và “terrible” lại hoàn toàn là nhiễu loạn. Lý do là vì những tính từ biểu cảm này rất hiếm gặp trên bách khoa toàn thư Wikipedia: “excellent” chỉ xuất hiện 28 lần trong văn bản huấn luyện và “terrible” xuất hiện 24 lần, so với 1.253 lần của từ “film”. Một mô hình ngôn ngữ sẽ gán các vector nhúng gần nhau cho những từ đóng cùng vai trò trong câu, miễn là nó được gặp những từ đó đủ nhiều lần.
Đọc thêm Chi phí tính toán của tầng Softmax: thời gian huấn luyện thực sự tiêu tốn vào đâu
Hãy để ý xem quá trình huấn luyện mạng nơ-ron mất nhiều thời gian hơn hẳn so với việc đếm từ ở mục 2. Gần như toàn bộ thời gian này đều tiêu tốn ở tầng tuyến tính đầu ra — nơi mô hình phải tính điểm số cho từng từ trong tổng số 33.277 từ của bộ từ vựng tại mỗi vị trí trong văn bản: phép nhân cho mỗi từ, so với chỉ phép nhân ở tầng ẩn. Gánh nặng tính toán của hàm softmax trên toàn bộ từ vựng sẽ còn quay trở lại ở mục 5.2.
4.3 Các phương pháp tổng hợp vector từ của một văn bản
Phép ghép nối (concatenation) hoạt động tốt cho bài toán mô hình hóa ngôn ngữ, bởi ta có thể giả định một cách hợp lý rằng chỉ có từ gần nhất là quan trọng nhất. Thế nhưng như đã phân tích ở mục 3.1, cách này hoàn toàn vô dụng đối với bài toán phân loại văn bản: sắc thái cảm xúc của một bài đánh giá phim có thể nằm ở bất kỳ câu nào từ đầu đến cuối bài. Vậy làm thế nào để tổng hợp vector nhúng của cả bài đánh giá lại thành một vector duy nhất?
Lựa chọn đơn giản nhất là lấy trung bình cộng của chúng. Và có một cách viết biểu thức trung bình này cực kỳ gọn đẹp. Việc cộng dồn tất cả các vector nhúng của các từ xuất hiện trong bài đánh giá thực chất chính là phép nhân ma trận nhúng với vector đếm túi từ ở mục 3.2, bởi cột vector của mỗi từ được cộng lặp lại đúng bằng số lần từ đó xuất hiện trong bài. Do đó:
trong đó là vector tần suất tương đối (frequencies) của các từ trong bài đánh giá. Trung bình cộng của các vector nhúng thực chất chính là một túi từ đã được nén tuyến tính bởi ma trận từ chiều xuống còn chiều. Giống hệt như túi từ, phép lấy trung bình này quên sạch trật tự của các từ. Đồng thời, nó cũng coi mọi từ đều quan trọng ngang nhau, kể cả hư từ “the”: để tránh làm loãng vector trung bình bởi những từ ít mang thông tin, ta có thể lấy trung bình có trọng số bằng cách nhân với hệ số IDF ở mục 3.3.
Vậy chúng ta thu được lợi ích gì từ phép nén số chiều này? Hãy xét đầu phân loại đơn giản nhất — một mô hình hồi quy logistic đặt ngay trên vector trung bình: , trong đó là vector trọng số của đầu phân loại. Khai triển tích vô hướng này, ta thấy:
với là cột thứ của ma trận (ứng với từ ). Biểu thức này chẳng khác gì một mô hình hồi quy logistic đánh trực tiếp trên tần suất của các từ, trong đó trọng số dành cho từ chính là tích vô hướng . Vì vậy, nếu ma trận được học đồng thời từ đầu cùng với , chúng ta sẽ chẳng thu được bất kỳ lợi thế toán học nào so với mô hình túi từ ở mục 3! Sự cải thiện chỉ có thể đến từ một trong hai hướng sau:
- bổ sung thêm các tầng ẩn phi tuyến tính phía sau bước lấy trung bình, để đầu phân loại không còn là một hàm tuyến tính đơn thuần nữa;
- khởi tạo từ một ma trận nhúng đã có chất lượng tốt sẵn từ trước, và giữ cố định nó. Khi đó, trọng số phân loại của một từ sẽ phụ thuộc trực tiếp vào vị trí vector nhúng của nó: những từ đồng nghĩa có vector gần nhau sẽ tự động nhận được trọng số gần bằng nhau, ngay cả với những từ chưa từng xuất hiện trong tập bài đánh giá có nhãn! Đây chính là chủ đề trọng tâm của mục 5.
Hướng tiếp cận thứ nhất đưa ta đến kiến trúc Mạng lấy trung bình sâu (Deep Averaging Network — DAN) (Iyyer et al., 2015): lấy trung bình cộng các vector nhúng, đưa vector trung bình này đi qua một vài tầng ẩn phi tuyến, rồi mới đưa vào tầng phân loại cuối cùng. Vào năm 2015, kiến trúc đơn giản này đã đạt độ chính xác ngang ngửa với các mô hình phức tạp phân tích cú pháp câu, trong khi chỉ mất vài phút để huấn luyện trên một chiếc máy tính xách tay. Hãy cùng huấn luyện một mạng DAN trên bộ dữ liệu IMDB.
Bài tập 4.3 Huấn luyện mạng lấy trung bình sâu (DAN) trên IMDB
Hãy huấn luyện một mạng lấy trung bình sâu (deep averaging network) trên bộ dữ liệu IMDB với bộ từ vựng 10.000 từ của bài tập 3.2: lấy trung bình các vector nhúng của các từ trong bài đánh giá (), tiếp nối bằng hai tầng ẩn (mỗi tầng 100 nút) và một đầu ra duy nhất, tất cả đều được huấn luyện đồng thời từ đầu (from scratch). Hãy chọn số epoch tối ưu trên tập xác thực, đo độ chính xác trên tập kiểm tra và so sánh với mô hình túi từ ở mục 3. Sau đó, hãy chạy thử mô hình trên tập các câu đánh giá khó của bài tập 3.4.
Đoạn mã khởi đầu lặp lại bước (1) và (2) trong lời giải bài tập 3.2 (chia tập dữ liệu và đếm từ), đồng thời liệt kê sẵn danh sách các câu đánh giá khó của bài tập 3.4.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ trong mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Biểu thức chính quy coi mọi chuỗi chữ cái
# hoặc chữ số là một từ, kể cả từ chỉ gồm một chữ cái như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
# [Sao chép từ mã khởi đầu bài 3.4]
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai / Châm biếm
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm gặp
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews
Hint
Theo công thức chứng minh ở trên, trung bình cộng các vector nhúng của một bài đánh giá chính bằng ma trận nhân với vector tần suất từ của bài đó. Vì vậy, tầng đầu tiên của mạng có thể viết gọn thành nn.Linear(V, D, bias=False) áp dụng trực tiếp lên các vector đếm của bài tập 3.2 đã chia cho tổng số từ của từng bài: ma trận trọng số của tầng này (kích thước ) chính là ma trận nhúng . Hãy chuyển đổi các vector đếm dạng ma trận thưa sang tensor theo từng batch một bằng lệnh torch.tensor(X[batch].toarray()): nếu chuyển đổi toàn bộ tập dữ liệu cùng lúc sẽ ngốn mất hàng gigabyte bộ nhớ.
Hint
Phía sau tầng lấy trung bình, hãy xếp nối tiếp các tầng nn.Linear và nn.ReLU, rồi kết thúc bằng một đầu ra duy nhất biểu thị điểm số (logit) của bài đánh giá. Hàm mất mát nn.BCEWithLogitsLoss() sẽ tự động áp dụng hàm sigmoid lên điểm số này và tính entropy chéo cho hai lớp.
Hint
Hãy huấn luyện bằng thuật toán Adam (tốc độ học lr=0.001) với các batch gồm 64 bài đánh giá: mỗi epoch chỉ mất khoảng một giây. Mô hình sẽ bắt đầu quá khớp chỉ sau một vài epoch: hãy lưu lại bản sao của mô hình (copy.deepcopy) tại epoch có độ chính xác xác thực cao nhất.
Điểm kiểm tra kết quả bạn cần đạt được
Độ chính xác cao nhất trên tập xác thực đạt 89,4% ở epoch 2, và độ chính xác tương ứng trên tập kiểm tra là 88,1%. Mô hình đoán đúng 6 trên 13 câu đánh giá khó, với các xác suất dự đoán cực kỳ sát 0 hoặc 1. Hai câu đánh giá có cùng tập từ vựng vẫn nhận xác suất giống hệt nhau: 0,043.
epoch 1: validation accuracy 0.890
epoch 2: validation accuracy 0.894
epoch 3: validation accuracy 0.883
epoch 4: validation accuracy 0.882
epoch 5: validation accuracy 0.879

test accuracy, epoch 2: 0.881

label     p(positive)  right  review
positive  0.000        NO     Not bad at all, actually.
negative  0.003        yes    Nothing about this movie is good.
positive  0.015        NO     I wouldn't call it a masterpiece, b…
negative  0.000        yes    Great acting, great lighting and a …
positive  0.063        NO     The first hour is slow and the dial…
negative  0.994        NO     Everyone told me it would be the fi…
negative  0.990        NO     Wow, what a masterpiece. Two hours …
negative  0.870        NO     Brilliant. Another sequel nobody as…
positive  0.043        NO     I expected it to be terrible, but i…
negative  0.043        yes    I expected it to be great, but it w…
positive  1.000        yes    Excellent movie, awesome soundtrack.
positive  1.000        yes    Superb film, wonderful score.
positive  0.999        yes    A flabbergasting, mesmerizing tour …

6 right out of 13
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ trong mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Biểu thức chính quy coi mọi chuỗi chữ cái
# hoặc chữ số là một từ, kể cả từ chỉ gồm một chữ cái như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
# [Sao chép từ mã khởi đầu bài 3.4]
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai / Châm biếm
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm gặp
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews
# (1) Chuyển các vector đếm thành vector tần suất: chia số đếm
# cho tổng số từ của bài đánh giá. X.toarray() tạo mảng numpy từ
# các hàng của ma trận thưa: chỉ xử lý từng nhóm hàng mỗi lần vì
# chuyển toàn bộ cùng lúc sẽ tốn hàng gigabyte bộ nhớ.
import torch

def frequencies(X):
    counts = torch.tensor(X.toarray(), dtype=torch.float32)
    lengths = counts.sum(dim=1, keepdim=True)
    return counts / lengths


# (2) Xây dựng mạng nơ-ron. Tầng đầu tiên (không có hệ số chệch)
# nhân vector tần suất với ma trận W kích thước D x V: kết quả là
# trung bình cộng các vector nhúng của các từ trong bài đánh giá.
# Tiếp theo là hai tầng ẩn và một điểm số đầu ra.
from torch import nn

V = X_train.shape[1]   # kích thước từ vựng
D = 100   # kích thước vector nhúng
H = 100   # kích thước các tầng ẩn
torch.manual_seed(0)
model = nn.Sequential(
    nn.Linear(V, D, bias=False),   # trung bình các vector nhúng
    nn.Linear(D, H),
    nn.ReLU(),
    nn.Linear(H, H),
    nn.ReLU(),
    nn.Linear(H, 1),   # p(tích cực) = sigmoid(điểm số)
)


# (3) Huấn luyện bằng Adam trên từng lô 64 bài đánh giá với hàm
# mất mát entropy chéo cho hai lớp. Sau mỗi epoch, đo độ chính xác
# trên tập xác thực và lưu bản sao của mô hình tốt nhất.
import copy

def predict(model, X):
    # Tính p(tích cực) cho mỗi bài trong X, mỗi lần 1.000 bài
    probabilities = []
    with torch.no_grad():
        for start in range(0, X.shape[0], 1000):
            scores = model(frequencies(X[start:start + 1000]))
            probabilities.append(torch.sigmoid(scores[:, 0]))
    return torch.cat(probabilities)

def accuracy(model, X, labels):
    right = (predict(model, X) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

y_train = torch.tensor(train_labels, dtype=torch.float32)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_function = nn.BCEWithLogitsLoss()   # sigmoid + entropy chéo
batch_size = 64
best_accuracy = 0
for epoch in range(5):
    order = torch.randperm(len(y_train)).tolist()   # xáo trộn
    for start in range(0, len(order), batch_size):
        batch = order[start:start + batch_size]
        scores = model(frequencies(X_train[batch]))[:, 0]
        loss = loss_function(scores, y_train[batch])
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    val_accuracy = accuracy(model, X_val, val_labels)
    print(f"epoch {epoch + 1}: "
          f"validation accuracy {val_accuracy:.3f}")
    if val_accuracy > best_accuracy:
        best_accuracy, best_epoch = val_accuracy, epoch + 1
        best_model = copy.deepcopy(model)


# (4) Đo độ chính xác trên tập kiểm tra của mô hình tốt nhất
test_accuracy = accuracy(best_model, X_test, test_labels)
print(f"\ntest accuracy, epoch {best_epoch}: {test_accuracy:.3f}")


# (5) Chạy mô hình tốt nhất trên các bài đánh giá khó như ở bài 3.4
hard_texts = [review for review, label in hard_reviews]
p_positive = predict(best_model, vectorizer.transform(hard_texts))

names = ["negative", "positive"]
print("\nlabel     p(positive)  right  review")
right_count = 0
for (review, label), p in zip(hard_reviews, p_positive.tolist()):
    right = (p > 0.5) == (label == 1)
    if right:
        right_count += 1
    mark = "yes" if right else "NO"
    short = review if len(review) <= 36 else review[:35] + "…"
    print(f"{names[label]:9} {p:.3f}        {mark:5}  {short}")
print(f"\n{right_count} right out of {len(hard_reviews)}")
epoch 1: validation accuracy 0.890
epoch 2: validation accuracy 0.894
epoch 3: validation accuracy 0.883
epoch 4: validation accuracy 0.882
epoch 5: validation accuracy 0.879

test accuracy, epoch 2: 0.881

label     p(positive)  right  review
positive  0.000        NO     Not bad at all, actually.
negative  0.003        yes    Nothing about this movie is good.
positive  0.015        NO     I wouldn't call it a masterpiece, b…
negative  0.000        yes    Great acting, great lighting and a …
positive  0.063        NO     The first hour is slow and the dial…
negative  0.994        NO     Everyone told me it would be the fi…
negative  0.990        NO     Wow, what a masterpiece. Two hours …
negative  0.870        NO     Brilliant. Another sequel nobody as…
positive  0.043        NO     I expected it to be terrible, but i…
negative  0.043        yes    I expected it to be great, but it w…
positive  1.000        yes    Excellent movie, awesome soundtrack.
positive  1.000        yes    Superb film, wonderful score.
positive  0.999        yes    A flabbergasting, mesmerizing tour …

6 right out of 13
88,1%: mạng lấy trung bình sâu hoàn toàn không vượt qua được mô hình túi từ cổ điển (87,6% với số đếm thuần túy, 88,4% với TF-IDF). Nhóm tác giả Iyyer và cộng sự cũng ghi nhận kết quả tương tự trên IMDB khi khởi tạo biểu diễn nhúng ngẫu nhiên từ đầu: 88,8% cho mạng DAN, và 88,9% nếu bỏ luôn các tầng ẩn. Với 20.000 bài đánh giá có nhãn, mô hình hồi quy logistic ở mục 3 đã có đủ dữ liệu để học trực tiếp một trọng số cho từng từ, nên các tầng ẩn phi tuyến hầu như không đóng góp thêm được gì. Trên tập câu đánh giá khó, mạng DAN mắc lại đúng những sai lầm của túi từ vì nó cũng bỏ qua hoàn toàn trật tự từ. Điểm khác biệt là nó tỏ ra tự tin thái quá vào các dự đoán sai của mình: câu “Not bad at all, actually.” nhận xác suất tích cực là 0,000 thay vì 0,335. Trong câu ngắn chỉ có 5 từ này, chữ “bad” chiếm tới một phần năm (20%) trọng lượng của vector trung bình, trong khi ở một bài đánh giá IMDB điển hình dài 178 từ, mỗi từ chỉ đóng góp khoảng 0,6%. Lấy trung bình các vector nhúng được học từ đầu thực chất chỉ là một mô hình túi từ trá hình.
4.4 Biểu diễn nhúng suy cho cùng vẫn là biểu diễn của từ
Tính đến lúc này, chúng ta đã huấn luyện được hai ma trận nhúng trên hai tác vụ khác nhau. Thế nhưng bản thân các từ vựng ở hai bài toán vẫn là một: chữ “superb” trong một bài viết Wikipedia hay trong một bài đánh giá phim thì đều mang cùng một ý nghĩa như nhau, nên lẽ tự nhiên ta có thể kỳ vọng vector nhúng của nó ở hai mô hình phải có nét tương đồng. Hãy thử đem hai ma trận nhúng này ra đối chiếu.
Bài tập 4.4 So sánh các biểu diễn nhúng học được từ hai tác vụ
Hãy in ra 5 từ láng giềng gần nhất của sáu từ ở bài tập 4.2 (“three”, “he”, “city”, “film”, “excellent” và “terrible”) trong ma trận nhúng của mạng lấy trung bình sâu ở bài tập 4.3, tính theo độ tương đồng cosine. Hãy so sánh chúng với các từ láng giềng tìm được từ mô hình ngôn ngữ ở bài tập 4.2.
Đoạn mã khởi đầu huấn luyện lại mạng DAN của bài tập 4.3 (kết hợp bước 1–2 của lời giải bài 3.2 và bước 1–3 của lời giải bài 4.3): mô hình ở epoch tốt nhất được lưu trong biến best_model. Mã khởi đầu không chạy lại mô hình ngôn ngữ của bài tập 4.2: bạn hãy lấy danh sách láng giềng từ kết quả bạn đã làm ở bài tập 4.2, hoặc xem trong phần lời giải của bài đó.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ trong mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Biểu thức chính quy coi mọi chuỗi chữ cái
# hoặc chữ số là một từ, kể cả từ chỉ gồm một chữ cái như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# (1) Chuyển các vector đếm thành vector tần suất: chia số đếm
# cho tổng số từ của bài đánh giá. X.toarray() tạo mảng numpy từ
# các hàng của ma trận thưa: chỉ xử lý từng nhóm hàng mỗi lần vì
# chuyển toàn bộ cùng lúc sẽ tốn hàng gigabyte bộ nhớ.
# [Sao chép từ lời giải bài 4.3, bước (1)]
import torch

def frequencies(X):
    counts = torch.tensor(X.toarray(), dtype=torch.float32)
    lengths = counts.sum(dim=1, keepdim=True)
    return counts / lengths


# (2) Xây dựng mạng nơ-ron. Tầng đầu tiên (không có hệ số chệch)
# nhân vector tần suất với ma trận W kích thước D x V: kết quả là
# trung bình cộng các vector nhúng của các từ trong bài đánh giá.
# Tiếp theo là hai tầng ẩn và một điểm số đầu ra.
# [Sao chép từ lời giải bài 4.3, bước (2)]
from torch import nn

V = X_train.shape[1]   # kích thước từ vựng
D = 100   # kích thước vector nhúng
H = 100   # kích thước các tầng ẩn
torch.manual_seed(0)
model = nn.Sequential(
    nn.Linear(V, D, bias=False),   # trung bình các vector nhúng
    nn.Linear(D, H),
    nn.ReLU(),
    nn.Linear(H, H),
    nn.ReLU(),
    nn.Linear(H, 1),   # p(tích cực) = sigmoid(điểm số)
)


# (3) Huấn luyện bằng Adam trên từng lô 64 bài đánh giá với hàm
# mất mát entropy chéo cho hai lớp. Sau mỗi epoch, đo độ chính xác
# trên tập xác thực và lưu bản sao của mô hình tốt nhất.
# [Sao chép từ lời giải bài 4.3, bước (3)]
import copy

def predict(model, X):
    # Tính p(tích cực) cho mỗi bài trong X, mỗi lần 1.000 bài
    probabilities = []
    with torch.no_grad():
        for start in range(0, X.shape[0], 1000):
            scores = model(frequencies(X[start:start + 1000]))
            probabilities.append(torch.sigmoid(scores[:, 0]))
    return torch.cat(probabilities)

def accuracy(model, X, labels):
    right = (predict(model, X) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

y_train = torch.tensor(train_labels, dtype=torch.float32)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_function = nn.BCEWithLogitsLoss()   # sigmoid + entropy chéo
batch_size = 64
best_accuracy = 0
for epoch in range(5):
    order = torch.randperm(len(y_train)).tolist()   # xáo trộn
    for start in range(0, len(order), batch_size):
        batch = order[start:start + batch_size]
        scores = model(frequencies(X_train[batch]))[:, 0]
        loss = loss_function(scores, y_train[batch])
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    val_accuracy = accuracy(model, X_val, val_labels)
    print(f"epoch {epoch + 1}: "
          f"validation accuracy {val_accuracy:.3f}")
    if val_accuracy > best_accuracy:
        best_accuracy, best_epoch = val_accuracy, epoch + 1
        best_model = copy.deepcopy(model)
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
epoch 1: validation accuracy 0.890
epoch 2: validation accuracy 0.894
epoch 3: validation accuracy 0.883
epoch 4: validation accuracy 0.882
epoch 5: validation accuracy 0.879
Hint
Tầng đầu tiên của mạng ở bài tập 4.3 lưu trữ trực tiếp ma trận với mỗi cột là một từ: best_model[0].weight có kích thước . Thuộc tính vectorizer.vocabulary_ cho biết chỉ số cột của một từ, và vectorizer.get_feature_names_out() trả về từ tương ứng với mỗi chỉ số.
Hint
Hãy chia mỗi cột của ma trận cho độ dài Euclid của chính cột đó: khi ấy, độ tương đồng cosine giữa một từ với toàn bộ các từ còn lại sẽ thu được chỉ qua một phép nhân vector với ma trận, tương tự như ở bài tập 4.2.
Điểm kiểm tra kết quả bạn cần đạt được
Các láng giềng gần nhất của “excellent” toàn là những từ khen ngợi (“wonderfully”, “perfectly”, “refreshing”, cùng điểm số “7”), còn láng giềng của “terrible” toàn là những từ chê bai (“poorly”, “worst”, “awful”). Ngược lại, các láng giềng của bốn từ trung tính “three”, “he”, “city” và “film” trông hoàn toàn ngẫu nhiên.
three: rising, resources, relies, avoid, appears
he: two, imaginative, life, out, many
city: passing, romantic, filled, epic, carry
film: own, reward, northam, 10, hudson
excellent: 7, wonderfully, perfectly, refreshing, rare
terrible: poorly, worst, awful, annoying, waste
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Tách 5.000 bài đánh giá huấn luyện làm tập xác thực, và
# thay thế các thẻ xuống dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ trong mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Biểu thức chính quy coi mọi chuỗi chữ cái
# hoặc chữ số là một từ, kể cả từ chỉ gồm một chữ cái như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# (1) Chuyển các vector đếm thành vector tần suất: chia số đếm
# cho tổng số từ của bài đánh giá. X.toarray() tạo mảng numpy từ
# các hàng của ma trận thưa: chỉ xử lý từng nhóm hàng mỗi lần vì
# chuyển toàn bộ cùng lúc sẽ tốn hàng gigabyte bộ nhớ.
# [Sao chép từ lời giải bài 4.3, bước (1)]
import torch

def frequencies(X):
    counts = torch.tensor(X.toarray(), dtype=torch.float32)
    lengths = counts.sum(dim=1, keepdim=True)
    return counts / lengths


# (2) Xây dựng mạng nơ-ron. Tầng đầu tiên (không có hệ số chệch)
# nhân vector tần suất với ma trận W kích thước D x V: kết quả là
# trung bình cộng các vector nhúng của các từ trong bài đánh giá.
# Tiếp theo là hai tầng ẩn và một điểm số đầu ra.
# [Sao chép từ lời giải bài 4.3, bước (2)]
from torch import nn

V = X_train.shape[1]   # kích thước từ vựng
D = 100   # kích thước vector nhúng
H = 100   # kích thước các tầng ẩn
torch.manual_seed(0)
model = nn.Sequential(
    nn.Linear(V, D, bias=False),   # trung bình các vector nhúng
    nn.Linear(D, H),
    nn.ReLU(),
    nn.Linear(H, H),
    nn.ReLU(),
    nn.Linear(H, 1),   # p(tích cực) = sigmoid(điểm số)
)


# (3) Huấn luyện bằng Adam trên từng lô 64 bài đánh giá với hàm
# mất mát entropy chéo cho hai lớp. Sau mỗi epoch, đo độ chính xác
# trên tập xác thực và lưu bản sao của mô hình tốt nhất.
# [Sao chép từ lời giải bài 4.3, bước (3)]
import copy

def predict(model, X):
    # Tính p(tích cực) cho mỗi bài trong X, mỗi lần 1.000 bài
    probabilities = []
    with torch.no_grad():
        for start in range(0, X.shape[0], 1000):
            scores = model(frequencies(X[start:start + 1000]))
            probabilities.append(torch.sigmoid(scores[:, 0]))
    return torch.cat(probabilities)

def accuracy(model, X, labels):
    right = (predict(model, X) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

y_train = torch.tensor(train_labels, dtype=torch.float32)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_function = nn.BCEWithLogitsLoss()   # sigmoid + entropy chéo
batch_size = 64
best_accuracy = 0
for epoch in range(5):
    order = torch.randperm(len(y_train)).tolist()   # xáo trộn
    for start in range(0, len(order), batch_size):
        batch = order[start:start + batch_size]
        scores = model(frequencies(X_train[batch]))[:, 0]
        loss = loss_function(scores, y_train[batch])
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    val_accuracy = accuracy(model, X_val, val_labels)
    print(f"epoch {epoch + 1}: "
          f"validation accuracy {val_accuracy:.3f}")
    if val_accuracy > best_accuracy:
        best_accuracy, best_epoch = val_accuracy, epoch + 1
        best_model = copy.deepcopy(model)
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
epoch 1: validation accuracy 0.890
epoch 2: validation accuracy 0.894
epoch 3: validation accuracy 0.883
epoch 4: validation accuracy 0.882
epoch 5: validation accuracy 0.879
# (1) Các láng giềng gần nhất của những từ ở bài 4.2. Tầng đầu tiên
# của mạng lưu giữ nguyên ma trận W: cột i là vector nhúng của từ i.
# Chia mỗi cột cho độ dài của nó để tích vô hướng là độ tương đồng cosine.
words = vectorizer.get_feature_names_out()   # theo thứ tự của W
W = best_model[0].weight.detach()   # kích thước D x V
W = W / W.norm(dim=0, keepdim=True)

for word in ["three", "he", "city", "film", "excellent", "terrible"]:
    i = vectorizer.vocabulary_[word]   # chỉ số của từ
    similarities = W[:, i] @ W   # mỗi từ một độ tương đồng
    ranking = similarities.argsort(descending=True).tolist()
    nearest = [words[j] for j in ranking[1:6]]   # [0]: chính từ đó
    print(f"{word}: {', '.join(nearest)}")
three: rising, resources, relies, avoid, appears
he: two, imaginative, life, out, many
city: passing, romantic, filled, epic, carry
film: own, reward, northam, 10, hudson
excellent: 7, wonderfully, perfectly, refreshing, rare
terrible: poorly, worst, awful, annoying, waste
Hai ma trận nhúng giống như hai bức ảnh âm bản đối lập nhau hoàn toàn! Mạng lấy trung bình sâu trên IMDB chỉ học duy nhất thứ mà bài toán phân tích cảm xúc cần đến: một từ mang sắc thái tích cực hay tiêu cực. Nó biết rất rõ rằng “excellent” giống với “wonderfully” và “terrible” giống với “awful” — điều mà mô hình ngôn ngữ trên Wikipedia trước đó đã bỏ lỡ. Thế nhưng những từ như “three”, “he”, “city” và “film” vốn chẳng tiết lộ điều gì về khen hay chê, nên quá trình huấn luyện không có bất kỳ động lực nhất quán nào để sắp xếp các vector nhúng của chúng, khiến các từ láng giềng của chúng trở nên hỗn độn ngẫu nhiên. Mô hình ngôn ngữ ở bài 4.2 thì làm điều ngược lại hoàn toàn: nó sắp xếp rất ngăn nắp các từ phổ biến của Wikipedia theo ngữ pháp và chủ đề, nhưng lại bỏ mặc các tính từ khen chê hiếm gặp chìm trong nhiễu loạn. Một biểu diễn nhúng được học trực tiếp từ một tác vụ cụ thể sẽ chỉ nắm bắt những khía cạnh mà tác vụ đó cần, giới hạn trong phạm vi dữ liệu của tác vụ đó.
Đây chính là giới hạn cốt tử của việc học biểu diễn nhúng từ đầu đi kèm với từng tác vụ riêng lẻ. Một tập dữ liệu có gán nhãn thường có quy mô nhỏ, và nó chỉ dạy cho mô hình đúng những gì tác vụ nhãn đó đòi hỏi: 20.000 bài đánh giá phim là đủ để phân biệt từ khen với từ chê, nhưng hoàn toàn không đủ để dạy cho máy biết rằng “film” (bộ phim) có họ hàng gần với “book” (cuốn sách). Trong khi đó, ý nghĩa thực sự của từ ngữ trong ngôn ngữ vốn dĩ đâu có phụ thuộc vào tác vụ! Việc cứ phải học lại từ đầu các biểu diễn nhúng phản ánh cấu trúc ngôn ngữ cho mỗi bài toán mới, chỉ từ một nhúm dữ liệu gán nhãn ít ỏi, rõ ràng là một sự lãng phí lớn.
Sẽ ra sao nếu chúng ta có thể học các biểu diễn nhúng một lần dùng mãi mãi trên một tác vụ có nguồn dữ liệu dồi dào miễn phí, rồi sau đó tái sử dụng chúng cho vô số tác vụ khác nhau? Bài tập 4.2 đã gợi mở cho chúng ta nơi để tìm kiếm một tác vụ như vậy: bài toán dự đoán một từ dựa vào ngữ cảnh xung quanh nó chỉ cần văn bản thô chưa gán nhãn — thứ có sẵn ngập tràn trên mạng — và chính bài toán đó đã tự khắc dạy cho mô hình ngôn ngữ của chúng ta biết rằng “three” đi cùng nhóm với “four”, còn “film” gần gũi với “book”. Đó chính là tư tưởng cốt lõi của tiền huấn luyện (pre-training) và học chuyển giao (transfer learning), cũng là chủ đề của mục tiếp theo.
Nếu bạn muốn đào sâu hơn, dưới đây là một số bài tập mở rộng.
Kích thước ngữ cảnh. Hãy huấn luyện mô hình ngôn ngữ nơ-ron ở bài tập 4.2 với ngữ cảnh gồm 1, 2 và 5 từ đứng trước, rồi vẽ biểu đồ perplexity trên tập xác thực theo , đặt cạnh đường cong của các mô hình n-gram nội suy ở bài tập 2.3b. Liệu mô hình mạng nơ-ron có tận dụng các ngữ cảnh dài hiệu quả hơn không?
Các ngữ cảnh chưa từng gặp. Hãy đo perplexity của mô hình ngôn ngữ nơ-ron và của mô hình 4-gram nội suy, nhưng chỉ tính riêng trên những vị trí từ trong tập xác thực mà cụm 3 từ đứng ngay trước nó chưa từng xuất hiện cùng nhau trong văn bản huấn luyện. Mô hình nào bị ảnh hưởng nặng nề hơn?
Pha trộn hai mô hình. Giống như cách Bengio và cộng sự đã làm trong bài báo gốc, hãy lấy trung bình cộng hai phân phối xác suất dự đoán bởi mô hình ngôn ngữ nơ-ron và mô hình 5-gram nội suy (mỗi mô hình trọng số 0,5). Độ hỗn loạn (perplexity) cải thiện được bao nhiêu? Tại sao hai mô hình này lại bổ trợ tốt cho nhau?
Sinh văn bản. Hãy dùng mô hình ngôn ngữ nơ-ron vừa huấn luyện để sinh ra một đoạn văn bản mới, giống như bạn đã làm với các mô hình n-gram ở bài tập 2.3a. Liệu nó có sao chép nguyên văn các câu trong tập huấn luyện như mô hình 5-gram không?
Bỏ các tầng ẩn. Hãy loại bỏ các tầng ẩn khỏi mạng lấy trung bình sâu ở bài tập 4.3. Theo chứng minh ở mục 4.3, mô hình khi đó thu gọn về đúng bài toán hồi quy logistic trên tần suất từ. Hãy kiểm tra thực nghiệm xem nó có đạt độ chính xác tương đương với mô hình túi từ ở mục 3 hay không.
Trung bình có trọng số. Hãy nhân trọng số IDF của từng từ (mục 3.3) khi tính trung bình cộng các vector nhúng ở bài tập 4.3. Độ chính xác trên tập kiểm tra có thay đổi không? Còn kết quả dự đoán trên tập câu đánh giá khó thì sao?
Cấu trúc phủ định trong túi từ. Với sáu tính từ (ba tính từ tích cực và ba tính từ tiêu cực), hãy so sánh xác suất mà mô hình túi từ ở bài tập 3.2 gán cho hai câu “The movie was X.” và “The movie was not X.”. Hãy kiểm tra xem có đúng là từ “not” luôn làm dịch chuyển điểm số logit của mọi câu đi cùng một lượng không đổi hay không. Liệu mạng lấy trung bình sâu ở bài tập 4.3 có làm tốt hơn chút nào không?
5. Tiền huấn luyện biểu diễn nhúng: word2vec và GloVe
Ở cuối mục 4, chúng ta đã nhận thấy rằng một biểu diễn nhúng được học trực tiếp cho một tác vụ cụ thể chỉ nắm bắt những gì tác vụ đó cần, trong phạm vi dữ liệu của tác vụ đó. Đồng thời, bài tập 4.2 cũng đã gợi mở cho chúng ta hướng giải quyết: dù chỉ được huấn luyện để dự đoán từ tiếp theo trong các bài viết Wikipedia, mô hình ngôn ngữ của Bengio đã tự khám phá ra rằng “three” giống với “four” và “film” gần gũi với “book”.
5.1 Tách quá trình huấn luyện làm hai giai đoạn
Ý tưởng cốt lõi rất đơn giản: chia quá trình huấn luyện thành hai giai đoạn tách biệt. Trước hết, hãy học ma trận nhúng trên một tác vụ có nguồn dữ liệu dồi dào và miễn phí: giai đoạn này được gọi là tiền huấn luyện (pre-training). Sau đó, sao chép ma trận vừa học được sang mô hình của bài toán thực tế mà ta quan tâm — được gọi là tác vụ xuôi dòng / tác vụ đích (downstream task) — rồi tiếp tục huấn luyện mô hình này trên tập dữ liệu có gán nhãn của riêng nó. Văn bản thô thì cực kỳ rẻ và sẵn có: có hàng tỷ từ trên Wikipedia và các trang tin tức trực tuyến mà chẳng cần ai phải ngồi gán nhãn thủ công. Ngược lại, nhãn dữ liệu (labels) lại rất đắt đỏ: phải có con người đọc từng bài đánh giá phim và phân định xem bài đó khen hay chê.
Vì vậy, hãy tạm gác bài toán phân loại cảm xúc sang một bên và tập trung hoàn toàn vào việc học các biểu diễn nhúng. Vấn đề đặt ra là: để máy có thể học được biểu diễn nhúng, chúng ta cần một hàm mục tiêu để tối ưu hóa! Ta cần một tác vụ giả lập mà hàm mất mát của nó có thể tính toán hoàn toàn chỉ từ văn bản thô.
Câu trả lời đến từ ngành ngôn ngữ học, và nó có tuổi đời còn lâu hơn cả máy tính điện tử: những từ thường xuất hiện trong các ngữ cảnh giống nhau thì có xu hướng mang ý nghĩa tương đồng nhau. Đây được gọi là giả thuyết phân phối (distributional hypothesis). Năm 1954, nhà ngôn ngữ học Zellig Harris đã viết rằng “sự khác biệt về ý nghĩa có tương quan chặt chẽ với sự khác biệt về phân phối xuất hiện” (Harris, 1954), và đến năm 1957, John Firth đã đúc kết nguyên lý này bằng một câu nói bất hủ: “Bạn sẽ hiểu được một từ thông qua những từ thường đi cùng với nó!” (“You shall know a word by the company it keeps!”) (Firth, 1957).
Do đó, một mô hình được huấn luyện để dự đoán một từ dựa vào ngữ cảnh xung quanh, hoặc ngược lại dự đoán ngữ cảnh từ từ trung tâm, sẽ có mọi lý do để gán những vector gần nhau cho những từ có nghĩa tương đồng. Đó chính xác là những gì đã diễn ra trong bài tập 4.2. Thế nhưng mô hình của Bengio lại quá chậm chạp: gần như toàn bộ thời gian tính toán của nó đều bị ngốn vào phép tính hàm softmax trên toàn bộ từ vựng (xem mục “Chi phí tính toán của tầng Softmax” ở phần 4.2). Đến năm 2013, thuật toán word2vec đã giữ lại trọn vẹn ý tưởng cốt lõi đó, đồng thời mạnh tay cắt bỏ mọi thành phần đắt đỏ gây nghẽn cổ chai.
5.2 Word2vec
Word2vec là tên gọi chung của hai kiến trúc mô hình do Tomas Mikolov và các đồng nghiệp tại Google đề xuất (Mikolov et al., 2013). Cả hai mô hình đều xét một cửa sổ trượt gồm các từ nằm xung quanh một từ trung tâm (center/middle word):
- CBOW (viết tắt của Continuous Bag of Words — Túi từ liên tục): dự đoán từ ở chính giữa dựa trên trung bình cộng các vector nhúng của các từ ngữ cảnh bao quanh nó;
- Skip-gram làm điều ngược lại: từ vector nhúng của từ ở chính giữa, dự đoán từng từ ngữ cảnh xuất hiện xung quanh nó.
Cả hai mô hình đều loại bỏ hoàn toàn tầng ẩn phi tuyến. Có thể hình dung CBOW chính là mô hình của Bengio sau khi đã rút bỏ tầng ẩn, mở rộng ngữ cảnh sang cả hai phía trái-phải của từ trung tâm, và thay phép ghép nối bằng phép lấy trung bình cộng. Còn Skip-gram thì đảo chiều mũi tên dự đoán. Chính sự tối giản triệt để này đã mang lại tốc độ đáng kinh ngạc cho chúng: đi từ các vector nhúng đến điểm số của các từ chỉ tốn đúng một phép nhân ma trận với vector.
Hãy viết tường minh công thức toán học của mô hình skip-gram. Để huấn luyện mô hình này, ta cần học hai ma trận và . Trong đó, là ma trận nhúng từ trung tâm (kích thước , giống như ở mục 4.1) gán một vector nhúng (cột thứ của ) cho mỗi từ . Còn là ma trận chiếu đầu ra (kích thước ) ở tầng tuyến tính cuối, có thể hiểu như việc cung cấp thêm một vector ngữ cảnh (hàng thứ của ) cho mỗi từ ứng viên đầu ra .
Khi đó, xác suất để từ ngữ cảnh xuất hiện xung quanh từ trung tâm được mô hình hóa bằng hàm softmax trên các tích vô hướng:
và mô hình được huấn luyện như thường lệ bằng cách cực tiểu hóa hàm mất mát entropy chéo trên toàn bộ các cặp (từ trung tâm, từ ngữ cảnh xung quanh) trích ra từ văn bản huấn luyện.
Thế nhưng mẫu số của công thức trên vẫn là một tổng chạy qua toàn bộ từ trong bộ từ vựng: chi phí đắt đỏ của hàm softmax vẫn chưa hề biến mất! Bài báo thứ hai về word2vec (Mikolov, Sutskever, et al., 2013) đã giải quyết triệt để nút thắt này bằng một thủ thuật sắc sảo mang tên lấy mẫu âm (negative sampling). Thay vì bắt mô hình trả lời câu hỏi lớn “trong số từ của từ vựng, từ nào xuất hiện xung quanh ?”, bài toán được chuyển thành câu hỏi nhị phân Đúng/Sai đơn giản hơn rất nhiều: “cặp từ này là một cặp từ thật trích từ văn bản, hay là một cặp từ giả do tạo ngẫu nhiên?”. Cụ thể, ứng với mỗi cặp từ thật , ta rút ngẫu nhiên từ nhiễu từ bộ từ vựng để tạo thành cặp từ giả , rồi huấn luyện một bộ phân loại hồi quy logistic (mục 3.2) để phân biệt cặp thật với các cặp giả, sử dụng chính tích vô hướng của hai vector làm điểm số (logit):
Vì tính chất đối xứng của hàm sigmoid là , số hạng đầu tiên chính là hàm mất mát entropy chéo nhị phân ở mục 3.2 cho một cặp mang nhãn 1 (cặp thật), và mỗi số hạng trong tổng phía sau ứng với một cặp mang nhãn 0 (cặp giả). Với , mỗi cặp từ huấn luyện chỉ tốn đúng 6 phép tính tích vô hướng, thay vì phải tính tích vô hướng với toàn bộ 33.277 từ của WikiText-2! Các từ giả (mẫu âm) được lấy mẫu theo phân phối tần số đếm của từ nâng lên lũy thừa — một mẹo thực nghiệm giúp các từ hiếm có cơ hội được chọn làm mẫu âm cao hơn một chút so với tần suất tự nhiên của chúng.
Còn một thủ thuật cuối cùng nữa: lấy mẫu con các từ phổ biến (subsampling). Những hư từ xuất hiện dày đặc như “the” có mặt trong cửa sổ ngữ cảnh của hầu hết mọi từ, và chẳng cung cấp được mấy thông tin hữu ích. Vì vậy, trước khi ghép các cặp từ huấn luyện, mỗi lần xuất hiện của một từ có tần suất tương đối sẽ bị loại bỏ ngẫu nhiên với xác suất , trong đó là một ngưỡng hằng số (thường chọn khoảng trong bài báo gốc). Trên tập WikiText-2, nếu chọn , chỉ khoảng 4% số lần xuất hiện của từ “the” được giữ lại, trong khi toàn bộ các từ có tần suất dưới đều được giữ nguyên 100%. Đây một lần nữa chính là trực giác đằng sau trọng số IDF ở mục 3.3: một từ xuất hiện ở khắp mọi nơi thì mang rất ít thông tin.
Đọc thêm Softmax phân cấp (Hierarchical softmax): một con đường khác để né chi phí tính softmax trên toàn bộ từ vựng
Bài báo đầu tiên của word2vec đã tránh việc tính tổng softmax trên toàn bộ từ vựng theo một cách khác. Toàn bộ các từ trong bộ từ vựng được sắp xếp làm các nút lá của một cây nhị phân, được xây dựng sao cho các từ xuất hiện thường xuyên nằm gần nút gốc hơn (cây mã hóa Huffman). Để tính xác suất cho một từ, mô hình đi dọc theo đường dẫn từ nút gốc xuống tới nút lá của từ đó; tại mỗi nút nhánh trên đường đi, một bộ hồi quy logistic nhị phân sẽ quyết định xác suất rẽ trái hay rẽ phải. Xác suất cuối cùng của từ ở nút lá chính là tích các xác suất rẽ nhánh dọc theo đường đi. Một đường đi trên cây chỉ dài khoảng nút: tức chỉ cần tính khoảng 15 phép hồi quy logistic cho bộ từ vựng 33.277 từ, thay vì phải tính toàn bộ 33.277 điểm số. Tuy nhiên, kỹ thuật lấy mẫu âm (negative sampling) ở bài báo thứ hai — vốn đơn giản và nhanh hơn — đã dần thay thế hoàn toàn phương pháp này trong thực tế.
Bây giờ, hãy tự tay huấn luyện mô hình skip-gram kết hợp lấy mẫu âm trên tập dữ liệu WikiText-2 — chính là văn bản mà chúng ta đã dùng để huấn luyện mô hình của Bengio ở bài tập 4.2 — rồi đặt hai mô hình lên bàn cân so sánh.
Bài tập 5.2 Huấn luyện word2vec trên WikiText-2
Hãy huấn luyện một mô hình skip-gram với kỹ thuật lấy mẫu âm trên văn bản huấn luyện của WikiText-2. Trước hết, hãy lọc bớt các từ phổ biến bằng kỹ thuật lấy mẫu con (subsampling) với ngưỡng , sau đó ghép mỗi từ còn lại với 2 từ đứng trước nó và 2 từ đứng sau nó. Ứng với mỗi cặp từ thật, hãy lấy mẫu 5 từ ngữ cảnh giả theo phân phối tần số đếm nâng lên lũy thừa . Huấn luyện các vector nhúng có kích thước trong 3 epoch, sau đó in ra 5 từ láng giềng gần nhất của sáu từ ở bài tập 4.2 (“three”, “he”, “city”, “film”, “excellent” và “terrible”). Hãy so sánh danh sách các từ láng giềng cũng như thời gian huấn luyện với mô hình của Bengio ở bài tập 4.2.
Đoạn mã khởi đầu xây dựng chuỗi văn bản huấn luyện theo bước (1) trong lời giải bài tập 2.1, và gán cho mỗi từ trong từ vựng một chỉ số nguyên giống như ở mã khởi đầu của bài tập 4.2.
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Gán một chỉ số (index) cho mỗi từ trong từ vựng
# [Sao chép từ mã khởi đầu bài 4.2]
vocabulary = sorted(set(train_sequence))
word_index = {word: i for i, word in enumerate(vocabulary)}
text: 2051910 words
vocabulary: 33277 words
Hint
Hãy đếm tần số các từ bằng một từ điển (dictionary) như ở mục 2. Sau khi thực hiện lọc lấy mẫu con (subsampling), hãy chuyển chuỗi chỉ số từ còn lại thành một tensor sequence: khi đó sequence[:-1] và sequence[1:] sẽ ghép mỗi từ với từ đứng liền kề sau nó, còn sequence[:-2] và sequence[2:] sẽ ghép mỗi từ với từ cách nó hai vị trí. Hãy sử dụng tất cả các cặp này theo cả hai chiều (trước–sau và sau–trước).
Hint
Hãy khởi tạo hai lớp nn.Embedding(V, D): một lớp dành cho các từ trung tâm (mà các hàng của nó chính là ma trận biểu diễn nhúng ta sẽ giữ lại sau khi học xong), và một lớp dành cho các từ ngữ cảnh (chứa các vector đầu ra ). Khởi tạo cả hai ma trận với các giá trị ngẫu nhiên nhỏ bằng nn.init.normal_(..., std=0.1). Với một batch gồm các cặp từ, điểm số tích vô hướng được tính nhanh gọn bằng (center * context).sum(dim=1), trong đó cả center và context đều có kích thước (batch, D).
Hint
Hàm torch.multinomial(noise, n, replacement=True) giúp rút ngẫu nhiên chỉ số từ với xác suất tỷ lệ thuận với trọng số trong tensor noise — ở đây là số đếm tần số của từng từ nâng lên lũy thừa . Với mỗi batch, hãy ghép điểm số của mỗi cặp từ thật đặt cạnh điểm số của 5 cặp từ giả tương ứng thành một tensor có kích thước (batch, 6), đi kèm với vector nhãn mục tiêu là 1, 0, 0, 0, 0, 0. Khi đó, nn.BCEWithLogitsLoss() sẽ tính chính xác hàm mất mát của kỹ thuật lấy mẫu âm.
Hint
Hãy huấn luyện bằng thuật toán Adam (tốc độ học lr=0.003) với kích thước lô (batch size) là 4.096 cặp. Để tìm các từ láng giềng gần nhất, hãy tái sử dụng đoạn mã của bài tập 4.2 áp dụng trên ma trận nhúng của từ trung tâm.
Điểm kiểm tra kết quả bạn cần đạt được
Bước lọc lấy mẫu con giữ lại 997.693 từ trên tổng số 2.051.910 từ ban đầu, tạo ra 3.990.766 cặp từ huấn luyện. Toàn bộ quá trình huấn luyện chỉ mất khoảng 15 giây trên CPU của máy tính xách tay! Các từ láng giềng của “three” vẫn là những con số khác, và láng giềng của “film” bao gồm “cinema” và “movie”. Láng giềng của hai từ hiếm “excellent” và “terrible” vẫn trông ngẫu nhiên. Kết quả cụ thể trên máy của bạn có thể xê dịch đôi chút, đặc biệt là với các từ hiếm.
after subsampling: 997693 words
pairs: 3990766
epoch 1: loss 0.411, 5 s since the start
epoch 2: loss 0.363, 10 s since the start
epoch 3: loss 0.343, 15 s since the start

three: five, two, thirty, four, seven
he: him, she, Howson, bullpen, hurting
city: capital, Varanasi, Stepen, road, Ramallah
film: cinema, Coriolanus, movie, Magadheera, Telugu
excellent: knock, evoke, misery, hint, fun
terrible: happy, endearingly, Sometimes, hearted, bearer
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách từ ở mỗi dòng theo dấu cách
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Gán một chỉ số (index) cho mỗi từ trong từ vựng
# [Sao chép từ mã khởi đầu bài 4.2]
vocabulary = sorted(set(train_sequence))
word_index = {word: i for i, word in enumerate(vocabulary)}
text: 2051910 words
vocabulary: 33277 words
# (1) Đếm các từ rồi lấy mẫu giảm (subsample) các từ phổ biến: giữ
# lại mỗi lần xuất hiện của từ có tần suất f với xác suất sqrt(t / f),
# nhờ đó từ "the" bị lược bỏ phần lớn còn từ hiếm thì giữ nguyên
import math
import random

counts = {}
for word in train_sequence:
    if word not in counts:
        counts[word] = 0
    counts[word] += 1

t = 1e-4
random.seed(0)
kept = []   # chỉ số các từ được giữ lại theo đúng thứ tự
for word in train_sequence:
    frequency = counts[word] / len(train_sequence)
    if random.random() < math.sqrt(t / frequency):
        kept.append(word_index[word])
print(f"after subsampling: {len(kept)} words")


# (2) Tạo các cặp (từ trung tâm, từ ngữ cảnh): ghép mỗi từ trong
# chuỗi đã lọc với từng từ trong 2 từ đứng trước và 2 từ đứng sau.
# sequence[:-offset] và sequence[offset:] ghép mỗi từ với từ nằm
# cách nó offset vị trí về phía sau.
import torch

window = 2
sequence = torch.tensor(kept)
centers, contexts = [], []
for offset in range(1, window + 1):
    centers += [sequence[:-offset], sequence[offset:]]
    contexts += [sequence[offset:], sequence[:-offset]]
centers = torch.cat(centers)
contexts = torch.cat(contexts)
print(f"pairs: {len(centers)}")


# (3) Mô hình: hai ma trận nhúng, một cho các từ ở trung tâm (vector
# nhúng ta giữ lại) và một cho các từ ngữ cảnh. Điểm số của một cặp
# là tích vô hướng của hai vector tương ứng.
from torch import nn

V = len(vocabulary)
D = 100   # kích thước vector nhúng
torch.manual_seed(0)
center_embeddings = nn.Embedding(V, D)
context_embeddings = nn.Embedding(V, D)
nn.init.normal_(center_embeddings.weight, std=0.1)
nn.init.normal_(context_embeddings.weight, std=0.1)


# (4) Huấn luyện bằng Adam trên các lô 4.096 cặp thật. Với mỗi cặp
# thật, lấy mẫu k = 5 từ ngữ cảnh giả theo số đếm lũy thừa 3/4 bằng
# torch.multinomial. Hàm mất mát là entropy chéo cho hai lớp:
# 1 cho cặp thật, 0 cho cặp giả.
import time

noise = torch.tensor([counts[word] for word in vocabulary],
                     dtype=torch.float32) ** 0.75
k = 5
parameters = (list(center_embeddings.parameters())
              + list(context_embeddings.parameters()))
optimizer = torch.optim.Adam(parameters, lr=3e-3)
loss_function = nn.BCEWithLogitsLoss()   # sigmoid + entropy chéo
batch_size = 4096
start_time = time.time()
for epoch in range(3):
    order = torch.randperm(len(centers))   # xáo trộn các cặp
    for start in range(0, len(order), batch_size):
        batch = order[start:start + batch_size]
        B = len(batch)
        center = center_embeddings(centers[batch])     # (B, D)
        context = context_embeddings(contexts[batch])  # (B, D)
        fake_words = torch.multinomial(noise, B * k, replacement=True)
        fake = context_embeddings(fake_words).view(B, k, D)
        real_scores = (center * context).sum(dim=1)    # (B,)
        # center[:, None] có kích thước (B, 1, D): nhân với từng
        # ngữ cảnh giả trong k ngữ cảnh giả của cặp đó
        fake_scores = (center[:, None] * fake).sum(dim=2)  # (B, k)
        scores = torch.cat([real_scores[:, None], fake_scores], dim=1)
        labels = torch.zeros(B, 1 + k)
        labels[:, 0] = 1   # cặp thật nằm ở cột 0
        loss = loss_function(scores, labels)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    elapsed = time.time() - start_time
    print(f"epoch {epoch + 1}: loss {loss.item():.3f}, "
          f"{elapsed:.0f} s since the start")


# (5) Các láng giềng gần nhất của các từ ở bài 4.2 trong ma trận
# từ trung tâm. Chia mỗi hàng cho độ dài của nó để tích vô hướng
# trở thành độ tương đồng cosine.
embeddings = center_embeddings.weight.detach()
embeddings = embeddings / embeddings.norm(dim=1, keepdim=True)

print()
for word in ["three", "he", "city", "film", "excellent", "terrible"]:
    similarities = embeddings @ embeddings[word_index[word]]
    ranking = similarities.argsort(descending=True).tolist()
    nearest = [vocabulary[i] for i in ranking[1:6]]   # [0]: chính từ đó
    print(f"{word}: {', '.join(nearest)}")
after subsampling: 997693 words
pairs: 3990766
epoch 1: loss 0.411, 5 s since the start
epoch 2: loss 0.363, 10 s since the start
epoch 3: loss 0.343, 15 s since the start

three: five, two, thirty, four, seven
he: him, she, Howson, bullpen, hurting
city: capital, Varanasi, Stepen, road, Ramallah
film: cinema, Coriolanus, movie, Magadheera, Telugu
excellent: knock, evoke, misery, hint, fun
terrible: happy, endearingly, Sometimes, hearted, bearer
Mô hình word2vec huấn luyện xong chỉ trong vỏn vẹn 15 giây, trong khi mô hình của Bengio ngốn gần 6 phút trên cùng một văn bản và cùng một chiếc máy tính dù có ít cặp huấn luyện hơn trong mỗi epoch: tính trung bình trên mỗi cặp mẫu, word2vec nhanh hơn gấp khoảng 30 lần! Các từ láng giềng thu được mang tính chất tương tự: số đi với số, đại từ “he” đi với “him” và “she”. Tuy nhiên có một sự khác biệt thú vị về sắc thái: từ “film” giờ đây nằm gần nhất với “cinema” (điện ảnh) và “movie” (bộ phim) — tức những từ thuộc cùng trường chủ đề — trong khi mô hình của Bengio lại xếp nó cạnh “book”, “novel” và “album” — những từ đóng cùng vai trò ngữ pháp ở vị trí tiếp theo trong câu. Còn đối với các từ hiếm như “excellent” (chỉ xuất hiện 28 lần), kết quả vẫn là nhiễu: một văn bản dài 2 triệu từ là chưa đủ lớn, và đó chính là lúc tốc độ vượt trội của word2vec phát huy giá trị. Word2vec đủ nhẹ và nhanh để có thể học từ hàng tỷ từ văn bản.
5.3 GloVe
Word2vec học biểu diễn nhúng thông qua bài toán dự đoán từng cửa sổ ngữ cảnh một. Một năm sau đó, nhóm nghiên cứu tại Đại học Stanford gồm Jeffrey Pennington, Richard Socher và Christopher Manning đã quay trở lại với phương pháp đếm truyền thống (Pennington et al., 2014). Mô hình của họ, mang tên GloVe (viết tắt của Global Vectors — Vector toàn cục), trước hết duyệt qua toàn bộ kho ngữ liệu huấn luyện để đếm xem mỗi từ xuất hiện bao nhiêu lần trong cửa sổ ngữ cảnh của mỗi từ . Bước này tạo ra một ma trận đồng xuất hiện (co-occurrence matrix) có kích thước , tương tự như bảng đếm các cặp từ ở mục 2.1 nhưng mở rộng cửa sổ ra cả hai phía của từ trung tâm. Sau đó, GloVe tìm kiếm các vector từ sao cho tích vô hướng của chúng xấp xỉ trực tiếp giá trị logarit của các số đếm đồng xuất hiện này:
trong đó và là hai bộ vector biểu diễn từ (tương ứng với từ trung tâm và từ ngữ cảnh giống như trong skip-gram), còn và là các số hạng độ chệch (biases) vô hướng. Các vector này được khớp bằng phương pháp bình phương tối thiểu có trọng số (weighted least squares), trong đó mỗi cặp được nhân với một hàm trọng số phụ thuộc vào số đếm : những cặp từ hiếm gặp (vốn có số đếm nhiều nhiễu) sẽ nhận trọng số nhỏ hơn, đồng thời hàm trọng số cũng được chặn trần không tăng nữa khi số lần đồng xuất hiện vượt quá 100 nhằm ngăn không cho các cặp hư từ quá phổ biến lấn át toàn bộ hàm mục tiêu. Giống như phương pháp Phân tích Ngữ nghĩa Tiềm ẩn (LSA) ở mục 4.1, GloVe nén một bảng đếm khổng lồ thành các vector đặc chỉ gồm vài trăm chiều.
Vậy rốt cuộc phương pháp nào ưu việt hơn: dự đoán (như word2vec) hay đếm toàn cục (như GloVe)? Ngay trong năm 2014, Omer Levy và Yoav Goldberg đã chứng minh một kết quả lý thuyết bất ngờ rằng hai trường phái này thực chất gần gũi với nhau hơn vẻ bề ngoài rất nhiều (Levy & Goldberg, 2014). Hãy xét mô hình skip-gram với kỹ thuật lấy mẫu âm sử dụng cặp từ giả cho mỗi cặp từ thật. Nếu số chiều của không gian nhúng đủ lớn, hàm mất mát của mô hình này đạt giá trị cực tiểu toàn cục khi tích vô hướng giữa vector từ trung tâm và vector từ ngữ cảnh thỏa mãn phương trình:
trong đó là xác suất để từ xuất hiện trong cửa sổ ngữ cảnh của từ , còn và là tần suất xuất hiện độc lập của hai từ đó. Đại lượng logarit ở số hạng đầu tiên chính là thông tin tương hỗ điểm (Pointwise Mutual Information — PMI) giữa hai từ: nó đo lường xem hai từ xuất hiện cùng nhau thường xuyên gấp bao nhiêu lần so với trường hợp chúng hoàn toàn độc lập thống kê với nhau. Giá trị PMI rất cao đối với cặp từ “ice” và “cold”, nhưng lại xấp xỉ bằng 0 đối với cặp “ice” và “the”. Như vậy, dù không bao giờ xây dựng bảng đếm trong bộ nhớ, mô hình word2vec về bản chất vẫn đang thực hiện phân rã ma trận (matrix factorization) trên một bảng thống kê đồng xuất hiện — giống hệt như cái đích của GloVe và LSA! Dự đoán ngữ cảnh cục bộ và đếm thống kê ngữ cảnh toàn cục suy cho cùng đều hội tụ về gần như cùng một bài toán toán học.
Đọc thêm Nguồn gốc công thức PMI: chứng minh nghiệm tối ưu của lấy mẫu âm chỉ trong ba dòng biến đổi
Hãy xét một từ trung tâm và một từ ngữ cảnh cố định, đồng thời đặt ẩn phụ . Trong tổng hàm mất mát của kỹ thuật lấy mẫu âm tính trên toàn bộ văn bản huấn luyện, cặp xuất hiện với tư cách là một cặp từ thật đúng lần (số lần từ nằm trong cửa sổ của từ ). Bên cạnh đó, nó cũng xuất hiện với tư cách là một cặp từ giả: mỗi lần trong tổng số cặp từ thật của , thuật toán rút ra từ giả, và từ được rút trúng với xác suất , tức trung bình khoảng lần. Do đó, thành phần trong tổng hàm mất mát phụ thuộc riêng vào biến có dạng:
Lấy đạo hàm của biểu thức này theo , ta được . Cho đạo hàm bằng 0, ta giải ra ngay . Thay các tần suất tương đối và (với là tổng số cặp từ thật trong kho ngữ liệu), đồng thời giả sử các từ giả được lấy mẫu theo đúng tần suất tự nhiên , ta thu được chính xác công thức PMI trừ đi ở trên! Nếu dùng phân phối lấy mẫu âm lũy thừa của word2vec thì mẫu số chỉ đơn giản được thay bằng phiên bản làm mượt lũy thừa tương ứng. Lưu ý rằng phép chứng minh này giả định tích vô hướng của mỗi cặp từ có thể nhận giá trị tự do độc lập nhau — điều kiện đòi hỏi số chiều của vector nhúng phải đủ lớn.
Nhóm nghiên cứu tại Stanford đã công bố rộng rãi các bộ vector GloVe được huấn luyện sẵn trên nhiều kho ngữ liệu lớn. Trong phần còn lại của mục này, chúng ta sẽ sử dụng bộ vector được huấn luyện trên 6 tỷ từ trích từ Wikipedia và các bài báo tin tức: gồm 400.000 từ viết thường trong không gian 300 chiều. Quy mô văn bản này lớn gấp 3.000 lần so với tập dữ liệu WikiText-2 của chúng ta.
5.4 Các biểu diễn nhúng nắm bắt được những thông tin gì?
Điều đầu tiên mà các biểu diễn nhúng nắm bắt được chính là độ tương đồng ngữ nghĩa: thể hiện qua danh sách các từ láng giềng gần nhất trong bài tập 4.2 và 5.2. Thế nhưng bên trong không gian vector ấy còn ẩn chứa một cấu trúc hình học đáng kinh ngạc hơn nhiều! Hãy lấy hiệu và tổng của các vector , rồi tìm xem từ nào trong từ vựng có vector nằm gần kết quả đó nhất: câu trả lời chính là “madrid”. Nói cách khác, vector hiệu gần như bằng đúng vector hiệu : tồn tại một phương hướng nhất định trong không gian nhúng mang ý nghĩa là quan hệ “thủ đô của”. Hoàn toàn tương tự, từ có vector nằm gần nhất với chính là “queen” (nữ hoàng), sau khi ta loại trừ chính từ “king” khỏi danh sách ứng viên (chúng ta sẽ bàn kỹ hơn về chi tiết thú vị này trong bài tập 5.4).
Tính chất hình học này mở ra một phương pháp đại số để giải các câu đố loại suy (analogies) dạng ” đối với thì cũng như đối với ?”: chỉ cần tìm từ có vector nằm gần nhất với vector mục tiêu . Mikolov và cộng sự đã biến bài toán này thành một bộ tiêu chuẩn (benchmark) để đánh giá chất lượng của các biểu diễn nhúng (Mikolov, Chen, et al., 2013): gồm 19.544 câu hỏi loại suy chia làm 14 danh mục, bao quát cả về mặt ngữ nghĩa (thủ đô, đơn vị tiền tệ, quan hệ gia đình) lẫn về mặt ngữ pháp (số nhiều, thì của động từ, so sánh hơn/nhất). Hãy cùng thử nghiệm bộ câu hỏi này trên các vector GloVe. Giống như thiết lập trong một số thí nghiệm của bài báo word2vec đầu tiên, chúng ta sẽ chỉ giữ lại 30.000 từ phổ biến nhất làm không gian tìm kiếm cho cả câu hỏi lẫn câu trả lời.
Bài tập 5.4 Giải bài toán loại suy (analogies) bằng GloVe
Hãy tìm câu trả lời cho 5 phép loại suy sau: “man đối với king thì cũng như woman đối với ?”, “france đối với paris thì cũng như spain đối với ?”, “big đối với bigger thì cũng như small đối với ?”, “walk đối với walked thì cũng như swim đối với ?” và “man đối với doctor thì cũng như woman đối với ?”. Với mỗi câu, hãy tìm từ có vector GloVe gần nhất với theo hai cách: đầu tiên là loại trừ cả ba từ nằm trong đề bài khỏi tập ứng viên trả lời, sau đó là cho phép trả lời bằng chính các từ trong đề bài. Tiếp theo, hãy đo độ chính xác trên toàn bộ bộ dữ liệu kiểm tra loại suy của Mikolov và cộng sự theo cả hai cách, tách riêng kết quả cho nhóm câu hỏi ngữ nghĩa (meaning) và nhóm câu hỏi ngữ pháp (grammar).
# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản lưu của
# sentence-transformers trên Hub: 400.000 từ viết thường, sắp xếp
# từ phổ biến nhất đến ít phổ biến nhất, kích thước 300 chiều.
# Hàng 0 của tệp là token đệm (padding): bỏ qua hàng này.
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]

# Giữ lại 30.000 từ phổ biến nhất
words = glove_words[:30000]
vectors = glove_vectors[:30000]
word_index = {word: i for i, word in enumerate(words)}

# Tập kiểm tra phép loại suy của Mikolov và cộng sự: mỗi dòng có
# dạng "Word1 đối với Word2 như Word3 đối với Word4", và Subject
# là nhóm chủ đề của nó
from datasets import load_dataset

analogies = load_dataset("almogtavor/google-analogy-dataset")["train"]

print(f"GloVe: {len(words)} words, vectors of size {vectors.shape[1]}")
print(f"test set: {len(analogies)} analogies")
print(f"example: {analogies[0]}")
GloVe: 30000 words, vectors of size 300
test set: 19544 analogies
example: {'Word1': 'Athens', 'Word2': 'Greece', 'Word3': 'Baghdad', 'Word4': 'Iraq', 'Subject': 'capital-common-countries'}
Hint
Trước tiên, hãy chuẩn hóa mỗi vector trong từ vựng bằng cách chia cho độ dài Euclid của nó, để phép nhân tích vô hướng cho ra trực tiếp độ tương đồng cosine. Lưu ý rằng vector mục tiêu không cần phải chia chuẩn hóa độ dài: việc chia nó cho một hằng số dương không làm thay đổi thứ tự xếp hạng của các từ ứng viên.
Hint
Biểu thức vectors @ target sẽ tính cùng lúc tích vô hướng của vector mục tiêu với toàn bộ 30.000 vector từ vựng. Để loại trừ một từ khỏi danh sách ứng viên, bạn chỉ cần gán điểm số của từ đó bằng -math.inf trước khi gọi hàm tìm vị trí lớn nhất argmax.
Hint
Các từ trong bộ dữ liệu kiểm tra loại suy có chứa chữ viết hoa (“Athens”, “Greece”), trong khi bộ từ vựng GloVe chỉ chứa chữ viết thường: hãy chuyển tất cả về chữ thường (.lower()). Bỏ qua những câu hỏi có bất kỳ từ nào nằm ngoài 30.000 từ phổ biến nhất. Các danh mục kiểm tra về ngữ pháp là những dòng có trường Subject bắt đầu bằng tiền tố "gram".
Điểm kiểm tra kết quả bạn cần đạt được
Khi loại trừ các từ trong đề bài, 5 câu trả lời thu được lần lượt là “queen”, “madrid”, “larger” (một lỗi sai thú vị thay vì “smaller”), “swam” và “physician”; độ chính xác trên toàn bộ tập kiểm tra đạt 79,2% ở phần ngữ nghĩa và 70,6% ở phần ngữ pháp. Ngược lại, khi cho phép trả lời bằng các từ có trong đề bài, 3 trong số 5 câu hỏi trả về chính một từ nằm trong câu hỏi (bắt đầu bằng việc trả về “king” thay vì “queen”), và độ chính xác toàn cục tụt dốc thảm hại xuống chỉ còn 24,8% ở phần ngữ nghĩa và 20,7% ở phần ngữ pháp. Có 14.877 câu trên tổng số 19.544 câu hỏi có đủ cả bốn từ nằm trong nhóm 30.000 từ phổ biến nhất.
question                           excluded   allowed
man is to king as woman is to      queen      king
france is to paris as spain is to  madrid     madrid
big is to bigger as small is to    larger     larger
walk is to walked as swim is to    swam       swim
man is to doctor as woman is to    physician  doctor

question words excluded:
  meaning: 4754 right out of 6002 (79.2%)
  grammar: 6262 right out of 8875 (70.6%)

question words allowed:
  meaning: 1491 right out of 6002 (24.8%)
  grammar: 1834 right out of 8875 (20.7%)
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản lưu của
# sentence-transformers trên Hub: 400.000 từ viết thường, sắp xếp
# từ phổ biến nhất đến ít phổ biến nhất, kích thước 300 chiều.
# Hàng 0 của tệp là token đệm (padding): bỏ qua hàng này.
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]

# Giữ lại 30.000 từ phổ biến nhất
words = glove_words[:30000]
vectors = glove_vectors[:30000]
word_index = {word: i for i, word in enumerate(words)}

# Tập kiểm tra phép loại suy của Mikolov và cộng sự: mỗi dòng có
# dạng "Word1 đối với Word2 như Word3 đối với Word4", và Subject
# là nhóm chủ đề của nó
from datasets import load_dataset

analogies = load_dataset("almogtavor/google-analogy-dataset")["train"]

print(f"GloVe: {len(words)} words, vectors of size {vectors.shape[1]}")
print(f"test set: {len(analogies)} analogies")
print(f"example: {analogies[0]}")
GloVe: 30000 words, vectors of size 300
test set: 19544 analogies
example: {'Word1': 'Athens', 'Word2': 'Greece', 'Word3': 'Baghdad', 'Word4': 'Iraq', 'Subject': 'capital-common-countries'}
# (1) Đáp án cho "a đối với b như c đối với ?": từ có vector gần
# nhất với b - a + c. Chia mỗi vector cho độ dài của nó để tích vô
# hướng với vector mục tiêu xếp hạng các từ theo độ tương đồng
# cosine. Với exclude=True, không cho phép trả lời bằng 3 từ đề bài.
import math
vectors = vectors / vectors.norm(dim=1, keepdim=True)
def answer(a, b, c, exclude):
target = (vectors[word_index[b]] - vectors[word_index[a]]
+ vectors[word_index[c]])
similarities = vectors @ target # mỗi từ một điểm số
if exclude:
for word in [a, b, c]:
similarities[word_index[word]] = -math.inf
return words[similarities.argmax()]
questions = [("man", "king", "woman"), ("france", "paris", "spain"),
("big", "bigger", "small"), ("walk", "walked", "swim"),
("man", "doctor", "woman")]
print(f"{'question':34} excluded allowed")
for a, b, c in questions:
question = f"{a} is to {b} as {c} is to"
print(f"{question:34} {answer(a, b, c, True):10} "
f"{answer(a, b, c, False)}")
# (2) Độ chính xác trên tập kiểm tra cho các câu hỏi có cả bốn từ
# nằm trong 30.000 từ phổ biến nhất. Các chủ đề có tên bắt đầu bằng
# "gram" thuộc về ngữ pháp (số nhiều, thì...), các chủ đề còn lại
# thuộc về ngữ nghĩa (thủ đô, tiền tệ, gia đình...).
for exclude in [True, False]:
right = {"meaning": 0, "grammar": 0}
total = {"meaning": 0, "grammar": 0}
for row in analogies:
a, b, c, d = [row[f"Word{i}"].lower() for i in range(1, 5)]
if not all(word in word_index for word in [a, b, c, d]):
continue
kind = "grammar" if row["Subject"].startswith("gram") \
else "meaning"
total[kind] += 1
if answer(a, b, c, exclude) == d:
right[kind] += 1
print(f"\nquestion words {'excluded' if exclude else 'allowed'}:")
for kind in ["meaning", "grammar"]:
print(f" {kind}: {right[kind]} right out of {total[kind]} "
f"({right[kind] / total[kind]:.1%})")
question                           excluded   allowed
man is to king as woman is to      queen      king
france is to paris as spain is to  madrid     madrid
big is to bigger as small is to    larger     larger
walk is to walked as swim is to    swam       swim
man is to doctor as woman is to    physician  doctor

question words excluded:
  meaning: 4754 right out of 6002 (79.2%)
  grammar: 6262 right out of 8875 (70.6%)

question words allowed:
  meaning: 1491 right out of 6002 (24.8%)
  grammar: 1834 right out of 8875 (20.7%)
GloVe trả lời đúng khoảng ba trên bốn câu hỏi loại suy dù không hề được huấn luyện chuyên biệt cho tác vụ này: toàn bộ quá trình học của nó chỉ là khớp logarit số đếm của các cặp từ! Các câu hỏi về ngữ nghĩa trong bộ dữ liệu chủ yếu xoay quanh kiến thức địa lý, bởi tên thủ đô và các bang của Hoa Kỳ chiếm tới 85% số câu hỏi trong nhóm này. Nhưng bây giờ hãy nhìn vào cột kết quả thứ hai. Khi các từ trong đề bài được phép xuất hiện ở câu trả lời, ứng viên gần nhất hầu hết lại chính là một trong các từ của câu hỏi: “man đối với king thì cũng như woman đối với… king”! Thực tế là vector vẫn nằm gần vector hơn bất kỳ từ nào khác trong từ vựng, bởi khoảng cách dịch chuyển nhỏ bé giữa “man” và “woman” chẳng thấm vào đâu so với khoảng cách ngăn cách từ “king” với phần còn lại của từ vựng. Trên toàn bộ tập kiểm tra, nếu bỏ quy tắc loại trừ này, độ chính xác rơi thẳng đứng từ 74% xuống còn 22%. “Queen” thực chất không phải là từ gần nhất với biểu thức : nó chỉ là từ gần nhất sau khi ta đã cấm mô hình trả lời là “king”.
Đây là lưu ý quan trọng đầu tiên khi nói về phép loại suy vector: thuật toán tìm kiếm loại suy bắt buộc phải loại trừ các từ nằm trong câu hỏi, nếu không trong đa số trường hợp nó sẽ chỉ lặp lại một trong các từ của đề bài. Quy tắc loại trừ ngầm này đã có mặt ngay từ bài báo word2vec đầu tiên và được giữ nguyên trong hầu hết các nghiên cứu đánh giá kể từ đó. Thế nhưng quy tắc này cũng vô tình ép mô hình phải chọn một từ khác bằng mọi giá, ngay cả khi câu trả lời hợp lý nhất chính là một từ đã có trong câu hỏi! Trong bài tập vừa rồi, câu hỏi “man đối với doctor thì cũng như woman đối với ?” trả về “physician” (thầy thuốc) khi áp dụng luật cấm, và trả về đúng “doctor” (bác sĩ) khi gỡ bỏ luật cấm đó. Hãy luôn ghi nhớ chi tiết kỹ thuật này mỗi khi bạn đọc thấy những tuyên bố nổi tiếng kiểu như biểu diễn nhúng trả lời câu “đàn ông đối với lập trình viên máy tính thì cũng như phụ nữ đối với người nội trợ (homemaker)” (Bolukbasi et al., 2016).
Lưu ý quan trọng thứ hai: ý nghĩa nằm ở các phương hướng (directions), chứ không nằm ở từng trục tọa độ riêng lẻ (coordinates). Chúng ta rất dễ nảy sinh ý muốn đi tìm xem chiều tọa độ thứ bao nhiêu trong vector nhúng mã hóa giới tính, hay chiều tọa độ nào mã hóa tính chất hoàng gia. Thế nhưng hãy nhìn lại hàm mất mát của cả word2vec lẫn GloVe: chúng chỉ phụ thuộc duy nhất vào các tích vô hướng giữa các vector, mà tích vô hướng thì hoàn toàn bất biến nếu ta quay đồng thời toàn bộ không gian vector đi cùng một góc bất kỳ! Một bộ vector nhúng sau khi bị quay bằng một phép biến đổi trực giao vẫn tối ưu hàm mất mát tốt y hệt như bộ vector gốc, dù giá trị số ở từng tọa độ của nó đã thay đổi hoàn toàn. Do đó, một tọa độ đơn lẻ tự thân nó không mang ý nghĩa cố định nào cả: chỉ có các phương hướng tương đối — chẳng hạn như vector hiệu — mới mang ý nghĩa. Mạng nơ-ron của Hinton ở mục 4.1 thì khác: mỗi nút ở tầng ẩn đi qua hàm kích hoạt phi tuyến của riêng nó, nên một phép quay không gian sẽ làm thay đổi đầu ra của mạng. Ở kiến trúc đó, các trục tọa độ có vai trò đặc biệt và mỗi nút đơn lẻ có thể tự gắn với một khái niệm riêng.
5.5 Học chuyển giao (Transfer learning)
Bây giờ, hãy quay trở lại với các bài đánh giá phim IMDB của chúng ta. Trong tay ta hiện đã có bộ biểu diễn nhúng được học từ 6 tỷ từ văn bản, và kiến trúc mạng lấy trung bình sâu (DAN) ở mục 4.3 lại bắt đầu bằng chính một ma trận nhúng: ta hoàn toàn có thể chép các vector GloVe vào làm ma trận khởi tạo cho mạng này! Đây chính là học chuyển giao (transfer learning): tri thức học được từ một tác vụ này (ở đây là bài toán khớp số đếm các cặp từ trên kho ngữ liệu lớn) được chuyển giao và tái sử dụng cho một tác vụ khác (phân loại bài đánh giá phim). Có hai chiến lược phổ biến để thực hiện việc này:
- đóng băng (freeze) các biểu diễn nhúng: giữ cố định hoàn toàn ma trận , và chỉ huấn luyện các tầng ẩn cùng đầu phân loại trên tập bài đánh giá có nhãn;
- tinh chỉnh (fine-tune) các biểu diễn nhúng: khởi tạo bằng các vector GloVe, nhưng cho phép quá trình huấn luyện trên các bài đánh giá tiếp tục cập nhật và dịch chuyển chúng giống như mọi tham số khác của mạng.
Khi đóng băng biểu diễn nhúng, mạng giữ lại trọn vẹn mọi tri thức học được từ 6 tỷ từ văn bản, bao gồm cả thông tin về những từ rất hiếm khi xuất hiện (hoặc thậm chí không hề xuất hiện) trong tập bài đánh giá huấn luyện. Như ta đã phân tích ở mục 4.3, khi cố định, tác động của mỗi từ lên đầu phân loại phụ thuộc trực tiếp vào vị trí vector nhúng của nó, nhờ vậy những từ đồng nghĩa sẽ tự động được xử lý giống nhau. Ngược lại, khi tinh chỉnh (fine-tune), các biểu diễn nhúng có thể linh hoạt thích nghi với bài toán phân tích cảm xúc, nhưng chỉ những từ có xuất hiện trong tập huấn luyện mới được dịch chuyển, còn những từ vắng mặt sẽ đứng yên tại vị trí cũ. Hãy cùng so sánh cả hai chiến lược này với phương pháp huấn luyện từ đầu ở mục 4.3.
Bài tập 5.5a Khởi tạo mạng lấy trung bình sâu từ GloVe
Hãy xây dựng ma trận nhúng cho mạng lấy trung bình sâu của bài tập 4.3 từ các vector GloVe của 10.000 từ trong bộ từ vựng (). Hãy huấn luyện mạng theo ba chế độ: với khởi tạo ngẫu nhiên (huấn luyện từ đầu — from scratch), với sao chép từ GloVe và đóng băng (frozen), và với sao chép từ GloVe và tinh chỉnh (fine-tuned). Hãy so sánh độ chính xác trên tập kiểm tra của cả ba mô hình. Sau đó, hãy in ra 5 từ láng giềng gần nhất của hai từ “good” và “bad” trong bộ vector GloVe gốc, và trong ma trận sau khi đã tinh chỉnh trên IMDB.
Đoạn mã khởi đầu lặp lại bước (1) và (2) trong lời giải bài tập 3.2 (chia dữ liệu và đếm từ), đồng thời nạp sẵn toàn bộ các vector GloVe giống như ở mã khởi đầu của bài tập 5.4. Kiến trúc mạng không được viết sẵn trong mã khởi đầu: bạn hãy lấy từ mã nguồn bài tập 4.3 của mình.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ của mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Mẫu biểu thức coi mỗi chuỗi chữ cái hoặc
# chữ số là một từ, kể cả một chữ cái đơn như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản sao của
# sentence-transformers trên Hub: 400.000 từ chữ thường, xếp từ
# phổ biến nhất đến ít phổ biến nhất, 300 chiều.
# Hàng 0 của tệp là token đệm: bỏ hàng này đi.
# [Sao chép từ phần khởi đầu bài 5.4]
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
Hint
Phương thức vectorizer.get_feature_names_out() trả về danh sách các từ trong bộ từ vựng theo đúng thứ tự cột của vector đếm. Hãy tạo ma trận dưới dạng một tensor kích thước , đặt vector GloVe của từ thứ vào cột thứ , rồi chép nó vào tầng đầu tiên của mạng bằng lệnh model[0].weight.data = W_glove.clone(). Một vài mảnh từ bị cắt lẻ như "hadn" không có mặt trong từ điển GloVe: cứ để nguyên cột của chúng bằng 0.
Hint
Để đóng băng ma trận , hãy gọi model[0].weight.requires_grad_(False): PyTorch sẽ bỏ qua không tính đạo hàm cho ma trận này. Khi khởi tạo bộ tối ưu hóa (optimizer), chỉ truyền vào những tham số thực sự cần huấn luyện: [p for p in model.parameters() if p.requires_grad].
Hint
Ở bài tập 5.5b tiếp theo, chúng ta sẽ huấn luyện chính mạng này trên các tập con nhỏ hơn của dữ liệu đánh giá (giảm xuống tới mức chỉ còn 100 bài). Để chuẩn bị sẵn cho bài đó, bạn nên viết một hàm train(model, X, labels) thực hiện rút ngẫu nhiên từng batch gồm 64 bài đánh giá từ X (dùng torch.randint) trong 1.500 batch liên tiếp, và lưu lại bản sao mô hình có độ chính xác xác thực cao nhất (đo sau mỗi 100 batch).
Điểm kiểm tra kết quả bạn cần đạt được
Độ chính xác trên tập kiểm tra đạt 87,6% khi huấn luyện từ đầu, 83,3% khi dùng GloVe đóng băng, và 88,1% khi dùng GloVe có tinh chỉnh. Trong không gian GloVe gốc, từ láng giềng gần nhất của “bad” lại chính là… “good”! Nhưng sau khi được tinh chỉnh trên dữ liệu đánh giá phim, 5 láng giềng gần nhất của “bad” đã chuyển thành “worse”, “unfortunately”, “awful”, “nothing” và “worst”.
12 words without a GloVe vector: ['feinstone', 'gypo', 'hackenstein', 'hadn', 'imho']
from scratch  test accuracy 0.876
frozen        test accuracy 0.833
fine-tuned    test accuracy 0.881

good, GloVe:      better, really, always, you, well
good, fine-tuned: really, always, you, better, think
bad, GloVe:      good, things, worse, thing, because
bad, fine-tuned: worse, unfortunately, awful, nothing, worst
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ của mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Mẫu biểu thức coi mỗi chuỗi chữ cái hoặc
# chữ số là một từ, kể cả một chữ cái đơn như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản sao của
# sentence-transformers trên Hub: 400.000 từ chữ thường, xếp từ
# phổ biến nhất đến ít phổ biến nhất, 300 chiều.
# Hàng 0 của tệp là token đệm: bỏ hàng này đi.
# [Sao chép từ phần khởi đầu bài 5.4]
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
# (1) Ma trận nhúng tiền huấn luyện: cột j là vector GloVe của từ j
# trong từ vựng, theo thứ tự của các vector đếm. Một vài từ mà
# GloVe không biết sẽ giữ nguyên cột toàn số 0.
import torch

glove_index = {word: i for i, word in enumerate(glove_words)}
vocabulary = vectorizer.get_feature_names_out()
D = glove_vectors.shape[1]   # 300
W_glove = torch.zeros(D, len(vocabulary))
missing = []
for j, word in enumerate(vocabulary):
    if word in glove_index:
        W_glove[:, j] = glove_vectors[glove_index[word]]
    else:
        missing.append(word)
print(f"{len(missing)} words without a GloVe vector: {missing[:5]}")


# (2) Mạng trung bình sâu ở bài 4.3, với D = 300. Tầng đầu tiên là W:
# ngẫu nhiên (từ đầu), hoặc dùng vector GloVe giữ cố định (đóng băng)
# hay huấn luyện cùng phần còn lại (tinh chỉnh).
from torch import nn

def frequencies(X):
    counts = torch.tensor(X.toarray(), dtype=torch.float32)
    lengths = counts.sum(dim=1, keepdim=True)
    return counts / lengths

def make_model(embeddings):
    torch.manual_seed(0)
    model = nn.Sequential(
        nn.Linear(len(vocabulary), D, bias=False),   # trung bình
        nn.Linear(D, 100),
        nn.ReLU(),
        nn.Linear(100, 100),
        nn.ReLU(),
        nn.Linear(100, 1),   # p(positive) = sigmoid(score)
    )
    if embeddings != "from scratch":
        model[0].weight.data = W_glove.clone()
    if embeddings == "frozen":
        model[0].weight.requires_grad_(False)   # không tính đạo hàm
    return model


# (3) Hàm huấn luyện mô hình qua 1.500 lô gồm 64 bài đánh giá lấy
# ngẫu nhiên từ tập huấn luyện. Sau mỗi 100 lô, đo độ chính xác xác
# thực và giữ lại bản sao của mô hình tốt nhất.
import copy

def predict(model, X):
    # p(positive) cho mỗi bài đánh giá trong X, mỗi lần 1.000 bài
    probabilities = []
    with torch.no_grad():
        for start in range(0, X.shape[0], 1000):
            scores = model(frequencies(X[start:start + 1000]))
            probabilities.append(torch.sigmoid(scores[:, 0]))
    return torch.cat(probabilities)

def accuracy(model, X, labels):
    right = (predict(model, X) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

def train(model, X, labels, n_batches=1500):
    y = torch.tensor(labels, dtype=torch.float32)
    trained = [p for p in model.parameters() if p.requires_grad]
    optimizer = torch.optim.Adam(trained, lr=1e-3)
    loss_function = nn.BCEWithLogitsLoss()
    best_accuracy = 0
    for step in range(1, n_batches + 1):
        batch = torch.randint(len(y), (64,)).tolist()
        scores = model(frequencies(X[batch]))[:, 0]
        loss = loss_function(scores, y[batch])
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        if step % 100 == 0:
            val_accuracy = accuracy(model, X_val, val_labels)
            if val_accuracy > best_accuracy:
                best_accuracy = val_accuracy
                best_model = copy.deepcopy(model)
    return best_model


# (4) Huấn luyện ba phiên bản và đo độ chính xác trên tập kiểm tra
models = {}
for embeddings in ["from scratch", "frozen", "fine-tuned"]:
    models[embeddings] = train(make_model(embeddings),
                               X_train, train_labels)
    test_accuracy = accuracy(models[embeddings], X_test, test_labels)
    print(f"{embeddings:12}  test accuracy {test_accuracy:.3f}")


# (5) Các láng giềng gần nhất của "good" và "bad" trong từ vựng,
# trên GloVe và trên W sau khi tinh chỉnh
def neighbors(W, word, n=5):
    W = W / W.norm(dim=0, keepdim=True).clamp(min=1e-8)
    similarities = W[:, vectorizer.vocabulary_[word]] @ W
    ranking = similarities.argsort(descending=True).tolist()
    return [vocabulary[j] for j in ranking[1:n + 1]]   # [0]: chính từ đó

W_tuned = models["fine-tuned"][0].weight.detach()
print()
for word in ["good", "bad"]:
    print(f"{word}, GloVe:      {', '.join(neighbors(W_glove, word))}")
    print(f"{word}, fine-tuned: {', '.join(neighbors(W_tuned, word))}")
12 words without a GloVe vector: ['feinstone', 'gypo', 'hackenstein', 'hadn', 'imho']
from scratch  test accuracy 0.876
frozen        test accuracy 0.833
fine-tuned    test accuracy 0.881

good, GloVe:      better, really, always, you, well
good, fine-tuned: really, always, you, better, think
bad, GloVe:      good, things, worse, thing, because
bad, fine-tuned: worse, unfortunately, awful, nothing, worst
Khi có sẵn tới 20.000 bài đánh giá có nhãn, việc tiền huấn luyện hầu như chẳng giúp ích được bao nhiêu: GloVe có tinh chỉnh chỉ nhỉnh hơn huấn luyện từ đầu vỏn vẹn 0,5 điểm phần trăm, còn GloVe đóng băng thậm chí lại tụt hậu hơn 4 điểm! Nhóm tác giả Iyyer và cộng sự cũng ghi nhận hiện tượng y hệt trên tập IMDB, như chúng ta sẽ thấy ngay dưới đây. Tại sao các biểu diễn nhúng đóng băng lại hoạt động kém đến vậy? Hãy nhìn vào từ láng giềng gần nhất của “bad” (tệ) trong bộ GloVe gốc: từ đứng đầu bảng lại chính là “good” (tốt)! Lý do là vì hai tính từ đối lập này xuất hiện trong những ngữ cảnh câu giống hệt nhau (“bộ phim này rất ___”, “một ý tưởng ___”), nên đối với một mô hình thống kê đồng xuất hiện từ, chúng gần như là hai anh em song sinh. Thông tin phân biệt sắc thái tích cực và tiêu cực thực chất vẫn có nằm trong các vector GloVe, nhưng nó chỉ chiếm một phần phương sai rất nhỏ so với điểm chung về mặt ngữ pháp. Quá trình tinh chỉnh (fine-tuning) đã khuếch đại sự khác biệt cảm xúc đó lên thành yếu tố chủ đạo: sau khi học trên các bài đánh giá phim, từ “bad” đã dọn về ở cạnh “worse”, “awful” và “worst” — đúng như hiện tượng mà Yoon Kim cũng từng quan sát thấy với các vector word2vec (Kim, 2014). Các biểu diễn nhúng tiền huấn luyện hiểu cấu trúc tổng quát của ngôn ngữ, chứ chưa hiểu mục tiêu đặc thù của tác vụ đích.
Trong bài báo giới thiệu mạng DAN, Iyyer và cộng sự cũng đã thực hiện phép so sánh tương tự (Iyyer et al., 2015). Hai biến thể đối chứng NBOW-RAND và DAN-RAND của họ khởi tạo từ các vector nhúng ngẫu nhiên 300 chiều thay vì dùng GloVe. Họ nhận thấy hiệu quả của tiền huấn luyện phụ thuộc rất lớn vào đặc điểm của từng bộ dữ liệu. Trên các bộ dữ liệu gồm những câu ngắn, tiền huấn luyện phát huy tác dụng rõ rệt: trên tập SST nhị phân (Stanford Sentiment Treebank (Socher et al., 2013) — gồm các câu đơn trích từ bài đánh giá phim), mạng DAN đạt 86,3% khi khởi tạo bằng GloVe so với 83,2% khi khởi tạo ngẫu nhiên; trên tập câu ngắn Rotten Tomatoes, tỷ số là 80,3% so với 77,3%. Thế nhưng trên tập IMDB, mức chênh lệch lại cực kỳ nhỏ: 89,4% so với 88,8%. Khi các bài đánh giá đều dài và có tới 25.000 nhãn huấn luyện, bản thân dữ liệu của tác vụ đích đã đủ lớn để mô hình tự học tốt biểu diễn nhúng cho những từ quan trọng ngay từ đầu.
Phân tích trên gợi ý rằng tiền huấn luyện sẽ phát huy giá trị lớn nhất khi dữ liệu gán nhãn của tác vụ đích khan hiếm. Hãy cùng kiểm chứng giả thuyết này bằng thực nghiệm.
Bài tập 5.5b★ Huấn luyện khi có ít nhãn dữ liệu hơn
Hãy huấn luyện cả ba phiên bản mô hình ở bài tập 5.5a (huấn luyện từ đầu, GloVe đóng băng, và GloVe tinh chỉnh) trên các tập con gồm 100, 300, 1.000, 3.000, 10.000 và 20.000 bài đánh giá huấn luyện được lấy mẫu ngẫu nhiên, sau đó vẽ biểu đồ so sánh độ chính xác trên tập kiểm tra theo số lượng bài đánh giá có nhãn.
Đoạn mã khởi đầu lặp lại các bước từ (1) đến (3) trong lời giải của bài tập 5.5a (cùng phần mã nền của bài 3.2 và 5.4). Nó cung cấp sẵn ma trận W_glove, hàm make_model để tạo một trong ba phiên bản mạng, và hàm train để huấn luyện mạng trên tập bài đánh giá được truyền vào. Phần việc còn lại của bạn là viết vòng lặp chạy qua các quy mô dữ liệu và vẽ biểu đồ kết quả.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ của mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Mẫu biểu thức coi mỗi chuỗi chữ cái hoặc
# chữ số là một từ, kể cả một chữ cái đơn như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản sao của
# sentence-transformers trên Hub: 400.000 từ chữ thường, xếp từ
# phổ biến nhất đến ít phổ biến nhất, 300 chiều.
# Hàng 0 của tệp là token đệm: bỏ hàng này đi.
# [Sao chép từ phần khởi đầu bài 5.4]
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]


# (1) Ma trận nhúng tiền huấn luyện: cột j là vector GloVe của từ j
# trong từ vựng, theo thứ tự của các vector đếm. Một vài từ mà
# GloVe không biết sẽ giữ nguyên cột toàn số 0.
# [Sao chép từ lời giải bài 5.5a, bước (1)]
import torch

glove_index = {word: i for i, word in enumerate(glove_words)}
vocabulary = vectorizer.get_feature_names_out()
D = glove_vectors.shape[1]   # 300
W_glove = torch.zeros(D, len(vocabulary))
missing = []
for j, word in enumerate(vocabulary):
    if word in glove_index:
        W_glove[:, j] = glove_vectors[glove_index[word]]
    else:
        missing.append(word)
print(f"{len(missing)} words without a GloVe vector: {missing[:5]}")


# (2) Mạng trung bình sâu ở bài 4.3, với D = 300. Tầng đầu tiên là W:
# ngẫu nhiên (từ đầu), hoặc dùng vector GloVe giữ cố định (đóng băng)
# hay huấn luyện cùng phần còn lại (tinh chỉnh).
# [Sao chép từ lời giải bài 5.5a, bước (2)]
from torch import nn

def frequencies(X):
    counts = torch.tensor(X.toarray(), dtype=torch.float32)
    lengths = counts.sum(dim=1, keepdim=True)
    return counts / lengths

def make_model(embeddings):
    torch.manual_seed(0)
    model = nn.Sequential(
        nn.Linear(len(vocabulary), D, bias=False),   # trung bình
        nn.Linear(D, 100),
        nn.ReLU(),
        nn.Linear(100, 100),
        nn.ReLU(),
        nn.Linear(100, 1),   # p(positive) = sigmoid(score)
    )
    if embeddings != "from scratch":
        model[0].weight.data = W_glove.clone()
    if embeddings == "frozen":
        model[0].weight.requires_grad_(False)   # không tính đạo hàm
    return model


# (3) Hàm huấn luyện mô hình qua 1.500 lô gồm 64 bài đánh giá lấy
# ngẫu nhiên từ tập huấn luyện. Sau mỗi 100 lô, đo độ chính xác xác
# thực và giữ lại bản sao của mô hình tốt nhất.
# [Sao chép từ lời giải bài 5.5a, bước (3)]
import copy

def predict(model, X):
    # p(positive) cho mỗi bài đánh giá trong X, mỗi lần 1.000 bài
    probabilities = []
    with torch.no_grad():
        for start in range(0, X.shape[0], 1000):
            scores = model(frequencies(X[start:start + 1000]))
            probabilities.append(torch.sigmoid(scores[:, 0]))
    return torch.cat(probabilities)

def accuracy(model, X, labels):
    right = (predict(model, X) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

def train(model, X, labels, n_batches=1500):
    y = torch.tensor(labels, dtype=torch.float32)
    trained = [p for p in model.parameters() if p.requires_grad]
    optimizer = torch.optim.Adam(trained, lr=1e-3)
    loss_function = nn.BCEWithLogitsLoss()
    best_accuracy = 0
    for step in range(1, n_batches + 1):
        batch = torch.randint(len(y), (64,)).tolist()
        scores = model(frequencies(X[batch]))[:, 0]
        loss = loss_function(scores, y[batch])
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        if step % 100 == 0:
            val_accuracy = accuracy(model, X_val, val_labels)
            if val_accuracy > best_accuracy:
                best_accuracy = val_accuracy
                best_model = copy.deepcopy(model)
    return best_model
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
12 words without a GloVe vector: ['feinstone', 'gypo', 'hackenstein', 'hadn', 'imho']
Hint
Hàm random.sample(range(len(train_labels)), n) giúp rút ngẫu nhiên chỉ số không trùng lặp, và X_train[chosen] sẽ trích xuất các hàng tương ứng từ ma trận đếm thưa.
Hint
Khi chỉ có 100 bài đánh giá, độ chính xác sẽ dao động khá mạnh tùy thuộc vào mẫu ngẫu nhiên rút được: hãy lấy trung bình kết quả qua 3 lần rút mẫu độc lập đối với các quy mô từ 1.000 bài trở xuống.
Hint
Ở đây chúng ta vẫn giữ nguyên tập xác thực gồm 5.000 bài đánh giá để chọn mô hình tốt nhất ở mọi quy mô huấn luyện. Lưu ý rằng thiết lập này hơi ưu ái hơn thực tế một chút: trong thực tiễn, một người chỉ kiếm được 100 bài đánh giá có nhãn thì tất nhiên cũng không thể có sẵn thêm 5.000 bài có nhãn khác để làm tập xác thực.
Điểm kiểm tra kết quả bạn cần đạt được
Khi chỉ có 100 bài đánh giá có nhãn, độ chính xác trên tập kiểm tra là 69,2% khi huấn luyện từ đầu, vọt lên 75,2% với GloVe đóng băng, và đạt 73,4% với GloVe tinh chỉnh. GloVe đóng băng là phiên bản tốt nhất ở mốc 100 bài đánh giá, còn từ mốc 300 bài trở đi thì GloVe tinh chỉnh vươn lên dẫn đầu. Ở mốc 20.000 bài đánh giá, cả huấn luyện từ đầu lẫn GloVe tinh chỉnh đều hội tụ về mức 87,5%, trong khi GloVe đóng băng dừng lại ở 83,3%. Những con số cuối này chênh lệch một chút xíu so với bài tập 5.5a do thứ tự lấy mẫu các batch không giống hệt nhau.
   100 labels, from scratch  test accuracy 0.692
   100 labels, frozen        test accuracy 0.752
   100 labels, fine-tuned    test accuracy 0.734
   300 labels, from scratch  test accuracy 0.779
   300 labels, frozen        test accuracy 0.787
   300 labels, fine-tuned    test accuracy 0.793
  1000 labels, from scratch  test accuracy 0.825
  1000 labels, frozen        test accuracy 0.810
  1000 labels, fine-tuned    test accuracy 0.832
  3000 labels, from scratch  test accuracy 0.850
  3000 labels, frozen        test accuracy 0.825
  3000 labels, fine-tuned    test accuracy 0.854
 10000 labels, from scratch  test accuracy 0.866
 10000 labels, frozen        test accuracy 0.829
 10000 labels, fine-tuned    test accuracy 0.874
 20000 labels, from scratch  test accuracy 0.875
 20000 labels, frozen        test accuracy 0.833
 20000 labels, fine-tuned    test accuracy 0.875
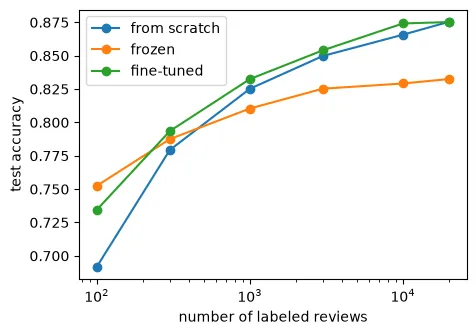
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# (2) Đếm từ của mỗi bài đánh giá trên 10.000 từ phổ biến nhất
# của tập huấn luyện. Mẫu biểu thức coi mỗi chuỗi chữ cái hoặc
# chữ số là một từ, kể cả một chữ cái đơn như "a".
# [Sao chép từ lời giải bài 3.2, bước (2)]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
X_train = vectorizer.fit_transform(train_texts)
X_val = vectorizer.transform(val_texts)
X_test = vectorizer.transform(test_texts)


# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản sao của
# sentence-transformers trên Hub: 400.000 từ chữ thường, xếp từ
# phổ biến nhất đến ít phổ biến nhất, 300 chiều.
# Hàng 0 của tệp là token đệm: bỏ hàng này đi.
# [Sao chép từ phần khởi đầu bài 5.4]
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]


# (1) Ma trận nhúng tiền huấn luyện: cột j là vector GloVe của từ j
# trong từ vựng, theo thứ tự của các vector đếm. Một vài từ mà
# GloVe không biết sẽ giữ nguyên cột toàn số 0.
# [Sao chép từ lời giải bài 5.5a, bước (1)]
import torch

glove_index = {word: i for i, word in enumerate(glove_words)}
vocabulary = vectorizer.get_feature_names_out()
D = glove_vectors.shape[1]   # 300
W_glove = torch.zeros(D, len(vocabulary))
missing = []
for j, word in enumerate(vocabulary):
    if word in glove_index:
        W_glove[:, j] = glove_vectors[glove_index[word]]
    else:
        missing.append(word)
print(f"{len(missing)} words without a GloVe vector: {missing[:5]}")


# (2) Mạng trung bình sâu ở bài 4.3, với D = 300. Tầng đầu tiên là W:
# ngẫu nhiên (từ đầu), hoặc dùng vector GloVe giữ cố định (đóng băng)
# hay huấn luyện cùng phần còn lại (tinh chỉnh).
# [Sao chép từ lời giải bài 5.5a, bước (2)]
from torch import nn

def frequencies(X):
    counts = torch.tensor(X.toarray(), dtype=torch.float32)
    lengths = counts.sum(dim=1, keepdim=True)
    return counts / lengths

def make_model(embeddings):
    torch.manual_seed(0)
    model = nn.Sequential(
        nn.Linear(len(vocabulary), D, bias=False),   # trung bình
        nn.Linear(D, 100),
        nn.ReLU(),
        nn.Linear(100, 100),
        nn.ReLU(),
        nn.Linear(100, 1),   # p(positive) = sigmoid(score)
    )
    if embeddings != "from scratch":
        model[0].weight.data = W_glove.clone()
    if embeddings == "frozen":
        model[0].weight.requires_grad_(False)   # không tính đạo hàm
    return model


# (3) Hàm huấn luyện mô hình qua 1.500 lô gồm 64 bài đánh giá lấy
# ngẫu nhiên từ tập huấn luyện. Sau mỗi 100 lô, đo độ chính xác xác
# thực và giữ lại bản sao của mô hình tốt nhất.
# [Sao chép từ lời giải bài 5.5a, bước (3)]
import copy

def predict(model, X):
    # p(positive) cho mỗi bài đánh giá trong X, mỗi lần 1.000 bài
    probabilities = []
    with torch.no_grad():
        for start in range(0, X.shape[0], 1000):
            scores = model(frequencies(X[start:start + 1000]))
            probabilities.append(torch.sigmoid(scores[:, 0]))
    return torch.cat(probabilities)

def accuracy(model, X, labels):
    right = (predict(model, X) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

def train(model, X, labels, n_batches=1500):
    y = torch.tensor(labels, dtype=torch.float32)
    trained = [p for p in model.parameters() if p.requires_grad]
    optimizer = torch.optim.Adam(trained, lr=1e-3)
    loss_function = nn.BCEWithLogitsLoss()
    best_accuracy = 0
    for step in range(1, n_batches + 1):
        batch = torch.randint(len(y), (64,)).tolist()
        scores = model(frequencies(X[batch]))[:, 0]
        loss = loss_function(scores, y[batch])
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        if step % 100 == 0:
            val_accuracy = accuracy(model, X_val, val_labels)
            if val_accuracy > best_accuracy:
                best_accuracy = val_accuracy
                best_model = copy.deepcopy(model)
    return best_model
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
12 words without a GloVe vector: ['feinstone', 'gypo', 'hackenstein', 'hadn', 'imho']
# (1) Với mỗi số lượng nhãn, huấn luyện ba phiên bản trên các tập con
# ngẫu nhiên của tập huấn luyện, lấy bằng random.sample: 3 tập con
# cho các kích thước nhỏ (vì độ chính xác dao động nhiều giữa các
# tập con) và 1 tập con cho các kích thước còn lại. Lấy trung bình
# độ chính xác kiểm tra trên các tập con.
import random

sizes = [100, 300, 1000, 3000, 10000, 20000]
versions = ["from scratch", "frozen", "fine-tuned"]
results = {version: [] for version in versions}
for n in sizes:
    n_subsets = 3 if n <= 1000 else 1
    for version in versions:
        total = 0
        for seed in range(n_subsets):
            random.seed(seed)
            chosen = random.sample(range(len(train_labels)), n)
            labels = [train_labels[i] for i in chosen]
            model = train(make_model(version), X_train[chosen], labels)
            total += accuracy(model, X_test, test_labels)
        results[version].append(total / n_subsets)
        print(f"{n:6} labels, {version:12}  "
              f"test accuracy {results[version][-1]:.3f}")


# (2) Vẽ biểu đồ độ chính xác kiểm tra theo số lượng nhãn
import matplotlib.pyplot as plt

plt.figure(figsize=(5, 3.5))
for version in versions:
    plt.plot(sizes, results[version], "o-", label=version)
plt.xscale("log")
plt.xlabel("number of labeled reviews")
plt.ylabel("test accuracy")
plt.legend()
plt.show()
   100 labels, from scratch  test accuracy 0.692
   100 labels, frozen        test accuracy 0.752
   100 labels, fine-tuned    test accuracy 0.734
   300 labels, from scratch  test accuracy 0.779
   300 labels, frozen        test accuracy 0.787
   300 labels, fine-tuned    test accuracy 0.793
  1000 labels, from scratch  test accuracy 0.825
  1000 labels, frozen        test accuracy 0.810
  1000 labels, fine-tuned    test accuracy 0.832
  3000 labels, from scratch  test accuracy 0.850
  3000 labels, frozen        test accuracy 0.825
  3000 labels, fine-tuned    test accuracy 0.854
 10000 labels, from scratch  test accuracy 0.866
 10000 labels, frozen        test accuracy 0.829
 10000 labels, fine-tuned    test accuracy 0.874
 20000 labels, from scratch  test accuracy 0.875
 20000 labels, frozen        test accuracy 0.833
 20000 labels, fine-tuned    test accuracy 0.875
Khi chỉ có vỏn vẹn 100 bài đánh giá được gán nhãn, các vector GloVe mang lại mức cải thiện quý giá lên tới 6 điểm phần trăm: 75,2% khi đóng băng so với 69,2% khi học từ đầu! Lý do rất rõ ràng: trong 100 bài đánh giá ngẫu nhiên, chỉ có khoảng 3.686 từ trên tổng số 10.000 từ của bộ từ vựng từng xuất hiện ít nhất một lần. Nếu huấn luyện từ đầu, 6.314 từ còn lại sẽ giữ nguyên vector khởi tạo ngẫu nhiên ban đầu, và mô hình hoàn toàn mù tịt khi bắt gặp chúng trong tập kiểm tra. Ngược lại, với các vector GloVe đóng băng, mọi từ trong từ vựng đều mang sẵn hành trang tri thức đúc kết từ 6 tỷ từ văn bản, nhờ đó nhận được một trọng số hợp lý gần với trọng số của những từ đồng nghĩa đã xuất hiện trong 100 bài huấn luyện. Khi số lượng nhãn tăng dần lên, khoảng cách này thu hẹp lại: từ mốc 1.000 bài đánh giá trở đi, việc đóng băng cứng nhắc trở thành phương án kém nhất, và đến mốc 20.000 bài thì việc tinh chỉnh GloVe hay học từ đầu đều cho độ chính xác ngang nhau. Tiền huấn luyện phát huy giá trị lớn nhất khi dữ liệu gán nhãn khan hiếm.
Vậy là chúng ta đã có câu trả lời đầu tiên cho câu hỏi lớn thứ hai đặt ra ở đầu bài viết: những tri thức học được từ một tác vụ có nguồn dữ liệu dồi dào hoàn toàn có thể chuyển giao sang hỗ trợ một tác vụ khác. Tuy nhiên, ở giai đoạn lịch sử này, mới chỉ có duy nhất tầng đầu tiên của mạng nơ-ron (ma trận nhúng từ) là được chuyển giao! Các tầng ẩn phía sau và đầu phân loại vẫn phải học lại từ đầu trên dữ liệu gán nhãn của từng bài toán. Hơn nữa, phép lấy trung bình cộng vẫn quên sạch trật tự từ: dù biểu diễn nhúng có tinh vi đến đâu, hai câu đánh giá khó có cùng tập từ vựng nhưng ngược nghĩa nhau vẫn nhận xác suất dự đoán giống hệt nhau. Và cuối cùng, mỗi từ trong từ điển chỉ có duy nhất một vector cố định, bất kể nó đang nằm trong câu văn nào và mang nghĩa bóng hay nghĩa đen. Mục tiếp theo sẽ cùng chúng ta nhìn nhận lại toàn diện những giới hạn này.
Nếu bạn muốn đào sâu hơn, dưới đây là một số bài tập mở rộng.
Mô hình CBOW. Hãy thay thế kiến trúc skip-gram bằng CBOW trong bài tập 5.2: lấy trung bình cộng các vector nhúng của 4 từ xung quanh mỗi vị trí, rồi tính điểm tích vô hướng của vector trung bình này với từ thật ở chính giữa cùng 5 từ giả lấy mẫu âm. Danh sách các từ láng giềng có thay đổi không?
Kích thước cửa sổ ngữ cảnh. Hãy huấn luyện lại mô hình skip-gram ở bài tập 5.2 với cửa sổ ngữ cảnh hẹp (1 từ mỗi bên) và cửa sổ ngữ cảnh rộng (10 từ mỗi bên). Tính chất của các từ láng giềng thay đổi như thế nào?
Huấn luyện trên nhiều văn bản hơn. Hãy huấn luyện mô hình skip-gram của bài tập 5.2 trên bộ dữ liệu text8 (afmck/text8) — 100 MB đầu tiên của Wikipedia tiếng Anh đã làm sạch: gồm 17 triệu từ, lớn gấp 8 lần WikiText-2. Hãy so sánh các từ láng giềng và đánh giá cả hai mô hình trên bộ dữ liệu kiểm tra loại suy của bài tập 5.4.
Đếm thay vì dự đoán. Hãy xây dựng ma trận đồng xuất hiện của WikiText-2 với cửa sổ ngữ cảnh 2 từ mỗi bên, thay thế các phần tử bằng giá trị PMI tương ứng, gán các giá trị âm về 0 (ma trận PPMI), rồi nén xuống 100 chiều bằng phép phân rã SVD rút gọn (torch.svd_lowrank), giống như thí nghiệm của Levy và Goldberg (Levy & Goldberg, 2014). Các từ láng giềng thu được có tốt ngang với kết quả của bài tập 5.2 không?
Phép quay không gian. Hãy nhân toàn bộ các vector GloVe với một ma trận trực giao ngẫu nhiên (ma trận thu được từ phép phân rã QR torch.linalg.qr trên một ma trận ngẫu nhiên). Hãy kiểm tra để thấy rằng danh sách các từ láng giềng và kết quả giải bài toán loại suy ở bài tập 5.4 hoàn toàn không thay đổi, mặc dù giá trị tại mọi trục tọa độ đều đã biến đổi.
Phương hướng biểu diễn giới tính. Hãy tính các vector hiệu , và trong không gian GloVe. Ba phương hướng này có độ tương đồng cosine với nhau cao đến mức nào? Hãy chiếu vector của một số từ chỉ nghề nghiệp lên phương trung bình của ba vector hiệu này: những nghề nghiệp nào nằm lệch về phía “woman”? Hãy đọc trước bài báo của Nissim và cộng sự (Nissim et al., 2020).
Văn bản cùng miền lĩnh vực (In-domain text). Hãy huấn luyện mô hình skip-gram của bài tập 5.2 trên 50.000 bài đánh giá phim chưa gán nhãn của bộ dữ liệu IMDB (phân tập unsupervised), rồi dùng các biểu diễn nhúng này cho bài tập 5.5a thay vì bộ vector GloVe. Liệu một lượng văn bản nhỏ hơn nhưng cùng lĩnh vực điện ảnh có đánh bại được kho văn bản tổng quát lớn gấp 3.000 lần không?
6. Điểm dừng chân: Chúng ta đang ở đâu?
Đến đây, chúng ta đã huấn luyện bốn dòng mô hình trên hai bài toán xuyên suốt: mô hình đếm n-gram, mô hình ngôn ngữ nơ-ron của Bengio, túi từ (bag of words) và mạng lấy trung bình sâu (deep averaging network). Trước khi chuyển sang các mạng nơ-ron đọc từng từ theo đúng thứ tự xuất hiện, hãy tạm dừng lại để nhìn nhận bức tranh tổng thể. Bảng dưới đây tổng hợp mô hình tốt nhất của từng dòng, cách mô hình chuyển một văn bản thành vector có kích thước cố định, phần tri thức được tái sử dụng từ bài toán khác, và điểm số đạt được trên tập kiểm tra (test set).
| Mô hình | Mục | Cách chuyển văn bản thành vector kích thước cố định | Tri thức tái sử dụng từ bài toán khác | Perplexity trên WikiText-2 | Độ chính xác trên IMDB |
|---|---|---|---|---|---|
| Mô hình 5-gram, nội suy (interpolated) | 2 | giữ lại 4 từ cuối cùng | không có | 277.7 | – |
| Túi từ (Bag of words), TF-IDF | 3 | đếm tần suất từ | không có | – | 88.4% |
| Mô hình ngôn ngữ của Bengio | 4.2 | ghép nối (concatenate) các vector nhúng (embedding) của 3 từ cuối | không có | 208.5 | – |
| Mạng lấy trung bình sâu (Deep averaging network) | 4.3 | lấy trung bình cộng các vector nhúng của các từ | không có | – | 88.1% |
| Mạng lấy trung bình sâu kết hợp GloVe | 5.5 | lấy trung bình cộng các vector nhúng của các từ | ma trận nhúng (embedding matrix), học trên 6 tỷ từ | – | 88.1% |
Ở bài toán mô hình hóa ngôn ngữ (language modeling), mỗi mô hình mới đều mang lại kết quả tốt hơn. Từ mô hình unigram (941.7) đến mô hình của Bengio, độ hỗn loạn (perplexity) đã giảm từ khoảng 1,000 xuống còn khoảng 200; mô hình của Bengio thậm chí còn vượt qua cả phương pháp làm mịn (smoothing) dựa trên tần suất đếm tốt nhất từng được công bố là Kneser-Ney với mức 219.3 (Herel & Mikolov, 2023). Tuy nhiên, tất cả các mô hình này đều dựa trên giả định ở mục 2.1: từ tiếp theo chỉ phụ thuộc vào một vài từ ngay trước đó. Các mô hình ngôn ngữ của chúng ta nhìn thấy tối đa bốn từ trong quá khứ.
Ở bài toán phân loại văn bản (classification), kết quả hầu như giẫm chân tại chỗ. Các vector nhúng đặc (dense embeddings), phép lấy trung bình, và cả các vector nhúng tiền huấn luyện (pre-trained embeddings) trên 6 tỷ từ: không phương pháp nào vượt qua được mô hình túi từ đơn giản ở mục 3. Tất cả các bộ phân loại của chúng ta đều dao động trong khoảng từ 87.6% đến 88.4%, ngoại trừ mạng lấy trung bình sâu sử dụng vector GloVe đóng băng (frozen) bị tụt xuống 83.3%. Bước tiến lớn nhất mà chúng ta từng thấy lại đến từ một hướng khác: khi Wang và Manning bổ sung các cặp từ liên tiếp (bigrams) vào túi từ, họ tăng thêm được từ 2 đến 3 điểm phần trăm, đạt tới 91.2% ở bộ phân loại tốt nhất (Wang & Manning, 2012). Như chúng ta đã thấy ở mục 3.3, một cặp từ như “not good” khôi phục lại được một phần nhỏ thông tin về trật tự từ. Trên tập dữ liệu IMDB, các cặp từ mang lại cải thiện lớn hơn cả các vector nhúng.
Tập các bài đánh giá khó ở mục 3.4 cũng phản ánh đúng thực trạng này. Mọi bộ phân loại của chúng ta đều xử lý đúng các từ đồng nghĩa và từ hiếm, nhưng không mô hình nào đoán đúng quá 4 trên 10 bài đánh giá có chứa cấu trúc phủ định (negation), tương phản (contrast), mỉa mai (sarcasm) và đảo trật tự từ (word order). Hơn nữa, mỗi mô hình đều gán cùng một xác suất cho hai bài đánh giá chứa các từ giống hệt nhau nhưng ngược nghĩa, dẫn đến việc luôn có một câu bị dự đoán sai. Dù đếm từ hay lấy trung bình các vector nhúng, các bộ phân loại của chúng ta vẫn hoàn toàn mù mờ trước thứ tự của các từ.
Vẫn còn một giới hạn nữa mà các bài đánh giá khó chưa bộc lộ hết. Trong câu “Superb film, wonderful score.” (Bộ phim tuyệt đỉnh, nhạc phim tuyệt vời), từ “score” mang nghĩa là phần âm nhạc của bộ phim. Thế nhưng trong tất cả các mô hình của chúng ta từ đầu đến giờ, mỗi từ chỉ có duy nhất một trọng số hoặc một vector cố định, bất kể nó xuất hiện trong câu nào: nhạc phim (“score” của một bộ phim) và tỷ số (“score” của một trận bóng đá) đều nhận cùng một vector nhúng. Khi một từ có nhiều nghĩa, vector của nó sẽ lưu giữ nghĩa nào? Hãy cùng kiểm tra trên GloVe.
Bài tập 6 Khám phá các nghĩa của từ đa nghĩa trong GloVe
Hãy in ra 8 láng giềng gần nhất (nearest neighbors) của các từ “bank”, “mouse”, “plot” và “score” trong số 30,000 từ phổ biến nhất của GloVe. Chúng thể hiện nghĩa nào của mỗi từ? Sau đó, hãy tìm thứ hạng (rank) của từ “river” trong số các láng giềng của “bank”, và thứ hạng của từ “soundtrack” trong số các láng giềng của “score”.
Mã khởi đầu (starter code) đã tải sẵn các vector GloVe của 30,000 từ phổ biến nhất, giống như trong bài tập 5.4.
# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản sao của
# sentence-transformers trên Hub: 400.000 từ chữ thường, xếp từ
# phổ biến nhất đến ít phổ biến nhất, 300 chiều.
# Hàng 0 của tệp là token đệm: bỏ hàng này đi.
# [Sao chép từ phần khởi đầu bài 5.4]
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]

# Giữ lại 30.000 từ phổ biến nhất
# [Sao chép từ phần khởi đầu bài 5.4]
words = glove_words[:30000]
vectors = glove_vectors[:30000]
word_index = {word: i for i, word in enumerate(words)}

print(f"GloVe: {len(words)} words, vectors of size {vectors.shape[1]}")
GloVe: 30000 words, vectors of size 300
Hint
Hãy bắt đầu giống như bài tập 5.4: chia mỗi vector cho độ dài (chuẩn Euclid) của chính nó, sao cho tích giữa ma trận chứa toàn bộ các vector với vector của một từ sẽ cho ra ngay độ tương đồng cosine (cosine similarity) của từ đó với cả 30,000 từ cùng lúc. Hàm argsort(descending=True) sẽ sắp xếp các từ theo thứ tự từ gần nhất đến xa nhất, trong đó vị trí đầu tiên chính là bản thân từ đang xét.
Hint
Thứ hạng của một từ trong số các láng giềng của một từ khác bằng 1 cộng với số lượng các từ có độ tương đồng lớn hơn nó. Biểu thức (similarities > similarities[j]).sum() sẽ đếm số lượng này, và bản thân từ gốc cũng nằm trong số đó.
Điểm kiểm tra kết quả bạn cần đạt được
Các láng giềng của “bank” đều xoay quanh lĩnh vực tài chính: “banks”, “banking”, “central”, “credit”… Các láng giềng của “mouse” pha trộn giữa loài vật (“mice”, “rat”, “rabbit”) và thiết bị máy tính (“keyboard”). Các láng giềng của “plot” nghiêng về nghĩa âm mưu (“foiled”, “assassinate”), còn của “score” lại xoay quanh các trận đấu thể thao (“scoring”, “winning”, “goal”). Từ “river” (dòng sông) chỉ đứng thứ 544 trong số các láng giềng của “bank” (ngân hàng / bờ sông), và “soundtrack” (nhạc phim) đứng thứ 146 trong số các láng giềng của “score” (tỷ số / nhạc phim), trên tổng số 29,999 từ.
bank: banks, banking, central, credit, bankers, financial, investment, lending
mouse: mice, rat, keyboard, rabbit, rodent, monkey, rats, cat
plot: plots, plotting, foiled, plotted, assassinate, conspiracy, conspirators, assassination
score: scoring, scored, scores, winning, game, goal, win, play

"river" is neighbor number 544 of "bank", out of 29999
"soundtrack" is neighbor number 146 of "score", out of 29999
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
# Các vector GloVe của Pennington và cộng sự, huấn luyện trên 6 tỷ
# từ Wikipedia và tin tức (Gigaword), từ bản sao của
# sentence-transformers trên Hub: 400.000 từ chữ thường, xếp từ
# phổ biến nhất đến ít phổ biến nhất, 300 chiều.
# Hàng 0 của tệp là token đệm: bỏ hàng này đi.
# [Sao chép từ phần khởi đầu bài 5.4]
import json

from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

repo = "sentence-transformers/average_word_embeddings_glove.6B.300d"
weights_path = hf_hub_download(
    repo, "0_WordEmbeddings/model.safetensors")
words_path = hf_hub_download(
    repo, "0_WordEmbeddings/whitespacetokenizer_config.json")
glove_vectors = load_file(weights_path)["emb_layer.weight"][1:]
glove_words = json.load(open(words_path))["vocab"][1:]

# Giữ lại 30.000 từ phổ biến nhất
# [Sao chép từ phần khởi đầu bài 5.4]
words = glove_words[:30000]
vectors = glove_vectors[:30000]
word_index = {word: i for i, word in enumerate(words)}

print(f"GloVe: {len(words)} words, vectors of size {vectors.shape[1]}")
GloVe: 30000 words, vectors of size 300
# (1) 8 láng giềng gần nhất của mỗi từ theo độ tương đồng cosine.
# Chia mỗi vector cho độ dài của nó để tích vô hướng với vector
# của một từ chính là độ tương đồng cosine với toàn bộ 30.000 từ.
vectors = vectors / vectors.norm(dim=1, keepdim=True)

def similarities_to(word):
    return vectors @ vectors[word_index[word]]   # một giá trị mỗi từ

for word in ["bank", "mouse", "plot", "score"]:
    ranking = similarities_to(word).argsort(descending=True).tolist()
    neighbors = [words[i] for i in ranking[1:9]]   # [0] là chính từ đó
    print(f"{word}: {', '.join(neighbors)}")


# (2) Thứ hạng của một từ trong các láng giềng của từ khác: một
# cộng với số từ ở gần hơn, không tính chính từ gốc
print()
for word, other in [("bank", "river"), ("score", "soundtrack")]:
    similarities = similarities_to(word)
    closer = similarities > similarities[word_index[other]]
    n_closer = closer.sum().item() - 1   # không tính chính từ gốc
    print(f'"{other}" is neighbor number {n_closer + 1} of "{word}", '
          f"out of {len(words) - 1}")
bank: banks, banking, central, credit, bankers, financial, investment, lending
mouse: mice, rat, keyboard, rabbit, rodent, monkey, rats, cat
plot: plots, plotting, foiled, plotted, assassinate, conspiracy, conspirators, assassination
score: scoring, scored, scores, winning, game, goal, win, play

"river" is neighbor number 544 of "bank", out of 29999
"soundtrack" is neighbor number 146 of "score", out of 29999
Một vector duy nhất buộc phải gánh toàn bộ các nghĩa của một từ, và nghĩa nào xuất hiện thường xuyên nhất trong văn bản huấn luyện sẽ chiếm ưu thế. GloVe được huấn luyện trên dữ liệu Wikipedia và các bài báo tin tức — nơi “bank” thường là ngân hàng giữ tiền, “plot” là một âm mưu chính trị, và “score” là tỷ số của một trận đấu. Những nét nghĩa quan trọng trong các bài đánh giá phim — như cốt truyện (“plot”) hay nhạc phim (“score”) — lại không phải là nghĩa phổ biến nhất trong kho ngữ liệu đó. Dù vậy, các nghĩa này không hề biến mất hoàn toàn: “river” vẫn gần với “bank” hơn 98% tổng số từ vựng, và “soundtrack” gần với “score” hơn 99.5% số từ. Tuy nhiên, chúng bị trộn lẫn vào chung một vector với các nghĩa khác. Khi cả hai nghĩa đều phổ biến như trường hợp của từ “mouse” (con chuột và chuột máy tính), danh sách láng giềng sẽ xuất hiện các từ thuộc cả hai nghĩa. Một vector nhúng tĩnh (static embedding) trộn lẫn tất cả các nghĩa của một từ vào làm một, và nghĩa phổ biến nhất sẽ áp đảo.
Hiện tượng một từ mang nhiều nghĩa khác nhau được gọi là hiện tượng đa nghĩa (polysemy). Để phân biệt được bờ sông (“bank of a river”) với ngân hàng giữ tiền (“bank that holds money”), mô hình bắt buộc phải nhìn vào các từ xung quanh trong cùng một câu. Ở mục 8.2, chúng ta sẽ làm quen với những vector nhúng đầu tiên có khả năng thay đổi tùy theo câu chứa từ đó — tức vector nhúng theo ngữ cảnh (contextual embeddings) — và ở mục 10.2, chúng ta sẽ trực tiếp so sánh các vector của từ “bank” trong những câu viết về dòng sông với những câu viết về tiền bạc.
Hãy quay trở lại với hai câu hỏi lớn đã đặt ra ở phần mở đầu.
Làm thế nào để xây dựng một mô hình nhận đầu vào là một đoạn văn bản có độ dài bất kỳ? Cho đến lúc này, chúng ta mới có hai kiểu câu trả lời. Hoặc chúng ta chỉ giữ lại một vài từ cuối cùng theo đúng thứ tự: cách này phù hợp với bài toán mô hình hóa ngôn ngữ, nhưng lại quên sạch mọi thông tin phía trước. Hoặc chúng ta giữ lại toàn bộ các từ nhưng vứt bỏ hoàn toàn thứ tự của chúng: cách này phù hợp để phân loại văn bản nói chung, nhưng lại thất bại trước các bài đánh giá khó. Chưa có mô hình nào của chúng ta thực sự đọc toàn bộ văn bản từ đầu đến cuối theo đúng trình tự như cách con người vẫn đọc. Đó chính là điều mà các mạng nơ-ron truy hồi (recurrent neural networks) ở mục tiếp theo sẽ thực hiện.
Làm thế nào để chuyển giao (transfer) những gì mô hình đã học được từ bài toán này sang bài toán khác? Cho đến nay, thứ duy nhất được chuyển giao mới chỉ là ma trận nhúng (embedding matrix). Việc này phát huy tác dụng rõ rệt khi dữ liệu gán nhãn khan hiếm — giúp tăng 6 điểm phần trăm độ chính xác khi chỉ có 100 bài đánh giá được gán nhãn (bài tập 5.5b) — nhưng lại không tạo ra khác biệt khi ta sử dụng toàn bộ tập nhãn. Phần xử lý phía trên các vector nhúng của bộ phân loại — nơi quyết định sự thành bại trước các bài đánh giá khó — vẫn phải học hoàn toàn từ đầu chỉ dựa vào các bài đánh giá có nhãn, và mỗi từ vẫn chỉ mang một vector cố định bất kể ngữ cảnh câu. Việc tiền huấn luyện (pre-training) toàn bộ phần còn lại của bộ mã hóa (encoder) sẽ là chủ đề của mục 8.
Nếu muốn đào sâu hơn, bạn có thể thử sức với hai bài tập mở rộng dưới đây.
Các nét nghĩa trong thế giới điện ảnh. Hãy huấn luyện mô hình skip-gram ở bài tập 5.2 trên 50,000 bài đánh giá không nhãn của tập dữ liệu IMDB (phần unsupervised), sau đó so sánh các láng giềng gần nhất của các từ “plot”, “score” và “cast” với kết quả thu được từ GloVe.
Đánh lừa mô hình. Hãy tự viết một bài đánh giá ngắn mà người đọc có thể nhận ra ngay sắc thái cảm xúc (tích cực hoặc tiêu cực), không sử dụng từ phủ định, cấu trúc tương phản hay giọng điệu mỉa mai, nhưng cả mô hình túi từ lẫn mạng lấy trung bình sâu đều dự đoán sai. Bạn đã khai thác điểm yếu nào để đánh lừa chúng?
7. Mạng nơ-ron truy hồi (Recurrent Networks): Đọc văn bản theo thứ tự
Ở cuối mục 6, chúng ta đã nhận ra rằng chưa có mô hình nào của chúng ta thực sự đọc văn bản theo đúng thứ tự từ đầu đến cuối. Các mô hình n-gram và mô hình của Bengio chỉ đọc một vài từ cuối cùng theo thứ tự rồi quên sạch mọi thứ phía trước. Ngược lại, các mô hình túi từ (bag of words) và mạng lấy trung bình (averaging networks) đọc toàn bộ các từ nhưng lại đánh mất thứ tự của chúng. Hãy xét lại hai bài đánh giá khó dưới đây:
A: I expected it to be terrible, but it was great. (Tôi cứ tưởng phim sẽ dở tệ, nhưng hóa ra lại tuyệt vời.)
B: I expected it to be great, but it was terrible. (Tôi cứ tưởng phim sẽ tuyệt vời, nhưng hóa ra lại dở tệ.)
Hai câu này chứa các từ giống hệt nhau, vì vậy mọi bộ phân loại mà chúng ta xây dựng từ đầu chương đến giờ đều gán cho chúng cùng một xác suất, và chắc chắn sẽ đoán sai một trong hai câu. Để phân biệt được hai câu này, bộ mã hóa (encoder) phải tổng hợp các vector nhúng của từ theo một cơ chế phụ thuộc vào thứ tự xuất hiện của chúng. Trước kỷ nguyên Transformer, có hai hướng tiếp cận chính để giải quyết bài toán này.
Hướng thứ nhất là phép tích chập (convolution). Hãy lấy mạng nơ-ron trong mô hình của Bengio (mục 4.2) — vốn đọc các vector nhúng đã được ghép nối của một cửa sổ gồm vài từ liên tiếp. Thay vì chỉ áp dụng mạng này vào những từ cuối cùng của văn bản, ta trượt cửa sổ đó dọc theo toàn bộ văn bản và áp dụng lên mọi vị trí. Mỗi cửa sổ sẽ tạo ra một vector nhỏ gồm các đặc trưng (features); chẳng hạn, một trong các đặc trưng này có thể kích hoạt mạnh khi bắt gặp cụm từ “was terrible”, bất kể cụm đó nằm ở đâu trong bài đánh giá. Sau đó, ứng với mỗi đặc trưng, ta chỉ giữ lại giá trị lớn nhất của nó trên toàn bộ các cửa sổ trong văn bản. Phép toán này được gọi là gộp cực đại (max pooling), giúp tạo ra một vector có kích thước cố định bất kể văn bản dài hay ngắn. Collobert và cộng sự đã sử dụng kiến trúc này để gán nhãn từ loại trong câu (Collobert et al., 2011), còn Kim dùng nó để phân loại câu.
Hướng thứ hai là mạng nơ-ron truy hồi (recurrent network). Mô hình này đọc từng từ một nối tiếp nhau giống hệt cách con người đọc, đồng thời cập nhật một vector gọi là trạng thái (state) sau mỗi từ. Trạng thái thu được sau từ cuối cùng chính là vector biểu diễn của toàn bộ văn bản.
Mạng tích chập nhìn thấy được thứ tự của các từ nằm bên trong mỗi cửa sổ, nhưng không thấy được mối liên hệ vượt ra ngoài phạm vi cửa sổ đó. Với cửa sổ 3 từ, hai cụm “was terrible” và “was great” tạo ra các đặc trưng khác nhau — chừng đó là đủ để phân biệt hai bài đánh giá mẫu của chúng ta. Tuy nhiên, một cửa sổ đơn lẻ không thể liên kết hai từ cách xa nhau hơn kích thước của nó, trừ khi ta chồng nhiều tầng tích chập lên nhau. Ngược lại, mạng nơ-ron truy hồi không bị giới hạn bởi cửa sổ trượt: về nguyên lý, trạng thái cuối cùng của nó phụ thuộc vào tất cả các từ trong văn bản cũng như thứ tự xuất hiện của chúng. Trong những năm trước khi Transformer ra đời, mạng nơ-ron truy hồi từng là bộ mã hóa tiêu chuẩn của ngành Xử lý Ngôn ngữ Tự nhiên (NLP), và đây cũng là chủ đề chính của mục này.
7.1 Mạng nơ-ron truy hồi (RNN)
Một mạng nơ-ron truy hồi (recurrent neural network – RNN) đọc lần lượt từng vector nhúng của các từ trong văn bản. Mạng duy trì một trạng thái ẩn (hidden state) — là một vector có kích thước H — và cập nhật trạng thái này sau mỗi từ theo công thức:
bắt đầu từ trạng thái khởi tạo . Ma trận (kích thước H × H), ma trận (kích thước H × D), cùng vector độ chệch (bias) được dùng chung ở mọi bước thời gian. Nhờ cơ chế chia sẻ tham số này, RNN có thể đọc văn bản có độ dài bất kỳ chỉ với một số lượng tham số cố định — tương tự như phép tích chập sử dụng cùng một bộ trọng số cửa sổ tại mọi vị trí trong câu.
Trạng thái phụ thuộc vào toàn bộ các từ đã đọc và phụ thuộc vào thứ tự của chúng: việc đọc “terrible” rồi mới đến “great” sẽ tạo ra trạng thái khác hẳn so với đọc “great” rồi mới đến “terrible”, bởi mỗi từ mới được cộng vào một trạng thái vốn đã bị biến đổi qua ma trận và hàm phi tuyến tanh ở bước trước. Vì vậy, trạng thái đóng vai trò như một bản tóm tắt có kích thước cố định H của toàn bộ phần văn bản đã đọc tính đến thời điểm , được cập nhật liên tục sau mỗi từ. Đối với bài toán phân loại văn bản, trạng thái cuối cùng chính là biểu diễn kích thước cố định của toàn bộ văn bản, và một đầu dự đoán (head) sẽ đọc vector này — chẳng hạn như bộ hồi quy logistic ở mục 3.2:
Ngoài ra, RNN còn cung cấp một vector riêng cho từng từ — chính là trạng thái ngay sau khi đọc từ thứ — đáp ứng đúng yêu cầu của bài toán gán nhãn chuỗi (tagging) ở mục 1.4: áp dụng một bộ phân loại lên từng sẽ cho ra nhãn của từng từ tương ứng. Tuy nhiên, chỉ nắm được thông tin của các từ từ đầu câu cho đến vị trí . Để phục vụ bài toán gán nhãn, người ta thường dùng thêm một mạng RNN thứ hai đọc văn bản theo chiều ngược lại (từ cuối về đầu), sau đó ghép nối hai trạng thái xuôi và ngược tại mỗi từ: kiến trúc này được gọi là RNN hai chiều (bidirectional RNN). Hãy ghi nhớ chuỗi trạng thái này: ở mục 9.2, cơ chế chú ý (attention) sẽ đọc toàn bộ chuỗi trạng thái đó thay vì chỉ lấy mỗi trạng thái cuối cùng .
7.2 Bài toán huấn luyện và hiện tượng triệt tiêu đạo hàm
Mạng RNN cũng được huấn luyện giống như các mạng nơ-ron khác trong chương này: cực tiểu hóa hàm mất mát (loss function) bằng thuật toán hạ gradient (gradient descent). Để tính được gradient, ta trải phẳng (unroll) mạng theo thời gian: viết liên tiếp L bước xử lý của mạng nối đuôi nhau, giống như hình minh họa ở đầu mục 7. Khi được trải phẳng, RNN trở thành một mạng truyền thẳng sâu (deep feedforward network) có L tầng (mỗi từ ứng với một tầng), trong đó tất cả các tầng đều dùng chung một bộ trọng số; gradient sẽ được tính bằng cách lan truyền ngược qua L tầng này. Quá trình này được gọi là lan truyền ngược qua thời gian (backpropagation through time – BPTT) (Werbos, 1990).
Và đây chính là nơi nảy sinh rắc rối lớn. Để hàm mất mát ở cuối câu có thể dạy cho mạng điều gì đó về những từ đầu tiên của bài đánh giá, tín hiệu gradient phải truyền ngược từ trạng thái cuối cùng về tận các trạng thái đầu tiên, đi qua tất cả các bước trung gian ở giữa. Theo quy tắc dây chuyền (chain rule) trong giải tích, đạo hàm của trạng thái cuối cùng theo trạng thái ngay sau từ thứ là tích của ma trận, mỗi bước ứng với một ma trận:
trong đó ma trận đường chéo chứa đạo hàm của hàm (tức ) tại từng thành phần của vector trạng thái. Giống như lũy thừa bậc cao của một con số, tích của một chuỗi dài các ma trận như vậy sẽ có xu hướng co nhỏ lại theo hàm mũ theo khoảng cách nếu các ma trận làm co các vector mà chúng nhân vào, hoặc phình to theo hàm mũ nếu các ma trận kéo giãn vector. Đây chính là hai hiện tượng kinh điển: triệt tiêu đạo hàm (vanishing gradients) và bùng nổ đạo hàm (exploding gradients). Vì đạo hàm của hàm có giá trị tối đa bằng 1 và tiến sát về 0 khi nơ-ron rơi vào vùng bão hòa, nên gradient rất dễ bị triệt tiêu dần. Khi đó, những từ nằm ở đầu một bài đánh giá dài hầu như không nhận được chút gradient nào, khiến mạng không thể học cách sử dụng chúng dù chúng vẫn nằm trong dữ liệu đầu vào.
Bengio, Simard và Frasconi đã chứng minh rằng đây không phải là sự trùng hợp ngẫu nhiên hay kém may mắn (Bengio et al., 1994). Một mạng nơ-ron muốn lưu giữ thông tin một cách bền vững — sao cho nhiễu từ các từ đầu vào tiếp theo không xóa mất thông tin đã lưu — thì bản thân mạng đó buộc phải hoạt động ở vùng mà đạo hàm theo các bước quá khứ bị triệt tiêu theo hàm mũ. Như các tác giả kết luận: “Những kết quả này phơi bày một sự đánh đổi căn bản giữa việc học hiệu quả bằng hạ gradient và khả năng chốt giữ thông tin trong thời gian dài.”
Khi xảy ra hiện tượng bùng nổ đạo hàm (exploding gradient), chỉ một bước cập nhật duy nhất cũng có thể hất văng các trọng số đi rất xa, khiến giá trị hàm mất mát tăng vọt đột ngột. Cách khắc phục rất đơn giản và được gọi là cắt tỉa gradient (gradient clipping) (Pascanu et al., 2013): trước mỗi bước cập nhật trọng số, nếu chuẩn (norm) của vector gradient vượt quá một ngưỡng cho trước, ta chia nhỏ vector gradient đó để chuẩn của nó bằng đúng ngưỡng giới hạn. Nhờ vậy, bước cập nhật vẫn giữ nguyên hướng nhưng độ lớn được kìm hãm an toàn. Trong PyTorch, kỹ thuật này chỉ gói gọn trong một dòng lệnh duy nhất: nn.utils.clip_grad_norm_(model.parameters(), 1.0), đặt ngay giữa loss.backward() và optimizer.step().
Ngược lại, hiện tượng triệt tiêu đạo hàm (vanishing gradient) đòi hỏi phải thay đổi chính kiến trúc của mạng. Kiến trúc LSTM (viết tắt của long short-term memory – Bộ nhớ ngắn-dài hạn) bổ sung thêm một trạng thái thứ hai gọi là ô nhớ (cell state) , được cập nhật thông qua phép cộng thay vì phép nhân ma trận:
trong đó ký hiệu biểu thị phép nhân từng phần tử (element-wise product). Vector là bản cập nhật ứng viên (candidate update), được tính từ trạng thái trước đó và từ hiện tại giống như trạng thái của mạng RNN thuần túy. Còn , và là ba cổng (gates): các vector chứa các con số nằm trong khoảng từ 0 đến 1, được tính theo cùng công thức nhưng sử dụng hàm kích hoạt sigmoid — ví dụ — trong đó mỗi cổng sở hữu bộ trọng số riêng. Cổng quên (forget gate) quyết định giữ lại bao nhiêu phần trăm của từng thành phần trong ô nhớ cũ; cổng đầu vào (input gate) quyết định nạp thêm bao nhiêu thông tin từ bản cập nhật ứng viên ; và cổng đầu ra (output gate) quyết định đưa bao nhiêu thông tin từ ô nhớ ra trạng thái ẩn (để chuyển sang bước tiếp theo cũng như đưa vào đầu dự đoán).
Từ sang , gradient chỉ bị nhân từng phần tử với cổng quên : không có phép nhân ma trận nào, cũng không bị đi qua đạo hàm của hàm . Khi cổng quên có giá trị xấp xỉ bằng 1, tín hiệu gradient có thể truyền ngược qua rất nhiều bước thời gian mà hầu như không bị suy giảm, giúp mạng học được tại từng từ xem thông tin nào cần lưu giữ và thông tin nào cần xóa bỏ.
Kiến trúc GRU (viết tắt của gated recurrent unit – Đơn vị truy hồi có cổng) (Cho et al., 2014) là một biến thể gọn nhẹ hơn, chỉ sử dụng hai cổng và không tách riêng ô nhớ . Trong PyTorch, các lớp nn.RNN, nn.LSTM và nn.GRU nhận các đối số đầu vào giống hệt nhau, nên bạn có thể chuyển đổi qua lại giữa chúng chỉ bằng một dòng mã. Hãy cùng đo lường trực tiếp độ lớn của gradient truyền về tới từng từ trong các mạng này.
Bài tập 7.2a Đo lường độ lớn gradient truyền về tới từng từ
Hãy đưa một chuỗi gồm 100 vector nhúng ngẫu nhiên vào một mạng RNN thuần túy và một mạng LSTM (cả hai đều chưa qua huấn luyện) với kích thước . Đối với mỗi mạng, hãy tính chuẩn (norm) của gradient của trạng thái ẩn cuối cùng theo từng vector nhúng đầu vào, rồi vẽ đồ thị biểu diễn giá trị này theo khoảng cách tính từ cuối chuỗi trên thang đo logarit (log scale). Sau đó, hãy gán độ chệch (bias) của cổng quên trong mạng LSTM bằng 3, rồi vẽ lại đồ thị để so sánh.
import torch

# Một chuỗi gồm L vector nhúng ngẫu nhiên kích thước D, dưới dạng
# lô gồm một chuỗi: các tầng hồi quy của PyTorch với batch_first=True
# nhận đầu vào là tensor có kích thước (batch, L, D)
L, D = 100, 100
torch.manual_seed(0)
embeddings = torch.randn(1, L, D)

print(f"embeddings: {tuple(embeddings.shape)}")
embeddings: (1, 100, 100)
Hint
Khi bật tùy chọn batch_first=True, cả nn.RNN(D, H) và nn.LSTM(D, H) đều nhận đầu vào là một tensor có kích thước (batch, L, D), và trả về chuỗi trạng thái sau mỗi từ có kích thước (batch, L, H) kèm theo trạng thái cuối cùng. Riêng nn.LSTM trả về một bộ (tuple) gồm trạng thái ẩn cuối cùng và trạng thái ô nhớ cuối cùng.
Hint
Hãy gọi phương thức requires_grad_() trên một bản sao của các vector nhúng để PyTorch tính đạo hàm theo chúng. Hàm backward() cần được gọi từ một giá trị vô hướng (scalar): bạn có thể lấy tổng các thành phần của trạng thái ẩn cuối cùng. Khi đó, đạo hàm sẽ nằm trong thuộc tính .grad của tensor nhúng, mỗi hàng ứng với một từ. Hãy chuyển sang kiểu số thực dấu phẩy động 64-bit (.double()) khi tính chuẩn của từng hàng, bởi ở kiểu float32, bình phương của những thành phần quá nhỏ sẽ bị làm tròn thành 0 (underflow).
Hint
Mỗi cổng trong lớp LSTM của PyTorch có hai vector độ chệch được cộng lại với nhau: một nằm trong bias_ih_l0 và một nằm trong bias_hh_l0. Mỗi vector này chứa nối tiếp nhau độ chệch của cả bốn cổng theo thứ tự: cổng đầu vào (input), cổng quên (forget), ô nhớ ứng viên (cell), và cổng đầu ra (output), mỗi phần gồm H giá trị. Do đó, cổng quên nằm ở lát cắt [H:2 * H]. Hãy thay đổi giá trị của chúng bên trong khối with torch.no_grad():.
Điểm kiểm tra kết quả bạn cần đạt được
Tại vị trí cách cuối chuỗi 10 từ, chuẩn của gradient là 1.3e-3 đối với RNN và 5.5e-3 đối với LSTM. Cách cuối chuỗi 50 từ, con số này giảm xuống còn 1.6e-17 (RNN) và 1.9e-11 (LSTM); và tại vector nhúng đầu tiên (cách cuối chuỗi 99 từ), nó chỉ còn 6.3e-34 và 3.9e-22. Tuy nhiên, khi đặt độ chệch (bias) của cổng quên bằng 3, mạng LSTM vẫn truyền được mức gradient lên tới 0.25 về tận vector nhúng đầu tiên. Biểu đồ trong notebook thể hiện rõ sự khác biệt giữa ba đường cong này.
RNN                   distance 10: 1.3e-03   50: 1.6e-17   99: 6.3e-34
LSTM                  distance 10: 5.5e-03   50: 1.9e-11   99: 3.9e-22
LSTM, forget bias 3   distance 10: 5.0e-01   50: 2.5e-01   99: 2.5e-01
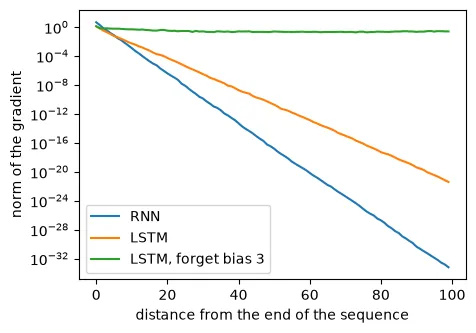
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
import torch

# Một chuỗi gồm L vector nhúng ngẫu nhiên kích thước D, dưới dạng
# lô gồm một chuỗi: các tầng hồi quy của PyTorch với batch_first=True
# nhận đầu vào là tensor có kích thước (batch, L, D)
L, D = 100, 100
torch.manual_seed(0)
embeddings = torch.randn(1, L, D)

print(f"embeddings: {tuple(embeddings.shape)}")
embeddings: (1, 100, 100)
# (1) Một mạng RNN thuần và một mạng LSTM với trạng thái ẩn kích
# thước H, chưa huấn luyện, dùng khởi tạo mặc định của PyTorch
from torch import nn

H = 100
torch.manual_seed(0)
rnn = nn.RNN(D, H, batch_first=True)
lstm = nn.LSTM(D, H, batch_first=True)


# (2) Chuẩn đạo hàm của trạng thái cuối cùng theo từng vector nhúng.
# backward() cần một số vô hướng: lấy tổng các thành phần của trạng
# thái cuối cùng.
def gradient_norms(model, embeddings):
    x = embeddings.clone().requires_grad_()   # theo dõi đạo hàm
    states, _ = model(x)   # (1, L, H): trạng thái sau mỗi từ
    states[0, -1].sum().backward()
    # Một chuẩn cho mỗi từ, tính ở float64: trong float32, bình
    # phương của các thành phần cực nhỏ sẽ bị làm tròn thành 0
    return x.grad[0].double().norm(dim=1)


# (3) Một bản sao của LSTM với độ chệch (bias) của cổng quên đặt
# bằng 3. PyTorch cộng hai vector độ chệch, bias_ih_l0 và bias_hh_l0,
# mỗi vector chứa độ chệch của 4 cổng nối tiếp nhau: cổng vào, cổng
# quên, ô nhớ, cổng ra, mỗi cổng H giá trị.
import copy

open_lstm = copy.deepcopy(lstm)
with torch.no_grad():
    open_lstm.bias_ih_l0[H:2 * H] = 3.0   # cổng quên
    open_lstm.bias_hh_l0[H:2 * H] = 0.0


# (4) Vẽ biểu đồ các chuẩn theo khoảng cách tính từ cuối chuỗi:
# 0 cho vector nhúng cuối cùng, L - 1 cho vector nhúng đầu tiên
import matplotlib.pyplot as plt

models = {"RNN": rnn, "LSTM": lstm,
          "LSTM, forget bias 3": open_lstm}
distances = list(range(L))
plt.figure(figsize=(5, 3.5))
for name, model in models.items():
    norms = gradient_norms(model, embeddings).flip(0).tolist()
    plt.plot(distances, norms, label=name)
    print(f"{name:20}  distance 10: {norms[10]:.1e}   "
          f"50: {norms[50]:.1e}   99: {norms[99]:.1e}")
plt.yscale("log")
plt.xlabel("distance from the end of the sequence")
plt.ylabel("norm of the gradient")
plt.legend()
plt.show()
RNN                   distance 10: 1.3e-03   50: 1.6e-17   99: 6.3e-34
LSTM                  distance 10: 5.5e-03   50: 1.9e-11   99: 3.9e-22
LSTM, forget bias 3   distance 10: 5.0e-01   50: 2.5e-01   99: 2.5e-01
Trên thang đo logarit, đường cong suy giảm gradient của cả RNN lẫn LSTM mặc định gần như là những đường thẳng tắp: cứ mỗi bước lùi về quá khứ, độ lớn gradient lại bị chia nhỏ đi khoảng 2.2 lần đối với RNN và khoảng 1.6 lần đối với LSTM. Sau 99 bước, từ đầu tiên trong chuỗi hầu như không còn nhận được tín hiệu nào. Điều này cho thấy bản thân kiến trúc LSTM không phải là một phép màu tự động giải quyết mọi thứ. Với cách khởi tạo mặc định của PyTorch, độ chệch của cổng quên nằm gần mức 0, khiến cổng quên khởi đầu ở mức ; như Jozefowicz và cộng sự đã chỉ ra, “điều này vô tình tạo ra sự suy giảm gradient với hệ số 0.5 sau mỗi bước thời gian” (Jozefowicz et al., 2015). Khi ta đặt độ chệch bằng 3, cổng quên khởi đầu ở mức , giúp độ lớn gradient duy trì ổn định trong khoảng từ 0.25 đến 0.5 suốt từ từ thứ 10 từ cuối đếm ngược về tận từ đầu tiên. Đây chính là giá trị cốt lõi mà LSTM mang lại: một đường truyền riêng nơi gradient chỉ bị nhân với các cổng quên — thứ mà mạng có thể chủ động học cách mở ra khi cần. Mạng RNN thuần túy hoàn toàn không có đường truyền nào như vậy: ở mọi bước, gradient bắt buộc phải đi qua ma trận và đạo hàm của hàm . Jozefowicz và cộng sự khuyến nghị rằng “nên cộng thêm độ chệch bằng 1 vào cổng quên của mọi mạng LSTM trong mọi ứng dụng”. Trong mạng LSTM, các cổng quên chính là van quyết định tín hiệu đạo hàm có thể truyền ngược về quá khứ xa đến đâu.
Bây giờ, hãy huấn luyện một mạng LSTM trên tập dữ liệu đánh giá phim IMDB. Có hai chi tiết kỹ thuật mới so với các mạng lấy trung bình trước đây. Thứ nhất, vì LSTM đọc các từ theo đúng thứ tự, mỗi bài đánh giá giờ đây được biểu diễn bằng danh sách chỉ số (index) của các từ theo đúng trình tự xuất hiện, thay vì một vector đếm tần suất. Thứ hai, các bài đánh giá trong cùng một lô (batch) có độ dài ngắn khác nhau, trong khi một tensor bắt buộc phải có dạng hình chữ nhật đều đặn: do đó, ta phải đệm (pad) thêm các số 0 vào cuối những bài đánh giá ngắn, đồng thời đóng gói (pack) lô dữ liệu kèm theo độ dài thực của từng bài. Nhờ vậy, LSTM sẽ dừng lại đúng ở từ cuối cùng của mỗi bài đánh giá mà không tính toán trạng thái cuối trên phần đệm vô nghĩa. Để giữ cho thời gian huấn luyện ngắn gọn, đối với 14% số bài đánh giá dài quá 400 từ, ta chỉ giữ lại 400 từ cuối cùng.
Bài tập 7.2b Phân loại bài đánh giá phim IMDB bằng mạng LSTM
Hãy huấn luyện một bộ phân loại LSTM trên tập dữ liệu IMDB sử dụng bộ từ vựng của bài tập 3.2: mạng LSTM đọc các vector nhúng của các từ trong bài đánh giá (, ), và một đầu dự đoán logistic (logistic head) sẽ đọc trạng thái ẩn cuối cùng của nó. Hãy chọn số kỷ nguyên (epochs) tối ưu dựa trên tập xác thực (validation set) và đo độ chính xác trên tập kiểm tra (test set). Sau đó, hãy đo độ chính xác khi xáo trộn ngẫu nhiên thứ tự các từ trong các bài đánh giá kiểm tra, đồng thời chạy mô hình trên tập các bài đánh giá khó của bài tập 3.4.
Mã khởi đầu đã thực hiện sẵn bước (1) trong lời giải của bài tập 3.2 và liệt kê các bài đánh giá khó của bài tập 3.4. Tiếp đó, mã chuyển mỗi bài đánh giá thành danh sách chỉ số của các từ theo đúng thứ tự xuất hiện dựa trên bộ từ vựng của bài tập 3.2.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
# [Sao chép từ phần khởi đầu bài 3.4]
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")


# ----------------------
#  Mới trong bài tập này
# ----------------------
# Từ vựng của bài 3.2: 10.000 từ phổ biến nhất trong các bài đánh
# giá huấn luyện. build_analyzer() trả về hàm mà CountVectorizer
# dùng để tách văn bản thành các từ.
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
vectorizer.fit(train_texts)
split_words = vectorizer.build_analyzer()
word_index = {word: int(i)   # từ -> chỉ số, từ 0 đến V - 1
              for word, i in vectorizer.vocabulary_.items()}
V = len(word_index)

# Chuyển mỗi bài đánh giá thành danh sách chỉ số các từ theo đúng
# thứ tự. Các từ ngoài từ vựng nhận chỉ số V. Chỉ giữ lại 400 từ
# cuối cùng đối với các bài đánh giá dài.
max_length = 400

def to_indices(text):
    indices = [word_index.get(word, V) for word in split_words(text)]
    return indices[-max_length:]

train_sequences = [to_indices(text) for text in train_texts]
val_sequences = [to_indices(text) for text in val_texts]
test_sequences = [to_indices(text) for text in test_texts]

example = hard_reviews[9][0]
print(f"\n{split_words(example)}")
print(f"{to_indices(example)}")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews

['i', 'expected', 'it', 'to', 'be', 'great', 'but', 'it', 'was', 'terrible']
[4469, 3253, 4804, 9084, 903, 4000, 1344, 4804, 9679, 8934]
Hint
Hãy viết mô hình dưới dạng một lớp con kế thừa từ nn.Module, bao gồm nn.Embedding(V + 1, D) (chỉ số V dành cho các từ nằm ngoài từ vựng), nn.LSTM(D, H, batch_first=True) và nn.Linear(H, 1).
Hint
Hàm nn.utils.rnn.pad_sequence(tensors, batch_first=True) giúp đệm thêm các số 0 vào danh sách các tensor có độ dài khác nhau. Hãy đưa các vector nhúng của lô dữ liệu đã đệm vào hàm nn.utils.rnn.pack_padded_sequence(x, lengths, batch_first=True, enforce_sorted=False), rồi truyền kết quả đó cho lớp LSTM. Lớp LSTM sẽ trả về chuỗi trạng thái cùng bộ (h, c), trong đó h[0] lưu giữ trạng thái ngay sau từ thực sự cuối cùng của mỗi bài đánh giá trong lô.
Hint
Hãy huấn luyện bằng bộ tối ưu hóa Adam (tốc độ học 0.001) trên các lô gồm 64 bài đánh giá, sử dụng hàm mất mát nn.BCEWithLogitsLoss() giống bài tập 4.3, và nhớ cắt tỉa gradient (clip gradient) ở ngưỡng 1.0. Trên CPU của một chiếc laptop thông thường, mỗi kỷ nguyên (epoch) mất hơn một phút một chút.
Hint
Đối với bài kiểm tra xáo trộn từ, hãy tạo bản sao danh sách chỉ số từ của từng bài đánh giá trong tập kiểm tra, xáo trộn bằng random.shuffle, rồi đo lại độ chính xác của mô hình trên các danh sách đã xáo trộn này.
Điểm kiểm tra kết quả bạn cần đạt được
Độ chính xác trên tập xác thực (validation accuracy) tăng đều qua từng kỷ nguyên, từ 72.6% sau kỷ nguyên đầu tiên lên 87.2% sau kỷ nguyên thứ sáu, và độ chính xác trên tập kiểm tra đạt 87.2%. Khi xáo trộn ngẫu nhiên thứ tự từ trong các bài đánh giá kiểm tra, độ chính xác sụt giảm xuống còn 82.6%. Mô hình dự đoán đúng 8 trên 13 bài đánh giá khó, bao gồm cả cặp bài đánh giá chứa các từ giống hệt nhau: xác suất tích cực là 0.633 cho câu khen và 0.112 cho câu chê. Kết quả của bạn có thể chênh lệch đôi chút khoảng 1 điểm phần trăm, đặc biệt khi chạy trên GPU.
epoch 1: validation accuracy 0.726
epoch 2: validation accuracy 0.819
epoch 3: validation accuracy 0.845
epoch 4: validation accuracy 0.852
epoch 5: validation accuracy 0.865
epoch 6: validation accuracy 0.872

test accuracy, epoch 6: 0.872
test accuracy, words shuffled: 0.826

label     p(positive)  right  review
positive  0.371        NO     Not bad at all, actually.
negative  0.192        yes    Nothing about this movie is good.
positive  0.271        NO     I wouldn't call it a masterpiece, b…
negative  0.011        yes    Great acting, great lighting and a …
positive  0.990        yes    The first hour is slow and the dial…
negative  0.930        NO     Everyone told me it would be the fi…
negative  0.933        NO     Wow, what a masterpiece. Two hours …
negative  0.732        NO     Brilliant. Another sequel nobody as…
positive  0.633        yes    I expected it to be terrible, but i…
negative  0.112        yes    I expected it to be great, but it w…
positive  0.976        yes    Excellent movie, awesome soundtrack.
positive  0.963        yes    Superb film, wonderful score.
positive  0.698        yes    A flabbergasting, mesmerizing tour …

8 right out of 13
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
# [Sao chép từ phần khởi đầu bài 3.4]
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")


# ----------------------
#  Mới trong bài tập này
# ----------------------
# Từ vựng của bài 3.2: 10.000 từ phổ biến nhất trong các bài đánh
# giá huấn luyện. build_analyzer() trả về hàm mà CountVectorizer
# dùng để tách văn bản thành các từ.
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
vectorizer.fit(train_texts)
split_words = vectorizer.build_analyzer()
word_index = {word: int(i)   # từ -> chỉ số, từ 0 đến V - 1
              for word, i in vectorizer.vocabulary_.items()}
V = len(word_index)

# Chuyển mỗi bài đánh giá thành danh sách chỉ số các từ theo đúng
# thứ tự. Các từ ngoài từ vựng nhận chỉ số V. Chỉ giữ lại 400 từ
# cuối cùng đối với các bài đánh giá dài.
max_length = 400

def to_indices(text):
    indices = [word_index.get(word, V) for word in split_words(text)]
    return indices[-max_length:]

train_sequences = [to_indices(text) for text in train_texts]
val_sequences = [to_indices(text) for text in val_texts]
test_sequences = [to_indices(text) for text in test_texts]

example = hard_reviews[9][0]
print(f"\n{split_words(example)}")
print(f"{to_indices(example)}")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews

['i', 'expected', 'it', 'to', 'be', 'great', 'but', 'it', 'was', 'terrible']
[4469, 3253, 4804, 9084, 903, 4000, 1344, 4804, 9679, 8934]
# (1) Mô hình: tầng nhúng từ (thêm một hàng cho từ chưa biết), một
# mạng LSTM đọc chúng theo thứ tự, và một đầu phân loại đọc trạng
# thái cuối cùng. Các bài đánh giá trong cùng một lô có độ dài khác
# nhau: đệm thêm các số 0 để có cùng độ dài và đóng gói kèm độ dài
# thực để LSTM dừng ở từ cuối của mỗi bài mà không đọc phần đệm.
import torch
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"

class LSTMClassifier(nn.Module):
    def __init__(self, V, D, H):
        super().__init__()
        self.embedding = nn.Embedding(V + 1, D)   # + từ chưa biết
        self.lstm = nn.LSTM(D, H, batch_first=True)
        self.head = nn.Linear(H, 1)   # p(positive) = sigmoid

    def forward(self, sequences):
        lengths = torch.tensor([len(s) for s in sequences])
        padded = nn.utils.rnn.pad_sequence(
            [torch.tensor(s) for s in sequences], batch_first=True)
        x = self.embedding(padded.to(device))   # (batch, L, D)
        packed = nn.utils.rnn.pack_padded_sequence(
            x, lengths, batch_first=True, enforce_sorted=False)
        _, (h, c) = self.lstm(packed)   # h: (1, batch, H)
        return self.head(h[0])[:, 0]   # điểm số của mỗi bài đánh giá

torch.manual_seed(0)
model = LSTMClassifier(V, D=100, H=128).to(device)


# (2) Huấn luyện bằng Adam trên các lô 64 bài đánh giá, có cắt
# ngưỡng đạo hàm (gradient clipping). Sau mỗi epoch, đo độ chính
# xác xác thực và giữ lại bản sao của mô hình tốt nhất.
import copy
import random

def predict(model, sequences):
    # p(positive) cho mỗi chuỗi, mỗi lần 500 chuỗi
    probabilities = []
    with torch.no_grad():
        for start in range(0, len(sequences), 500):
            scores = model(sequences[start:start + 500])
            probabilities.append(torch.sigmoid(scores).cpu())
    return torch.cat(probabilities)

def accuracy(model, sequences, labels):
    right = (predict(model, sequences) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

y_train = torch.tensor(train_labels, dtype=torch.float32)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_function = nn.BCEWithLogitsLoss()   # sigmoid + cross-entropy
batch_size = 64
best_accuracy = 0
for epoch in range(6):
    order = torch.randperm(len(train_sequences)).tolist()
    for start in range(0, len(order), batch_size):
        batch = order[start:start + batch_size]
        scores = model([train_sequences[i] for i in batch])
        loss = loss_function(scores, y_train[batch].to(device))
        optimizer.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
    val_accuracy = accuracy(model, val_sequences, val_labels)
    print(f"epoch {epoch + 1}: "
          f"validation accuracy {val_accuracy:.3f}")
    if val_accuracy > best_accuracy:
        best_accuracy, best_epoch = val_accuracy, epoch + 1
        best_model = copy.deepcopy(model)


# (3) Độ chính xác kiểm tra của mô hình tốt nhất, sau đó là bài
# kiểm tra xáo trộn: vẫn các bài đánh giá kiểm tra đó nhưng các từ
# trong mỗi bài bị xáo trộn ngẫu nhiên
test_accuracy = accuracy(best_model, test_sequences, test_labels)
print(f"\ntest accuracy, epoch {best_epoch}: {test_accuracy:.3f}")

random.seed(0)
shuffled_sequences = []
for sequence in test_sequences:
    shuffled = list(sequence)
    random.shuffle(shuffled)
    shuffled_sequences.append(shuffled)
shuffled_accuracy = accuracy(best_model, shuffled_sequences,
                             test_labels)
print(f"test accuracy, words shuffled: {shuffled_accuracy:.3f}")


# (4) Chạy mô hình tốt nhất trên các bài đánh giá khó như ở bài 3.4
hard_sequences = [to_indices(text) for text, label in hard_reviews]
p_positive = predict(best_model, hard_sequences)

names = ["negative", "positive"]
print("\nlabel     p(positive)  right  review")
right_count = 0
for (review, label), p in zip(hard_reviews, p_positive.tolist()):
    right = (p > 0.5) == (label == 1)
    if right:
        right_count += 1
    mark = "yes" if right else "NO"
    short = review if len(review) <= 36 else review[:35] + "…"
    print(f"{names[label]:9} {p:.3f}        {mark:5}  {short}")
print(f"\n{right_count} right out of {len(hard_reviews)}")
epoch 1: validation accuracy 0.726
epoch 2: validation accuracy 0.819
epoch 3: validation accuracy 0.845
epoch 4: validation accuracy 0.852
epoch 5: validation accuracy 0.865
epoch 6: validation accuracy 0.872

test accuracy, epoch 6: 0.872
test accuracy, words shuffled: 0.826

label     p(positive)  right  review
positive  0.371        NO     Not bad at all, actually.
negative  0.192        yes    Nothing about this movie is good.
positive  0.271        NO     I wouldn't call it a masterpiece, b…
negative  0.011        yes    Great acting, great lighting and a …
positive  0.990        yes    The first hour is slow and the dial…
negative  0.930        NO     Everyone told me it would be the fi…
negative  0.933        NO     Wow, what a masterpiece. Two hours …
negative  0.732        NO     Brilliant. Another sequel nobody as…
positive  0.633        yes    I expected it to be terrible, but i…
negative  0.112        yes    I expected it to be great, but it w…
positive  0.976        yes    Excellent movie, awesome soundtrack.
positive  0.963        yes    Superb film, wonderful score.
positive  0.698        yes    A flabbergasting, mesmerizing tour …

8 right out of 13
Lần đầu tiên kể từ đầu chương, một bộ phân loại đã phân biệt đúng hai bài đánh giá chứa các từ giống hệt nhau: gán xác suất 0.63 cho câu “I expected it to be terrible, but it was great.” và 0.11 cho câu ngược lại. Đồng thời, việc xáo trộn thứ tự các từ trong tập kiểm tra giờ đây làm mất đi 4.6 điểm phần trăm độ chính xác: điều này chứng tỏ mô hình thực sự có sử dụng thông tin về trật tự từ. Thế nhưng, độ chính xác tổng thể trên tập kiểm tra của nó (87.2%) vẫn không hề cao hơn mô hình túi từ ở mục 3 (đạt 87.6% với tần suất đếm và 88.4% với TF-IDF). Dai và Le cũng từng ghi nhận kết quả tương tự: một mạng LSTM huấn luyện từ đầu (from scratch) trên IMDB chỉ đạt 86.5% (Dai & Le, 2015). Học cách đọc văn bản theo thứ tự khó hơn nhiều so với việc chỉ đếm từ. Chỉ từ 20,000 bài đánh giá có nhãn, mô hình vừa phải học các vector nhúng từ, vừa phải học xem nên giữ lại thông tin gì trong trạng thái ẩn và khi nào thì nên quên nó đi; nó cần tới 6 kỷ nguyên trong khi mạng lấy trung bình ở bài tập 4.3 chỉ cần 2 kỷ nguyên. Tập các bài đánh giá khó cho thấy rõ nơi nào trật tự từ phát huy tác dụng: câu có cấu trúc tương phản “The first hour is slow and the dialogue is clumsy, but the ending makes it all worth it.” giờ đã được dự đoán đúng một cách tự tin (0.99). Tuy nhiên, câu phủ định kép “Not bad at all, actually.” vẫn bị đoán nhầm là tiêu cực, và các câu mỉa mai vẫn tiếp tục đánh lừa được mô hình. Mạng LSTM có khả năng khai thác thứ tự của các từ, nhưng nếu chỉ học từ 20,000 bài đánh giá có nhãn, những gì nó học được chẳng vượt qua nổi một mô hình túi từ.
Hãy quan sát cách mạng LSTM phân biệt hai bài đánh giá chứa các từ giống hệt nhau. Hình tương tác dưới đây minh họa quá trình mạng đọc từng từ một trong hai câu đó. Năm từ đầu tiên ở cả hai bài đánh giá là giống hệt nhau, nên các trạng thái ẩn của mạng cũng giống hệt nhau: tại thời điểm đó, mạng chưa thể biết điều gì sẽ xảy ra tiếp theo. Đến từ thứ sáu, từ “terrible” kéo xác suất tích cực ở câu A xuống thấp, trong khi từ “great” đẩy xác suất tích cực ở câu B lên cao. Ba từ tiếp theo — “but it was” — lại giống hệt nhau ở cả hai câu, nhưng lúc này các trạng thái ẩn vẫn duy trì sự khác biệt bởi mỗi trạng thái đều mang theo ký ức về những gì đã đọc trước đó. Và đến từ cuối cùng, dự đoán của mạng đảo chiều hoàn toàn: vọt lên mức tích cực khi gặp từ “great” ở câu A, và lao dốc xuống mức tiêu cực khi gặp từ “terrible” ở câu B.
Mạng LSTM đã biết đọc theo thứ tự, nhưng trên tập dữ liệu IMDB nó vẫn chưa đánh bại được mô hình túi từ. Dai và Le cũng gặp đúng tình cảnh này, và họ đã tìm ra phương thuốc giải quyết: trước tiên, hãy tiền huấn luyện (pre-train) mạng LSTM trên dữ liệu văn bản thô không nhãn — tương tự như cách mục 5 tiền huấn luyện các vector nhúng — sau đó mới tinh chỉnh (fine-tune) mạng trên các bài đánh giá có nhãn. Nhờ chiến lược này, mạng LSTM của họ đã vọt lên mức độ chính xác 92.4% trên IMDB. Đây sẽ là chủ đề của mục 8. Nhưng để tiền huấn luyện một mạng LSTM trên văn bản thô, chúng ta cần một bài toán mà bản thân văn bản thô có thể tự cung cấp nhãn giám sát: đó chính là bài toán dự đoán từ tiếp theo như ở mục 2.
7.3 Mạng RNN trong vai trò mô hình ngôn ngữ và bộ sinh văn bản
Hãy quay trở lại với bài toán mô hình hóa ngôn ngữ (language modeling). Bản thân mạng RNN cũng chính là một mô hình ngôn ngữ: tại mỗi vị trí , một đầu dự đoán sẽ đọc trạng thái ẩn và đưa ra phân phối xác suất của từ tiếp theo thông qua hàm softmax trên toàn bộ từ vựng, tương tự như mô hình của Bengio:
Vì trạng thái phụ thuộc vào tất cả các từ kể từ đầu văn bản cho đến vị trí , nên ngữ cảnh giờ đây không còn bị bó hẹp trong từ cuối cùng nữa. Mikolov và cộng sự đã xây dựng một mô hình như vậy vào năm 2010 (Mikolov et al., 2010); khi kết hợp (ensemble) một vài mạng RNN, họ đã cắt giảm được gần một nửa độ hỗn loạn (perplexity) so với mô hình 5-gram làm mịn Kneser-Ney trên kho dữ liệu tin tức. Như nhóm tác giả tuyên bố, những kết quả này đã “đập tan lầm tưởng lâu nay rằng mô hình hóa ngôn ngữ chỉ xoay quanh việc đếm các cụm n-gram”.
Để huấn luyện mô hình này, lý tưởng nhất là ta trải phẳng mạng RNN trên toàn bộ văn bản huấn luyện rồi lan truyền ngược qua đó. Thế nhưng WikiText-2 là một văn bản liền mạch dài tới 2 triệu từ, nghĩa là tín hiệu gradient sẽ phải đi ngược qua 2 triệu bước! Giải pháp tiêu chuẩn trong thực tế là lan truyền ngược qua thời gian bị cắt ngắn (truncated backpropagation through time – TBPTT). Ta cắt văn bản thành các đoạn ngắn (chunks) gồm 35 từ và đọc chúng lần lượt theo đúng thứ tự. Trạng thái ẩn vẫn được truyền nguyên vẹn từ đoạn này sang đoạn kế tiếp, nhờ đó việc dự đoán mỗi từ vẫn phụ thuộc vào toàn bộ văn bản phía trước nó. Tuy nhiên, quá trình tính đạo hàm (gradient) sẽ bị chặn lại ở điểm đầu của mỗi đoạn: mạng chỉ học các mối phụ thuộc trong phạm vi tối đa 35 từ ngữ cảnh, mặc dù khi dự đoán nó vẫn sử dụng thông tin xa hơn thế. Để tận dụng khả năng tính toán song song của các phép nhân ma trận trên phần cứng, ta đồng thời chia văn bản thành 32 luồng dài (streams), và mỗi lô (batch) sẽ đọc song song cả 32 luồng này, mỗi luồng một đoạn 35 từ.
Giống như mô hình của Bengio ở bài tập 4.2, mô hình này chứa rất nhiều tham số (phần lớn nằm ở tầng đầu ra, với một hàng trong ma trận cho mỗi từ trong từ vựng) và bắt đầu bị quá khớp (overfit) chỉ sau một vài kỷ nguyên; vì vậy ta sẽ lưu lại phiên bản mô hình ở kỷ nguyên có độ hỗn loạn trên tập xác thực (validation perplexity) thấp nhất.
Bài tập 7.3★ Huấn luyện mô hình ngôn ngữ LSTM trên WikiText-2
Hãy huấn luyện một mô hình ngôn ngữ LSTM trên tập dữ liệu WikiText-2 () bằng kỹ thuật lan truyền ngược qua thời gian bị cắt ngắn (truncated backpropagation through time): đọc văn bản huấn luyện theo từng đoạn dài 35 từ, truyền trạng thái từ đoạn này sang đoạn tiếp theo, nhưng ngắt dòng chảy gradient ở đầu mỗi đoạn. Huấn luyện trong 3 kỷ nguyên, đo độ hỗn loạn trên tập xác thực sau mỗi kỷ nguyên, và tính độ hỗn loạn trên tập kiểm tra của mô hình tốt nhất. Hãy so sánh kết quả với các mô hình n-gram ở bài tập 2.3b và mô hình của Bengio ở bài tập 4.2. Cuối cùng, hãy dùng mô hình để sinh ra một đoạn văn bản dài 50 từ.
Mã khởi đầu đã xây dựng sẵn ba chuỗi dữ liệu cùng bảng chỉ mục từ vựng giống như trong các bài tập 2.1, 2.2 và 4.2, sau đó cắt mỗi chuỗi thành các luồng (streams) để xử lý song song theo lô (xem gợi ý đầu tiên).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách mỗi dòng theo khoảng trắng
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực và chuỗi kiểm tra, được tạo theo cùng cách
# [Sao chép từ phần khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")


# Gán một chỉ số cho mỗi từ trong từ vựng
# [Sao chép từ phần khởi đầu bài 4.2]
vocabulary = sorted(set(train_sequence))
word_index = {word: i for i, word in enumerate(vocabulary)}


# ----------------------
#  Mới trong bài tập này
# ----------------------
# Cắt chuỗi thành n luồng chỉ số: hàng i chứa phần thứ i của văn
# bản. Mỗi lô đọc n luồng song song cạnh nhau để mỗi luồng được
# nối tiếp từ lô này sang lô tiếp theo.
import torch

def make_streams(sequence, n):
    indices = torch.tensor([word_index[word] for word in sequence])
    length = len(indices) // n   # bỏ một vài từ cuối cùng
    return indices[:n * length].view(n, length)

train_streams = make_streams(train_sequence, 32)
val_streams = make_streams(val_sequence, 10)
test_streams = make_streams(test_sequence, 10)

print(f"\ntrain: {tuple(train_streams.shape)} (streams, words)")
first = [vocabulary[i] for i in train_streams[1, :8].tolist()]
print(f"start of stream 1: {' '.join(first)}")
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words

train: (32, 64122) (streams, words)
start of stream 1: . Antonio Imbert <unk> is one of the
Hint
Mã khởi đầu đã chia mỗi tập dữ liệu thành các luồng song song: train_streams có 32 hàng, trong đó hàng thứ i là mảnh văn bản thứ i. Đối với một đoạn (chunk) bắt đầu tại vị trí start, đầu vào của mạng là train_streams[:, start:start + 35], và nhãn mục tiêu (targets) chính là các cột đó dịch sang phải một vị trí: train_streams[:, start + 1:start + 36].
Hint
Hãy viết mô hình dưới dạng một lớp con của nn.Module tương tự bài tập 7.2b, sử dụng nn.Embedding(V, D), nn.LSTM(D, H, batch_first=True) và nn.Linear(H, V), đồng thời khởi tạo các vector nhúng có giá trị nhỏ giống như ở bài tập 4.2. Lớp LSTM nhận trạng thái (h, c) do đoạn trước để lại (hoặc None đối với đoạn đầu tiên), và trả về chuỗi trạng thái tại mọi vị trí cùng với trạng thái mới (h, c). Hàm mất mát F.cross_entropy yêu cầu điểm số đầu ra phải có dạng ma trận với mỗi hàng ứng với một vị trí: hãy định hình lại (reshape) điểm số bằng scores.reshape(-1, V) và nhãn mục tiêu bằng y.reshape(-1).
Hint
Trước khi bước vào mỗi đoạn mới, hãy thay trạng thái bằng (h.detach(), c.detach()): các giá trị số trong trạng thái vẫn được giữ nguyên để truyền đi tiếp, nhưng PyTorch sẽ ngắt không cho gradient truyền ngược về các đoạn trước đó. Nếu thiếu bước .detach() này, lệnh backward() sẽ cố gắng lan truyền ngược qua toàn bộ văn bản đã đọc từ đầu đến giờ.
Hint
Hãy huấn luyện với bộ tối ưu hóa Adam (tốc độ học 0.002) và cắt tỉa gradient ở mức 1.0. Một kỷ nguyên bao gồm 1,832 đoạn và mất khoảng hai phút rưỡi trên CPU laptop. Khi sinh văn bản mới, hãy đưa từng từ một vào mạng và giữ lại trạng thái ẩn từ từ này sang từ kế tiếp.
Điểm kiểm tra kết quả bạn cần đạt được
Độ hỗn loạn trên tập xác thực (validation perplexity) đạt 204.9 sau kỷ nguyên đầu tiên, giảm xuống 168.4 sau kỷ nguyên thứ hai, và tăng nhẹ lên 169.2 sau kỷ nguyên thứ ba (dấu hiệu mô hình bắt đầu quá khớp). Độ hỗn loạn trên tập kiểm tra (test perplexity) của mô hình ở kỷ nguyên thứ 2 đạt 155.8. Đoạn văn bản sinh ra trên máy bạn sẽ khác nhau tùy thuộc vào hạt giống ngẫu nhiên, nhưng nhìn chung sẽ giống như các mảnh câu trên Wikipedia được ghép nối lại với nhau. Nếu chạy trên GPU, các con số có thể xê dịch đôi chút.
epoch 1: validation perplexity 204.9
epoch 2: validation perplexity 168.4
epoch 3: validation perplexity 169.2

test perplexity, epoch 2: 155.8

The Ancients glazing to stop this thing . The episode follows recording essentially the John Jervois list of Labour Justice in 1758 for this early weeks . Critical reception of the United States , the USA Medicine Treaty of Away Games ( Bass in December 2006 ) <unk> ( the
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

wikitext = load_dataset("Salesforce/wikitext", "wikitext-2-v1")


# (1) Tạo chuỗi huấn luyện bằng cách tách mỗi dòng theo khoảng trắng
# [Sao chép từ lời giải bài 2.1, bước (1)]
train_sequence = []
for line in wikitext["train"]["text"]:
    train_sequence.extend(line.split())

print(f"text: {len(train_sequence)} words")
print(f"vocabulary: {len(set(train_sequence))} words")


# Chuỗi xác thực và chuỗi kiểm tra, được tạo theo cùng cách
# [Sao chép từ phần khởi đầu bài 2.2]
val_sequence = []
for line in wikitext["validation"]["text"]:
    val_sequence.extend(line.split())

test_sequence = []
for line in wikitext["test"]["text"]:
    test_sequence.extend(line.split())

print(f"validation: {len(val_sequence)} words")
print(f"test: {len(test_sequence)} words")


# Gán một chỉ số cho mỗi từ trong từ vựng
# [Sao chép từ phần khởi đầu bài 4.2]
vocabulary = sorted(set(train_sequence))
word_index = {word: i for i, word in enumerate(vocabulary)}


# ----------------------
#  Mới trong bài tập này
# ----------------------
# Cắt chuỗi thành n luồng chỉ số: hàng i chứa phần thứ i của văn
# bản. Mỗi lô đọc n luồng song song cạnh nhau để mỗi luồng được
# nối tiếp từ lô này sang lô tiếp theo.
import torch

def make_streams(sequence, n):
    indices = torch.tensor([word_index[word] for word in sequence])
    length = len(indices) // n   # bỏ một vài từ cuối cùng
    return indices[:n * length].view(n, length)

train_streams = make_streams(train_sequence, 32)
val_streams = make_streams(val_sequence, 10)
test_streams = make_streams(test_sequence, 10)

print(f"\ntrain: {tuple(train_streams.shape)} (streams, words)")
first = [vocabulary[i] for i in train_streams[1, :8].tolist()]
print(f"start of stream 1: {' '.join(first)}")
text: 2051910 words
vocabulary: 33277 words
validation: 213886 words
test: 241211 words

train: (32, 64122) (streams, words)
start of stream 1: . Antonio Imbert <unk> is one of the
# (1) Mô hình: tầng nhúng, mạng LSTM và điểm số cho từng từ trong
# từ vựng tại mỗi vị trí. forward() nhận trạng thái từ đoạn trước
# để lại và trả về trạng thái mới. Khởi tạo các vector nhúng nhỏ
# như ở bài 4.2.
from torch import nn
import torch.nn.functional as F

class LSTMLanguageModel(nn.Module):
    def __init__(self, V, D, H):
        super().__init__()
        self.embedding = nn.Embedding(V, D)
        self.lstm = nn.LSTM(D, H, batch_first=True)
        self.output = nn.Linear(H, V)

    def forward(self, x, state=None):
        e = self.embedding(x)            # (batch, steps, D)
        h, state = self.lstm(e, state)   # (batch, steps, H)
        return self.output(h), state     # (batch, steps, V)

device = "cuda" if torch.cuda.is_available() else "cpu"
V = len(vocabulary)
torch.manual_seed(0)
model = LSTMLanguageModel(V, D=256, H=256).to(device)
nn.init.normal_(model.embedding.weight, std=0.1)


# (2) Các đoạn dài 35 từ: x chứa các từ của đoạn, y chứa các từ
# theo sau chúng ở vị trí kế tiếp
steps = 35

def chunks(streams):
    pairs = []
    for start in range(0, streams.shape[1] - 1, steps):
        y = streams[:, start + 1:start + 1 + steps]
        x = streams[:, start:start + y.shape[1]]
        pairs.append((x.to(device), y.to(device)))
    return pairs


# (3) Độ hỗn loạn (perplexity) trên một tập luồng, đọc nối tiếp
# từng đoạn và truyền trạng thái qua các đoạn
import math

def perplexity(model, streams):
    total_loss, count, state = 0, 0, None
    with torch.no_grad():
        for x, y in chunks(streams):
            scores, state = model(x, state)
            total_loss += F.cross_entropy(scores.reshape(-1, V),
                                          y.reshape(-1),
                                          reduction="sum").item()
            count += y.numel()
    return math.exp(total_loss / count)


# (4) Huấn luyện với Adam và cắt ngưỡng đạo hàm. Trạng thái được
# truyền từ đoạn này sang đoạn tiếp theo, nhưng detach() cắt liên
# kết với các đoạn trước để đạo hàm dừng lại ở đoạn hiện tại.
import copy

optimizer = torch.optim.Adam(model.parameters(), lr=2e-3)
best_perplexity = math.inf
for epoch in range(3):
    state = None
    for x, y in chunks(train_streams):
        if state is not None:
            state = (state[0].detach(), state[1].detach())
        scores, state = model(x, state)
        loss = F.cross_entropy(scores.reshape(-1, V), y.reshape(-1))
        optimizer.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
    val_perplexity = perplexity(model, val_streams)
    print(f"epoch {epoch + 1}: validation perplexity "
          f"{val_perplexity:.1f}")
    if val_perplexity < best_perplexity:
        best_perplexity, best_epoch = val_perplexity, epoch + 1
        best_model = copy.deepcopy(model)


# (5) Độ hỗn loạn trên tập kiểm tra của mô hình tốt nhất
test_perplexity = perplexity(best_model, test_streams)
print(f"\ntest perplexity, epoch {best_epoch}: {test_perplexity:.1f}")


# (6) Sinh 50 từ, từng từ một: trạng thái mang thông tin của toàn
# bộ các từ đã sinh cho đến thời điểm hiện tại
first_word = "The"
length = 50
torch.manual_seed(0)
sample_words = [first_word]
x = torch.tensor([[word_index[first_word]]]).to(device)
state = None
with torch.no_grad():
    for _ in range(length - 1):
        scores, state = best_model(x, state)
        probabilities = torch.softmax(scores[0, -1], dim=0)
        next_index = torch.multinomial(probabilities, 1).item()
        sample_words.append(vocabulary[next_index])
        x = torch.tensor([[next_index]]).to(device)
print(f"\n{' '.join(sample_words)}")
epoch 1: validation perplexity 204.9
epoch 2: validation perplexity 168.4
epoch 3: validation perplexity 169.2

test perplexity, epoch 2: 155.8

The Ancients glazing to stop this thing . The episode follows recording essentially the John Jervois list of Labour Justice in 1758 for this early weeks . Critical reception of the United States , the USA Medicine Treaty of Away Games ( Bass in December 2006 ) <unk> ( the
Chỉ sau một kỷ nguyên duy nhất, mạng LSTM đã vượt qua mọi mô hình ngôn ngữ ở mục 2 và mục 4: đạt mức perplexity 204.9 trên tập xác thực, so với 223.9 của mô hình Bengio ở kỷ nguyên tốt nhất. Độ hỗn loạn trên tập kiểm tra của nó (155.8) thấp hơn 25% so với mức 208.5 của mô hình Bengio, và thấp hơn 29% so với mức 219.3 của mô hình 5-gram Kneser-Ney, trong khi thời gian huấn luyện chỉ tương đương mô hình của Bengio. Sự khác biệt nằm ở độ rộng của ngữ cảnh: mô hình của Bengio chỉ nhìn thấy 3 từ gần nhất, còn trạng thái của LSTM mang theo thông tin tích lũy kể từ đầu luồng văn bản. Hãy nhìn vào đoạn văn bản mẫu được sinh ra: mô hình mở một dấu ngoặc đơn trong cụm ( Bass in December 2006 ), rồi đóng ngoặc lại một cách chính xác sau đó bốn từ. Tại thời điểm đóng ngoặc, dấu mở ngoặc đã trôi ra ngoài cửa sổ 3 từ cuối, nên mô hình của Bengio chỉ có thể đoán mò, trong khi LSTM vẫn lưu giữ được thông tin đó trong trạng thái của mình. Dù vậy, đoạn văn bản sinh ra vẫn mất đi tính mạch lạc về ngữ nghĩa khi vượt quá phạm vi vài từ: trạng thái ẩn nhớ được những cấu trúc cục bộ như việc đang mở ngoặc đơn, nhưng chưa đủ sức nắm bắt chủ đề xuyên suốt của cả đoạn văn. Nhờ ngữ cảnh không còn bị giới hạn trong một cửa sổ cố định, mạng LSTM dự đoán từ tiếp theo tốt hơn hẳn các mô hình ở mục 2 và mục 4.
Mạng LSTM của chúng ta ở bài tập trên có kích thước khá nhỏ và mới chỉ được huấn luyện trong 3 kỷ nguyên. Những mô hình LSTM tốt nhất vào năm 2016 trên tập dữ liệu WikiText-2 có tới hai tầng, mỗi tầng gồm 650 đơn vị ẩn, và được điều chuẩn (regularized) bằng kỹ thuật dropout: trong quá trình huấn luyện, một số thành phần ngẫu nhiên trong các vector của mạng bị gán bằng 0 để buộc mạng không được phụ thuộc quá mức vào bất kỳ thành phần đơn lẻ nào. Zaremba và cộng sự đã áp dụng dropout cho các vector nhúng và cho các trạng thái truyền từ tầng này lên tầng kế tiếp, nhưng không áp dụng cho trạng thái truyền từ từ này sang từ tiếp theo: bởi việc chèn thêm các số 0 ngẫu nhiên mới ở mỗi bước từ sẽ xóa sổ luôn những thông tin mà mạng đang cố ghi nhớ (Zaremba et al., 2014). Sau đó, Gal và Ghahramani đã chứng minh rằng hoàn toàn có thể áp dụng dropout lên cả trạng thái truy hồi này, miễn là ta giữ cố định cùng một mặt nạ các thành phần bị gán bằng 0 tại mọi bước từ trong suốt một chuỗi (Gal & Ghahramani, 2016). Với kỹ thuật dropout biến phân (variational dropout) này, một mạng LSTM hai tầng đã giảm được perplexity trên tập kiểm tra của WikiText-2 xuống còn 96.3, và xuống tới 80.8 khi kết hợp thêm một cơ chế cho phép sao chép các từ vừa xuất hiện trong đoạn văn bản gần đó (Merity et al., 2016). Ở mục 8, chúng ta sẽ còn gặp một mô hình LSTM xuất sắc hơn nữa.
Giống như các mô hình n-gram, mô hình ngôn ngữ RNN có thể được dùng để sinh văn bản: lấy mẫu từ tiếp theo dựa trên phân phối xác suất mà mạng dự đoán, đưa từ vừa sinh ra quay trở lại làm đầu vào cho bước kế tiếp, và cứ thế lặp lại. Mạng RNN đã làm cho kỹ thuật sinh văn bản này trở nên cực kỳ nổi tiếng ở cấp độ ký tự (character-level). Thay vì xử lý từng từ, mô hình đọc và dự đoán từng ký tự một với bộ từ vựng chỉ gồm vài chục ký hiệu. Trong một bài viết blog nổi tiếng năm 2015, Andrej Karpathy đã huấn luyện các mạng LSTM cấp độ ký tự như vậy trên tuyển tập tác phẩm của Shakespeare, trên Wikipedia, trên các tệp tài liệu toán học LaTeX và cả trên mã nguồn nhân hệ điều hành Linux (Karpathy, 2015). Như ông nhận xét về mô hình học Shakespeare: “tất cả những gì mạng RNN biết chỉ là các ký tự, vì vậy nó tự lấy mẫu sinh ra cả tên nhân vật lẫn lời thoại”. Hình tương tác dưới đây trình bày các đoạn văn bản mẫu được sinh ra bởi một mạng LSTM nhỏ cấp độ ký tự huấn luyện trên tập dữ liệu TinyShakespeare qua từng giai đoạn huấn luyện.
Ở thời điểm ban đầu, các ký tự được rút ra hoàn toàn ngẫu nhiên. Sau 100 lô huấn luyện, mô hình đã học được cách đặt khoảng trắng, xuống dòng và viết đúng một vài từ ngắn. Sau 300 lô, nó đã nắm được định dạng trình bày của một vở kịch: tên nhân vật viết hoa toàn bộ theo sau bởi dấu hai chấm, rồi đến lời thoại của nhân vật đó — ví dụ như GOLUTE:, một cái tên mà Shakespeare chưa từng viết. Sau 1,000 lô, tên các nhân vật đã trở thành tên thật trong tác phẩm (như JULIET hay FRIAR LAURENCE), và phần lớn các từ đều là từ tiếng Anh chuẩn xác, dù ghép lại thành những câu chưa có ý nghĩa hoàn chỉnh.
Từ đầu chương đến giờ, đơn vị xử lý cơ bản của chúng ta luôn là từ (words). Một mô hình cấp độ từ có bộ từ vựng cố định: chẳng hạn trong WikiText-2, chỉ những từ xuất hiện ít nhất 3 lần trong tập huấn luyện mới được giữ lại, còn mọi từ khác đều bị thay thế bằng ký hiệu <unk>. Một từ nằm ngoài từ vựng — như tên riêng “Zendaya” hay tính từ “flabbergasting” ở mục 3 — sẽ trở nên vô hình đối với mô hình, hoặc cùng lắm chỉ được nhìn nhận như một thẻ <unk> chung chung không mang chút thông tin nào. Hơn nữa, mỗi từ nhận một vector nhúng riêng biệt và được học độc lập, nên mô hình buộc phải học hai từ “film” và “films” như hai thực thể hoàn toàn tách rời.
Xử lý ở cấp độ ký tự (characters) giải quyết triệt để vấn đề từ ngoài từ vựng: tập dữ liệu TinyShakespeare chỉ có vỏn vẹn 65 ký tự khác nhau, và bất kỳ từ nào cũng có thể được ghép nên từ chúng, kể cả những từ mà mô hình chưa từng gặp bao giờ. Thế nhưng, một văn bản tính theo ký tự sẽ dài gấp khoảng 5 lần so với tính theo từ, đồng nghĩa với việc mạng RNN phải truyền tải thông tin qua số bước thời gian nhiều gấp 5 lần — mà đây lại chính là điểm yếu cố hữu của RNN như chúng ta đã phân tích ở mục 7.2. Chưa kể, mô hình còn phải tốn công học cách đánh vần từng chữ trước khi có thể học bất cứ điều gì về ngữ nghĩa.
Cần lưu ý rằng không thể so sánh trực tiếp độ hỗn loạn (perplexity) được đo trên các đơn vị khác nhau. Xác suất mà một mô hình gán cho toàn bộ văn bản không phụ thuộc vào cách chia đơn vị, nhưng công thức tính perplexity lại lấy logarit của xác suất đó chia cho số lượng đơn vị (số từ, số ký tự, hoặc đơn vị bất kỳ). Chẳng hạn, mạng LSTM cấp độ ký tự ở hình trên kết thúc với mức mất mát 2.0 bit trên mỗi ký tự đối với tập xác thực của TinyShakespeare: tương đương mức perplexity bằng trên mỗi ký tự — thoạt nhìn tưởng như tốt hơn rất nhiều so với con số hàng trăm của các mô hình cấp độ từ. Tuy nhiên, văn bản này có trung bình 5.5 ký tự trên mỗi từ (tính cả khoảng trắng và dấu câu), nên cùng một xác suất đó khi quy đổi sang từ sẽ tương ứng với bit trên mỗi từ: tức mức perplexity khoảng trên mỗi từ! Do đó, muốn so sánh công bằng một mô hình cấp độ ký tự với một mô hình cấp độ từ, ta phải chia log-xác suất của cùng một văn bản cho cùng một mẫu số — chẳng hạn như tổng số từ của văn bản đó.
Từ phụ (subwords) chính là giải pháp dung hòa được các mô hình ngôn ngữ hiện đại lựa chọn: những từ phổ biến được giữ nguyên làm một đơn vị độc lập, còn những từ hiếm sẽ được tách nhỏ thành các mảnh phổ biến hơn. Thuật toán mã hóa cặp byte (Byte-Pair Encoding – BPE) (Sennrich et al., 2016) xây dựng một bộ từ vựng như vậy trực tiếp từ văn bản huấn luyện: xuất phát từ các ký tự đơn lẻ, thuật toán lặp đi lặp lại việc gộp cặp ký hiệu liên tiếp xuất hiện nhiều nhất thành một ký hiệu mới cho đến khi bộ từ vựng đạt kích thước mong muốn. Với từ phụ, không còn từ nào bị coi là từ lạ (<unk>), trong khi độ dài chuỗi văn bản chỉ tăng lên đôi chút so với khi tách theo từ. Đây chính là cơ chế hoạt động của các bộ tách từ (tokenizers) — chủ đề sẽ được trình bày chi tiết ở chương tiếp theo.
Nếu muốn tìm hiểu sâu hơn, bạn có thể thử sức với một số bài tập mở rộng dưới đây.
Mạng RNN thuần túy. Hãy thay thế lớp LSTM trong bài tập 7.2b bằng lớp nn.RNN. Mô hình có học được không? Độ chính xác của nó kém mạng LSTM bao nhiêu điểm phần trăm?
Mạng GRU. Hãy thay thế lớp LSTM bằng nn.GRU trong cả hai bài tập 7.2b và 7.3. Kiến trúc nào hội tụ nhanh hơn, và kiến trúc nào đạt kết quả cuối cùng tốt hơn?
Mở sẵn cổng quên. Trước khi huấn luyện mạng LSTM ở bài tập 7.2b, hãy khởi tạo độ chệch (bias) của cổng quên bằng 1 theo đúng khuyến nghị của Jozefowicz và cộng sự (Jozefowicz et al., 2015). Độ chính xác trên tập xác thực có tăng lên nhanh hơn ở những kỷ nguyên đầu không?
Huấn luyện không cắt tỉa gradient. Hãy huấn luyện mô hình ngôn ngữ ở bài tập 7.3 mà không sử dụng kỹ thuật cắt tỉa gradient (gradient clipping), đồng thời tăng tốc độ học lên 0.01. Hãy vẽ đồ thị hàm mất mát sau từng lô (batch): bạn có quan sát thấy những cú nhảy vọt (spikes) của hàm mất mát không?
Dòng chảy gradient trong mô hình đã huấn luyện. Hãy lặp lại thí nghiệm ở bài tập 7.2a nhưng sử dụng mạng LSTM đã được huấn luyện xong ở bài tập 7.2b, chạy trên các vector nhúng của một bài đánh giá thực tế dài 400 từ. Những từ nào trong bài đánh giá nhận được gradient lớn nhất?
Mạng tích chập (Convolutions). Hãy huấn luyện mạng nơ-ron tích chập của Kim (Kim, 2014) trên tập dữ liệu IMDB: sử dụng các cửa sổ trượt kích thước 3, 4 và 5 từ, trích xuất 100 đặc trưng cho mỗi kích thước, lấy cực đại (max pooling) dọc theo các vị trí, rồi đưa qua đầu dự đoán logistic. Trong PyTorch, lớp nn.Conv1d giúp áp dụng cùng một mạng nhỏ lên mọi cửa sổ của văn bản. Kết quả của nó so với mạng LSTM ra sao? Độ chính xác thay đổi thế nào khi thứ tự từ trong các bài đánh giá kiểm tra bị xáo trộn?
Mô hình cấp độ ký tự. Hãy huấn luyện một mạng LSTM cấp độ ký tự trên tập dữ liệu TinyShakespeare (jchwenger/tiny_shakespeare, tải với tùy chọn sample_by="document"), và quan sát các đoạn văn bản mẫu được sinh ra trong suốt quá trình huấn luyện giống như hình minh họa ở mục 7.3. Hãy so sánh chúng với các mẫu sinh ra từ mô hình n-gram ký tự ở phần bài tập mở rộng của mục 2.3.
8. Tiền huấn luyện toàn bộ bộ mã hóa (Pre-training the whole encoder)
Ở cuối mục 7, mạng LSTM đã biết đọc các từ theo đúng thứ tự xuất hiện, nhưng trên tập dữ liệu IMDB nó vẫn không vượt qua được mô hình túi từ (bag of words). Nguyên nhân là nó phải học tất cả mọi thứ từ con số không chỉ với 20,000 bài đánh giá có nhãn: từ các vector nhúng của từ vựng, cho đến việc thông tin nào cần giữ lại trong trạng thái ẩn và khi nào thì nên quên đi. Mục 5 đã gợi mở cho chúng ta một phần lời giải: hãy học các vector nhúng trên văn bản thô trước. Thế nhưng ở đó, mới chỉ có tầng đầu tiên của mạng được tiền huấn luyện (pre-trained), còn toàn bộ phần mạng phía trên vẫn phải khởi tạo ngẫu nhiên và học lại từ đầu.
Bài tập 7.3 gợi ý cho chúng ta một bước tiến xa hơn. Bản thân một mô hình ngôn ngữ chính là một mạng LSTM được huấn luyện trên văn bản thô, và phần nhúng từ cùng khối LSTM của nó có cấu trúc giống hệt như bộ mã hóa (encoder) của bộ phân loại ở bài tập 7.2b. Vậy tại sao không tiền huấn luyện toàn bộ bộ mã hóa dưới dạng một mô hình ngôn ngữ trước, sau đó sao chép nó sang bộ phân loại rồi tinh chỉnh (fine-tune) trên các bài đánh giá có nhãn? Khi đó, chỉ có duy nhất phần đầu dự đoán (head) là phải học từ đầu. Còn tầng đầu ra của mô hình ngôn ngữ — vốn dùng để tính xác suất cho từ tiếp theo — sẽ đơn giản được lược bỏ đi.
Đây lại chính là câu hỏi lớn thứ hai được đặt ra từ phần mở đầu: chúng ta có thể chuyển giao (transfer) những gì từ bài toán này sang bài toán khác? Mục 5 đã chuyển giao tầng đầu tiên của mạng nơ-ron. Mục 8 này sẽ chuyển giao toàn bộ bộ mã hóa (encoder). Và đến mục 10, chúng ta sẽ chạm tới những mô hình mà ở đó không cần phải huấn luyện lại bất kỳ thành phần nào cho bài toán đích nữa.
8.1 Tiền huấn luyện bộ mã hóa rồi tinh chỉnh (Pre-train, then fine-tune)
Andrew Dai và Quoc Le (Lê Viết Quốc) tại Google đã kiểm chứng ý tưởng này trên bài toán phân loại văn bản vào năm 2015 (Dai & Le, 2015). Họ tiền huấn luyện một mạng LSTM gồm 1,024 đơn vị ẩn làm mô hình ngôn ngữ, sử dụng cả các vector nhúng lẫn mạng LSTM đó để khởi tạo bộ phân loại, rồi tinh chỉnh toàn bộ mạng trên các bài đánh giá có nhãn. Trên tập dữ liệu IMDB, độ chính xác đã tăng vọt từ 86.5% (khi huấn luyện cùng mạng LSTM đó từ đầu) lên tới 92.4% — cao hơn 4 điểm phần trăm so với các mô hình túi từ của chúng ta ở mục 3. Nếu chỉ khởi tạo riêng tầng nhúng bằng các vector word2vec học trên chính các bài đánh giá đó, độ chính xác chỉ đạt 90.0%. Nhóm tác giả cũng thử nghiệm một tác vụ tiền huấn luyện thứ hai gọi là bộ tự mã hóa chuỗi (sequence autoencoder): đọc toàn bộ bài đánh giá, sau đó viết lại chính bài đánh giá đó từng từ một, xuất phát từ trạng thái ẩn cuối cùng. Cách này còn mang lại kết quả nhỉnh hơn một chút, đạt 92.8%. Hơn nữa, các mạng LSTM đã qua tiền huấn luyện cũng ổn định và dễ huấn luyện hơn hẳn. Họ viết rằng nếu huấn luyện từ đầu: “chỉ cần chúng tôi tăng số lượng đơn vị ẩn hoặc tăng số bước lan truyền ngược, quá trình huấn luyện sẽ sụp đổ rất nhanh chóng”.
Hãy thử nghiệm quy trình này với mạng LSTM của chính chúng ta. Tập gồm 50,000 bài đánh giá không nhãn của IMDB (phần unsupervised của bộ dữ liệu) sinh ra là để dành cho việc này: hơn 10 triệu từ có cùng văn phong và chủ đề với các bài đánh giá có nhãn — lớn gấp năm lần tập WikiText-2. Chúng ta sẽ tiền huấn luyện bộ mã hóa ở bài tập 7.2b trên kho văn bản không nhãn này như một mô hình ngôn ngữ, sau đó kiểm tra những gì nó chuyển giao được theo hai cách. Thứ nhất, ta đóng băng (freeze) bộ mã hóa và chỉ huấn luyện một bộ hồi quy logistic đặt trên trạng thái ẩn cuối cùng của nó. Nếu mô hình ngôn ngữ đã tự học được cách theo dõi sắc thái cảm xúc của bài đánh giá (bởi nắm được cảm xúc sẽ giúp dự đoán các từ tiếp theo chính xác hơn), thì bộ hồi quy logistic sẽ tìm thấy thông tin đó ngay trong trạng thái cuối. Thứ hai, ta tinh chỉnh bộ phân loại của bài tập 7.2b từ bộ mã hóa đã tiền huấn luyện trên chỉ 1,000 bài đánh giá có nhãn: như bài tập 5.5b đã chỉ ra, bối cảnh ít dữ liệu có nhãn chính là nơi kỹ thuật tiền huấn luyện phát huy giá trị rõ rệt nhất.
Bài tập 8.1★ Tiền huấn luyện mạng LSTM làm mô hình ngôn ngữ
Hãy tiền huấn luyện bộ mã hóa của bài tập 7.2b (gồm tầng nhúng và mạng LSTM, với , ) dưới dạng một mô hình ngôn ngữ trên 50,000 bài đánh giá không nhãn của IMDB trong 1 kỷ nguyên (epoch), sử dụng bộ từ vựng của bài tập 3.2. Hãy đo độ hỗn loạn (perplexity) của nó trên các bài đánh giá thuộc tập xác thực, và sinh tiếp phần còn lại của một bài đánh giá bắt đầu bằng cụm từ "this movie". Tiếp theo, hãy đo xem trạng thái của mạng biết được bao nhiêu về cảm xúc: đóng băng bộ mã hóa, huấn luyện một bộ hồi quy logistic trên trạng thái ẩn cuối cùng của nó, rồi so sánh với chính mạng LSTM đó khi chưa qua huấn luyện. Cuối cùng, hãy tinh chỉnh bộ phân loại của bài tập 7.2b trên 1,000 bài đánh giá có nhãn theo ba cách khởi tạo: huấn luyện từ đầu (from scratch), chỉ chép các vector nhúng từ mô hình ngôn ngữ, và chép cả vector nhúng lẫn mạng LSTM; lấy trung bình độ chính xác trên tập kiểm tra qua 3 lần rút ngẫu nhiên 1,000 bài đánh giá.
Mã khởi đầu đã thực hiện sẵn bước (1) trong lời giải của bài tập 3.2, kèm theo bộ từ vựng và lớp LSTMClassifier của bài tập 7.2b. Nó cũng đã chuyển đổi 50,000 bài đánh giá không nhãn thành danh sách các chỉ số từ.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# Từ vựng của bài 3.2: 10.000 từ phổ biến nhất trong các bài đánh
# giá huấn luyện. build_analyzer() trả về hàm mà CountVectorizer
# dùng để tách văn bản thành các từ.
# [Sao chép từ phần khởi đầu bài 7.2b]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
vectorizer.fit(train_texts)
split_words = vectorizer.build_analyzer()
word_index = {word: int(i)   # từ -> chỉ số, từ 0 đến V - 1
              for word, i in vectorizer.vocabulary_.items()}
V = len(word_index)

# Chuyển mỗi bài đánh giá thành danh sách chỉ số các từ theo đúng
# thứ tự. Các từ ngoài từ vựng nhận chỉ số V. Chỉ giữ lại 400 từ
# cuối cùng đối với các bài đánh giá dài.
# [Sao chép từ phần khởi đầu bài 7.2b]
max_length = 400

def to_indices(text):
    indices = [word_index.get(word, V) for word in split_words(text)]
    return indices[-max_length:]

train_sequences = [to_indices(text) for text in train_texts]
val_sequences = [to_indices(text) for text in val_texts]
test_sequences = [to_indices(text) for text in test_texts]


# (1) Mô hình: tầng nhúng từ (thêm một hàng cho từ chưa biết), một
# mạng LSTM đọc chúng theo thứ tự, và một đầu phân loại đọc trạng
# thái cuối cùng. Các bài đánh giá trong cùng một lô có độ dài khác
# nhau: đệm thêm các số 0 để có cùng độ dài và đóng gói kèm độ dài
# thực để LSTM dừng ở từ cuối của mỗi bài mà không đọc phần đệm.
# [Sao chép từ lời giải bài 7.2b, bước (1)]
import torch
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"

class LSTMClassifier(nn.Module):
    def __init__(self, V, D, H):
        super().__init__()
        self.embedding = nn.Embedding(V + 1, D)   # + từ chưa biết
        self.lstm = nn.LSTM(D, H, batch_first=True)
        self.head = nn.Linear(H, 1)   # p(positive) = sigmoid

    def forward(self, sequences):
        lengths = torch.tensor([len(s) for s in sequences])
        padded = nn.utils.rnn.pad_sequence(
            [torch.tensor(s) for s in sequences], batch_first=True)
        x = self.embedding(padded.to(device))   # (batch, L, D)
        packed = nn.utils.rnn.pack_padded_sequence(
            x, lengths, batch_first=True, enforce_sorted=False)
        _, (h, c) = self.lstm(packed)   # h: (1, batch, H)
        return self.head(h[0])[:, 0]   # điểm số của mỗi bài đánh giá

torch.manual_seed(0)
model = LSTMClassifier(V, D=100, H=128).to(device)


# ----------------------
#  Mới trong bài tập này
# ----------------------
# 50.000 bài đánh giá không gán nhãn của IMDB, được chuyển thành
# danh sách chỉ số từ theo cùng một cách
unlabeled_texts = clean(imdb["unsupervised"]["text"])
unlabeled_sequences = [to_indices(text) for text in unlabeled_texts]
n_words = sum(len(sequence) for sequence in unlabeled_sequences)

print(f"\nunlabeled: {len(unlabeled_sequences)} reviews, "
      f"{n_words} words")
print(split_words(unlabeled_texts[0])[:10])
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews

unlabeled: 50000 reviews, 10565838 words
['this', 'is', 'just', 'a', 'precious', 'little', 'diamond', 'the', 'play', 'the']
Hint
Hãy viết mô hình ngôn ngữ giống như ở bài tập 7.3, sử dụng nn.Embedding(V + 1, D), nn.LSTM(D, H, batch_first=True) và nn.Linear(H, V + 1): ở đây từ lạ ngoài từ vựng (chỉ số V) được coi như một từ nữa cần dự đoán. Hãy đặt tên thuộc tính tầng nhúng và mạng LSTM giống hệt như trong lớp bộ phân loại ở bài tập 7.2b (embedding và lstm) để lát nữa có thể dễ dàng sao chép trọng số sang bộ phân loại.
Hint
Mỗi bài đánh giá là một chuỗi huấn luyện độc lập: đầu vào là tất cả các từ trừ từ cuối cùng, còn nhãn mục tiêu (targets) là tất cả các từ trừ từ đầu tiên. Hàm pad_sequence sẽ đệm thêm vào cuối những bài đánh giá ngắn trong cùng một lô. Vì LSTM đọc từ trái sang phải nên phần đệm ở cuối hoàn toàn không làm thay đổi trạng thái ẩn tại các từ thực sự phía trước. Hãy đệm nhãn mục tiêu bằng giá trị -100: hàm F.cross_entropy của PyTorch sẽ tự động bỏ qua các vị trí mang nhãn -100 này. Điểm số dự đoán (scores) của một lô có kích thước (batch, L, V + 1): để tính perplexity trên tập xác thực, hãy chia nhỏ từng cụm 50 bài đánh giá một, bởi nếu tính gộp cả 500 bài cùng lúc thì tensor điểm số sẽ ngốn tới 8 GB bộ nhớ RAM.
Hint
Hãy huấn luyện với bộ tối ưu hóa Adam (tốc độ học 0.002) và cắt tỉa gradient ở mức 1.0 giống như bài tập 7.3. Một kỷ nguyên gồm 782 lô (mỗi lô 64 bài đánh giá), mất khoảng bốn phút trên CPU laptop.
Hint
Đối với phần hồi quy logistic, hãy trích xuất trạng thái ẩn ngay sau từ cuối cùng của mỗi bài đánh giá: chạy mạng LSTM trên một lô đã đệm, sau đó ứng với mỗi bài đánh giá, lấy vector trạng thái tại đúng vị trí từ cuối cùng của nó là lengths - 1. Lớp LogisticRegression của thư viện scikit-learn sẽ nhận ma trận đặc trưng gồm 20,000 hàng và 128 cột này, tương tự như cách nó nhận ma trận đếm từ ở bài tập 3.2.
Hint
Để thực hiện tinh chỉnh (fine-tune), hãy khởi tạo một đối tượng LSTMClassifier mới, rồi sao chép các thành phần từ mô hình ngôn ngữ sang: model.embedding.load_state_dict(language_model.embedding.state_dict()), và làm tương tự với lstm. Sau đó, huấn luyện mô hình giống như bài tập 5.5b: chạy 400 lô, mỗi lô lấy ngẫu nhiên 32 bài đánh giá từ tập 1,000 bài (random.choices), và giữ lại phiên bản mô hình có độ chính xác trên tập xác thực cao nhất (đo sau mỗi 50 lô). Vì khi chỉ có 1,000 bài đánh giá, độ chính xác dao động khá nhiều tùy thuộc vào mẫu rút ngẫu nhiên, nên hãy lấy trung bình kết quả qua 3 lần rút mẫu khác nhau.
Điểm kiểm tra kết quả bạn cần đạt được
Sau một kỷ nguyên, độ hỗn loạn trên tập xác thực (validation perplexity) đạt 212.1, và đoạn văn bản sinh thử nghiệm đã mang đậm từ vựng của các bài đánh giá phim (“believable”, “gore”, “sci fi story”) dù các câu ghép lại chưa thực sự có nghĩa. Bộ hồi quy logistic đặt trên trạng thái ẩn cuối cùng đoán đúng 57.7% các bài đánh giá kiểm tra, so với 54.8% của chính mạng LSTM đó khi chưa qua huấn luyện. Khi tinh chỉnh trên 1,000 bài đánh giá có nhãn, bộ phân loại đạt độ chính xác 65.3% nếu huấn luyện từ đầu, tăng lên 70.2% nếu khởi tạo từ các vector nhúng của mô hình ngôn ngữ, nhưng lại giảm xuống 68.2% nếu khởi tạo từ cả vector nhúng lẫn mạng LSTM. Toàn bộ lời giải mất khoảng 16 phút trên CPU laptop (phần lớn thời gian nằm ở 9 lần chạy tinh chỉnh). Kết quả của bạn có thể chênh lệch khoảng 1 điểm phần trăm.
validation perplexity: 212.1

this movie isn t believable i m leaving the apocalypse wretched gore moments this is while i have to add here sci construction and allows married and make a happy riding you say i heard of sort of sci fi story it
LSTM before training: test accuracy 0.548
LSTM after training: test accuracy 0.577

fine-tuned on 1,000 labeled reviews:
  from scratch         test accuracy 0.653
  embeddings           test accuracy 0.702
  embeddings and LSTM  test accuracy 0.682
Lời giải 3 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# Từ vựng của bài 3.2: 10.000 từ phổ biến nhất trong các bài đánh
# giá huấn luyện. build_analyzer() trả về hàm mà CountVectorizer
# dùng để tách văn bản thành các từ.
# [Sao chép từ phần khởi đầu bài 7.2b]
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(max_features=10000,
                             token_pattern=r"\b\w+\b")
vectorizer.fit(train_texts)
split_words = vectorizer.build_analyzer()
word_index = {word: int(i)   # từ -> chỉ số, từ 0 đến V - 1
              for word, i in vectorizer.vocabulary_.items()}
V = len(word_index)

# Chuyển mỗi bài đánh giá thành danh sách chỉ số các từ theo đúng
# thứ tự. Các từ ngoài từ vựng nhận chỉ số V. Chỉ giữ lại 400 từ
# cuối cùng đối với các bài đánh giá dài.
# [Sao chép từ phần khởi đầu bài 7.2b]
max_length = 400

def to_indices(text):
    indices = [word_index.get(word, V) for word in split_words(text)]
    return indices[-max_length:]

train_sequences = [to_indices(text) for text in train_texts]
val_sequences = [to_indices(text) for text in val_texts]
test_sequences = [to_indices(text) for text in test_texts]


# (1) Mô hình: tầng nhúng từ (thêm một hàng cho từ chưa biết), một
# mạng LSTM đọc chúng theo thứ tự, và một đầu phân loại đọc trạng
# thái cuối cùng. Các bài đánh giá trong cùng một lô có độ dài khác
# nhau: đệm thêm các số 0 để có cùng độ dài và đóng gói kèm độ dài
# thực để LSTM dừng ở từ cuối của mỗi bài mà không đọc phần đệm.
# [Sao chép từ lời giải bài 7.2b, bước (1)]
import torch
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"

class LSTMClassifier(nn.Module):
    def __init__(self, V, D, H):
        super().__init__()
        self.embedding = nn.Embedding(V + 1, D)   # + từ chưa biết
        self.lstm = nn.LSTM(D, H, batch_first=True)
        self.head = nn.Linear(H, 1)   # p(positive) = sigmoid

    def forward(self, sequences):
        lengths = torch.tensor([len(s) for s in sequences])
        padded = nn.utils.rnn.pad_sequence(
            [torch.tensor(s) for s in sequences], batch_first=True)
        x = self.embedding(padded.to(device))   # (batch, L, D)
        packed = nn.utils.rnn.pack_padded_sequence(
            x, lengths, batch_first=True, enforce_sorted=False)
        _, (h, c) = self.lstm(packed)   # h: (1, batch, H)
        return self.head(h[0])[:, 0]   # điểm số của mỗi bài đánh giá

torch.manual_seed(0)
model = LSTMClassifier(V, D=100, H=128).to(device)


# ----------------------
#  Mới trong bài tập này
# ----------------------
# 50.000 bài đánh giá không gán nhãn của IMDB, được chuyển thành
# danh sách chỉ số từ theo cùng một cách
unlabeled_texts = clean(imdb["unsupervised"]["text"])
unlabeled_sequences = [to_indices(text) for text in unlabeled_texts]
n_words = sum(len(sequence) for sequence in unlabeled_sequences)

print(f"\nunlabeled: {len(unlabeled_sequences)} reviews, "
      f"{n_words} words")
print(split_words(unlabeled_texts[0])[:10])
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews

unlabeled: 50000 reviews, 10565838 words
['this', 'is', 'just', 'a', 'precious', 'little', 'diamond', 'the', 'play', 'the']
# (1) Mô hình ngôn ngữ: tầng nhúng và mạng LSTM của bộ phân loại ở
# bài 7.2b, cùng tầng đầu ra chấm điểm cho từng từ trong từ vựng tại
# mỗi vị trí như ở bài 7.3. Các từ chưa biết (chỉ số V) là một từ
# nữa mà mô hình có thể dự đoán. Khởi tạo nhúng nhỏ như bài 4.2.
import torch.nn.functional as F

class LSTMLanguageModel(nn.Module):
    def __init__(self, V, D, H):
        super().__init__()
        self.embedding = nn.Embedding(V + 1, D)   # + từ chưa biết
        self.lstm = nn.LSTM(D, H, batch_first=True)
        self.output = nn.Linear(H, V + 1)

    def forward(self, x, state=None):
        e = self.embedding(x)            # (batch, steps, D)
        h, state = self.lstm(e, state)   # (batch, steps, H)
        return self.output(h), state     # (batch, steps, V + 1)

torch.manual_seed(0)
language_model = LSTMLanguageModel(V, D=100, H=128).to(device)
nn.init.normal_(language_model.embedding.weight, std=0.1)


# (2) Một lô bài đánh giá: đầu vào x gồm các từ của mỗi bài trừ từ
# cuối, nhãn y gồm các từ theo sau chúng. pad_sequence đệm vào cuối
# các bài ngắn: LSTM đọc từ trái sang phải nên phần đệm không làm
# đổi trạng thái của các từ thật. Nhãn được đệm bằng -100, giá trị
# mà F.cross_entropy bỏ qua nên phần đệm không tính vào hàm mất mát.
from torch.nn.utils.rnn import pad_sequence

def make_batch(sequences):
    x = pad_sequence([torch.tensor(s[:-1]) for s in sequences],
                     batch_first=True)
    y = pad_sequence([torch.tensor(s[1:]) for s in sequences],
                     batch_first=True, padding_value=-100)
    return x.to(device), y.to(device)


# (3) Độ hỗn loạn trên danh sách các bài đánh giá, mỗi lần 50 bài
import math

def perplexity(model, sequences):
    total_loss, count = 0, 0
    with torch.no_grad():
        for start in range(0, len(sequences), 50):
            x, y = make_batch(sequences[start:start + 50])
            scores, _ = model(x)
            total_loss += F.cross_entropy(scores.reshape(-1, V + 1),
                                          y.reshape(-1),
                                          reduction="sum").item()
            count += (y != -100).sum().item()
    return math.exp(total_loss / count)


# (4) Huấn luyện một epoch trên các bài đánh giá không nhãn theo lô
# 64 bài, với Adam và cắt ngưỡng đạo hàm như ở bài 7.3
optimizer = torch.optim.Adam(language_model.parameters(), lr=2e-3)
order = torch.randperm(len(unlabeled_sequences)).tolist()
for start in range(0, len(order), 64):
    batch = [unlabeled_sequences[i] for i in order[start:start + 64]]
    x, y = make_batch(batch)
    scores, _ = language_model(x)
    loss = F.cross_entropy(scores.reshape(-1, V + 1), y.reshape(-1))
    optimizer.zero_grad()
    loss.backward()
    nn.utils.clip_grad_norm_(language_model.parameters(), 1.0)
    optimizer.step()

val_perplexity = perplexity(language_model, val_sequences)
print(f"validation perplexity: {val_perplexity:.1f}")


# (5) Sinh phần tiếp theo cho bài đánh giá bắt đầu bằng "this movie",
# từng từ một như ở bài 7.3
vocabulary = list(vectorizer.get_feature_names_out()) + ["<unk>"]
first_words = ["this", "movie"]
length = 40
torch.manual_seed(0)
sample_words = list(first_words)
x = torch.tensor([[word_index[w] for w in first_words]]).to(device)
state = None
with torch.no_grad():
    for _ in range(length):
        scores, state = language_model(x, state)
        probabilities = torch.softmax(scores[0, -1], dim=0)
        next_index = torch.multinomial(probabilities, 1).item()
        sample_words.append(vocabulary[next_index])
        x = torch.tensor([[next_index]]).to(device)
print(f"\n{' '.join(sample_words)}")
validation perplexity: 212.1

this movie isn t believable i m leaving the apocalypse wretched gore moments this is while i have to add here sci construction and allows married and make a happy riding you say i heard of sort of sci fi story it
# (1) Mô hình ngôn ngữ biết gì về sắc thái cảm xúc? Đóng băng nó và
# huấn luyện hồi quy logistic như ở bài 3.2 trên trạng thái sau từ
# cuối cùng của mỗi bài đánh giá. Làm tương tự với chính mạng đó
# trước khi huấn luyện để so sánh.
from sklearn.linear_model import LogisticRegression

def last_states(model, sequences):
    # Trạng thái sau từ cuối cùng của mỗi bài đánh giá, 500 bài/lần
    states = []
    with torch.no_grad():
        for start in range(0, len(sequences), 500):
            batch = sequences[start:start + 500]
            lengths = torch.tensor([len(s) for s in batch])
            padded = pad_sequence([torch.tensor(s) for s in batch],
                                  batch_first=True)
            e = model.embedding(padded.to(device))
            h, _ = model.lstm(e)   # (batch, L, H): sau mỗi từ
            last = h[torch.arange(len(batch)), lengths - 1]
            states.append(last.cpu())
    return torch.cat(states)

torch.manual_seed(0)
untrained_model = LSTMLanguageModel(V, D=100, H=128).to(device)
nn.init.normal_(untrained_model.embedding.weight, std=0.1)

for name, lm in [("before training", untrained_model),
                 ("after training", language_model)]:
    probe = LogisticRegression(max_iter=1000)
    probe.fit(last_states(lm, train_sequences), train_labels)
    probe_accuracy = probe.score(last_states(lm, test_sequences),
                                 test_labels)
    print(f"LSTM {name}: test accuracy {probe_accuracy:.3f}")


# (2) Tinh chỉnh bộ phân loại của bài 7.2b trên 1.000 bài đánh giá
# có nhãn với ba cách khởi tạo: ngẫu nhiên (từ đầu), lấy tầng nhúng
# của mô hình ngôn ngữ, hoặc lấy cả tầng nhúng lẫn mạng LSTM của nó.
# Đầu phân loại đều tạo mới trong cả ba cách. Như ở bài 5.5b, lấy
# ngẫu nhiên các lô từ tập có nhãn, đo độ chính xác trên 1.000 bài
# xác thực sau mỗi 50 lô và giữ lại mô hình tốt nhất.
import copy
import random

def predict(model, sequences):
    # p(positive) cho mỗi chuỗi, mỗi lần 500 chuỗi
    probabilities = []
    with torch.no_grad():
        for start in range(0, len(sequences), 500):
            scores = model(sequences[start:start + 500])
            probabilities.append(torch.sigmoid(scores).cpu())
    return torch.cat(probabilities)

def accuracy(model, sequences, labels):
    right = (predict(model, sequences) > 0.5) == torch.tensor(labels)
    return right.float().mean().item()

def fine_tune(start, chosen, n_batches=400):
    torch.manual_seed(0)
    model = LSTMClassifier(V, D=100, H=128).to(device)
    lm = language_model
    if start != "from scratch":
        model.embedding.load_state_dict(lm.embedding.state_dict())
    if start == "embeddings and LSTM":
        model.lstm.load_state_dict(lm.lstm.state_dict())
    y = torch.tensor(train_labels, dtype=torch.float32)
    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
    loss_function = nn.BCEWithLogitsLoss()
    random.seed(0)   # dùng cùng các lô cho cả ba cách khởi tạo
    best_accuracy = 0
    for step in range(1, n_batches + 1):
        batch = random.choices(chosen, k=32)
        scores = model([train_sequences[i] for i in batch])
        loss = loss_function(scores, y[batch].to(device))
        optimizer.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        if step % 50 == 0:
            val_accuracy = accuracy(model, val_sequences[:1000],
                                    val_labels[:1000])
            if val_accuracy > best_accuracy:
                best_accuracy = val_accuracy
                best_model = copy.deepcopy(model)
    return best_model


# (3) Tinh chỉnh mỗi cách khởi tạo trên 3 tập ngẫu nhiên gồm 1.000
# bài đánh giá có nhãn và lấy trung bình độ chính xác kiểm tra
starts = ["from scratch", "embeddings", "embeddings and LSTM"]
results = {start: [] for start in starts}
for seed in range(3):
    random.seed(seed)
    chosen = random.sample(range(len(train_labels)), 1000)
    for start in starts:
        model = fine_tune(start, chosen)
        results[start].append(accuracy(model, test_sequences,
                                       test_labels))

print("\nfine-tuned on 1,000 labeled reviews:")
for start in starts:
    mean_accuracy = sum(results[start]) / len(results[start])
    print(f"  {start:20} test accuracy {mean_accuracy:.3f}")
LSTM before training: test accuracy 0.548
LSTM after training: test accuracy 0.577

fine-tuned on 1,000 labeled reviews:
  from scratch         test accuracy 0.653
  embeddings           test accuracy 0.702
  embeddings and LSTM  test accuracy 0.682
Mô hình ngôn ngữ rõ ràng đã học được điều gì đó về các bài đánh giá phim: đoạn văn bản mẫu nó sinh ra chứa đúng các từ vựng đặc trưng của điện ảnh, và độ hỗn loạn trên các bài đánh giá xác thực giảm xuống còn 212 (so với mức 10,001 nếu chọn ngẫu nhiên đều trong từ vựng). Thế nhưng, hãy nhìn vào những gì trạng thái ẩn của nó thực sự biết về sắc thái cảm xúc. Bộ hồi quy logistic trên trạng thái cuối cùng chỉ đoán đúng 57.7% bài đánh giá kiểm tra: vỏn vẹn cao hơn 3 điểm phần trăm so với một mạng LSTM khởi tạo ngẫu nhiên chưa học gì, và thấp hơn tới 30 điểm phần trăm so với mô hình túi từ ở mục 3! Lý do là trạng thái ẩn chỉ lưu giữ những gì mà mục tiêu huấn luyện yêu cầu — tức những thông tin cần thiết để dự đoán từ tiếp theo — mà đối với mục tiêu đó thì một vài từ ngay sát trước đó mới là quan trọng nhất. Như Dai và Le đã nhận định: “mô hình hóa ngôn ngữ là một mục tiêu ngắn hạn, do đó trạng thái ẩn chỉ nắm bắt khả năng dự đoán một vài từ kế tiếp” (Dai & Le, 2015). Kết quả tinh chỉnh cũng kể lại đúng câu chuyện đó. Khi chỉ có 1,000 bài đánh giá có nhãn, việc chép các vector nhúng từ mô hình ngôn ngữ giúp tăng thêm 5 điểm phần trăm so với huấn luyện từ đầu. Thế nhưng nếu chép thêm cả mạng LSTM của mô hình ngôn ngữ thì lại làm mất đi 2 điểm trong số đó: đối với bộ phân loại, mạng LSTM lấy từ mô hình ngôn ngữ này thậm chí còn là một điểm xuất phát tệ hơn cả một mạng LSTM ngẫu nhiên! Ngoài ra, hãy để ý xem cả ba phiên bản LSTM ở đây đều còn cách xa mức 82.5% của mạng lấy trung bình sâu ở bài tập 5.5b (cũng huấn luyện trên đúng 1,000 nhãn): một mạng LSTM cần nhiều dữ liệu có nhãn hơn thế rất nhiều để học được cách đọc câu. Một mô hình ngôn ngữ nhỏ chỉ chuyển giao hiệu quả tầng vector nhúng của nó, chứ chưa chuyển giao được phần mạng LSTM.
Vậy phải chăng việc tiền huấn luyện toàn bộ bộ mã hóa là vô ích? Không hề, vấn đề nằm ở chỗ mô hình ngôn ngữ trong bài tập vừa rồi của chúng ta quá nhỏ bé. Dai và Le đã huấn luyện một mạng LSTM gồm 1,024 đơn vị ẩn trong “khoảng 500,000 bước với kích thước lô 128”, trong khi mạng của chúng ta chỉ có 128 đơn vị và mới chỉ đi qua 782 lô gồm 64 bài đánh giá. Năm 2017, Alec Radford, Rafal Jozefowicz và Ilya Sutskever tại OpenAI đã cho thế giới thấy điều kỳ diệu gì sẽ xảy ra khi đẩy quy mô lên lớn hơn gấp bội (Radford et al., 2017). Họ huấn luyện một mạng LSTM gồm 4,096 đơn vị để dự đoán ký tự tiếp theo trên 82 triệu bài đánh giá sản phẩm của Amazon, sau đó huấn luyện một bộ hồi quy logistic đặt trên trạng thái ẩn cuối cùng của nó — giống hệt như cách chúng ta vừa làm ở bài tập 8.1. Trên tập dữ liệu IMDB, mô hình này đạt độ chính xác lên tới 92.9%. Khi kiểm tra trọng số của bộ hồi quy logistic, họ phát hiện ra một sự thật kinh ngạc: phần lớn công việc phân loại được thực hiện bởi một đơn vị (nơ-ron) duy nhất trong vector trạng thái; chỉ riêng một đơn vị này cùng với một ngưỡng cắt đơn giản đã mang lại độ chính xác 92.3%. Chẳng có ai dạy cho mạng biết “cảm xúc” (sentiment) là gì. Mạng đã tự mình học cách theo dõi sắc thái cảm xúc qua từng ký tự một, có lẽ bởi việc biết một bài đánh giá đang khen hay chê giúp ích rất nhiều cho việc dự đoán các ký tự xuất hiện tiếp theo. Như các tác giả giải thích: “Rất có thể sắc thái cảm xúc, trong vai trò một đặc trưng điều kiện (conditioning feature), mang lại năng lực dự đoán mạnh mẽ cho bài toán mô hình hóa ngôn ngữ. Điều này hoàn toàn hợp lý bởi cảm xúc là một thành phần cốt lõi của một bài đánh giá.”
Năm 2018, Jeremy Howard và Sebastian Ruder đã biến ý tưởng này thành một quy trình chuẩn mực có thể áp dụng hiệu quả cho bất kỳ tác vụ phân loại văn bản nào, mang tên ULMFiT (viết tắt của universal language model fine-tuning – Tinh chỉnh mô hình ngôn ngữ vạn năng) (Howard & Ruder, 2018). Họ xuất phát từ mô hình ngôn ngữ LSTM mạnh nhất thời bấy giờ là AWD-LSTM của Merity và cộng sự (Merity et al., 2018): một mạng gồm ba tầng, mỗi tầng 1,150 đơn vị ẩn, được điều chuẩn bằng nhiều kỹ thuật dropout kết hợp, bao gồm cả việc áp dụng dropout trực tiếp lên các ma trận trọng số kết nối từ trạng thái này sang trạng thái kế tiếp. AWD-LSTM đạt mức perplexity trên tập kiểm tra của WikiText-2 là 65.8 (so với mức 155.8 của mạng LSTM nhỏ trong bài tập 7.3 của chúng ta). Quy trình ULMFiT gồm ba giai đoạn rõ rệt:
- Giai đoạn 1: Tiền huấn luyện mô hình ngôn ngữ trên một kho văn bản tổng quát quy mô lớn: 103 triệu từ của Wikipedia (tập dữ liệu WikiText-103, người anh khổng lồ của WikiText-2);
- Giai đoạn 2: Tinh chỉnh tiếp mô hình đó (vẫn dưới dạng mô hình ngôn ngữ dự đoán từ tiếp theo) trên chính kho văn bản của bài toán đích — ở đây là các bài đánh giá của IMDB — để mô hình thích nghi với từ vựng và văn phong đặc thù của đánh giá phim;
- Giai đoạn 3: Gắn thêm một đầu dự đoán (head), và tinh chỉnh toàn bộ bộ phân loại trên các bài đánh giá có nhãn.
Giai đoạn thứ ba đòi hỏi sự khéo léo đặc biệt. Nếu ta tinh chỉnh một mô hình ngôn ngữ đã tiền huấn luyện một cách quá mạnh tay cùng với một đầu dự đoán mới tinh vừa gắn vào, những bước cập nhật lớn ban đầu có thể xóa sạch những tri thức quý giá mà mạng đã tích lũy được trong quá trình tiền huấn luyện — hiện tượng này được gọi là quên lãng thảm khốc (catastrophic forgetting). Để ngăn chặn điều đó, hai tác giả rã đông dần dần (gradual unfreezing) mạng nơ-ron từ tầng trên cùng xuống dưới: ban đầu chỉ mở khóa huấn luyện riêng đầu dự đoán, sau đó mở khóa thêm tầng cuối cùng của LSTM, rồi cứ thế mở dần xuống tận tầng vector nhúng ở đáy. Đồng thời, mỗi tầng cũng được gán một tốc độ học (learning rate) riêng, giảm dần đối với các tầng nằm ở phía dưới. Khi kết hợp hai bộ phân loại — một đọc bài đánh giá từ trái sang phải và một đọc từ phải sang trái — ULMFiT đạt độ chính xác lên tới 95.4% trên IMDB (và đạt 94.7% nếu chỉ dùng một chiều).
Chỉ trong vòng ba năm, từ công trình của Dai & Le cho đến ULMFiT, phương pháp tiền huấn luyện bộ mã hóa dưới dạng mô hình ngôn ngữ đã đưa độ chính xác trên tập IMDB từ 92.4% lên 95.4%. Trước khi bước vào mục này, kết quả cao nhất mà chúng ta từng biết tới chỉ là 91.2% của mô hình NBSVM sử dụng các cặp từ (mục 6).
8.2 Vector nhúng theo ngữ cảnh (Contextual embeddings)
Vẫn còn một cách khác để khai thác một mô hình ngôn ngữ đã qua tiền huấn luyện. Hãy nhìn lại chuỗi trạng thái ẩn trong mạng LSTM của nó. Sau mỗi từ, trạng thái là một vector có kích thước cố định phụ thuộc vào cả từ hiện tại lẫn toàn bộ các từ đứng trước nó. Vì vậy, ta hoàn toàn có thể coi như một vector biểu diễn dành cho từ — giống như một vector nhúng từ (word embedding), nhưng là một vector linh hoạt có khả năng tự thay đổi tùy theo câu văn chứa từ đó. Những vector như vậy được gọi là vector nhúng theo ngữ cảnh (contextual embeddings).
Chúng giải quyết trọn vẹn hạn chế cuối cùng mà chúng ta đã nêu ra ở mục 6. Trong một bộ nhúng tĩnh (static embedding) như GloVe, từ “bank” chỉ có duy nhất một vector cố định bất kể nó nằm trong câu nào, và vector này bị chi phối bởi nghĩa phổ biến nhất trong kho dữ liệu là “ngân hàng giữ tiền” (bài tập 6). Ngược lại, với vector nhúng theo ngữ cảnh, mỗi lần từ “bank” xuất hiện trong một câu cụ thể, nó lại nhận được một vector mới được tính toán trực tiếp từ các từ xung quanh nó.
Bộ vector nhúng theo ngữ cảnh nổi tiếng nhất trong giai đoạn này là ELMo (viết tắt của embeddings from language models – Vector nhúng từ các mô hình ngôn ngữ), do Matthew Peters cùng các đồng nghiệp tại Viện Trí tuệ Nhân tạo Allen (AI2) và Đại học Washington giới thiệu (Peters et al., 2018). ELMo bao gồm một cặp mô hình ngôn ngữ LSTM được huấn luyện trên khoảng 800 triệu từ thuộc kho dữ liệu tin tức. Một mạng đọc câu từ trái sang phải để dự đoán từ tiếp theo, mạng kia đọc từ phải sang trái để dự đoán từ đứng trước, nhờ đó vector biểu diễn của mỗi từ phụ thuộc vào toàn bộ ngữ cảnh hai phía của cả câu. Mỗi mạng có hai tầng gồm 4,096 đơn vị ẩn, và đầu vào của chúng đọc trực tiếp từ các ký tự của từ (character-level convolution) nên không bao giờ gặp phải từ lạ ngoài từ vựng. Vector ELMo cuối cùng của một từ là tổng có trọng số của các trạng thái tại vị trí từ đó qua tất cả các tầng, trong đó các hệ số trọng số được học riêng cho từng bài toán đích. Bản thân hai mô hình ngôn ngữ được giữ đóng băng (frozen) hoàn toàn: tại đầu vào của mô hình giải quyết từng bài toán cụ thể, người ta chỉ việc ghép nối (concatenate) vector ELMo của mỗi từ vào cạnh vector nhúng tĩnh thông thường của từ đó. Chỉ bằng cách bổ sung thêm vector ELMo như vậy vào các kiến trúc mạnh sẵn có trên sáu bài toán NLP khác nhau — từ hỏi đáp tự động (question answering) cho đến phân tích cảm xúc câu — ELMo đã thiết lập kỷ lục mới (state of the art) trên cả sáu bài toán.
ELMo không phải là công trình đầu tiên thực hiện ý tưởng này. Chỉ vài tháng trước đó, chính nhóm của Peters đã thử đưa các trạng thái cuối của hai mô hình ngôn ngữ tiền huấn luyện (hai chiều xuôi ngược) vào một bộ gán nhãn chuỗi (Peters et al., 2017), và nhóm của McCann đã trích xuất các trạng thái từ bộ mã hóa của một mô hình dịch máy để tạo ra bộ vector mang tên CoVe (McCann et al., 2017). Điểm đột phá của ELMo là kết hợp tất cả các tầng của mô hình ngôn ngữ thay vì chỉ lấy tầng trên cùng, đồng thời chứng minh tính hiệu quả rộng khắp của các vector này trên hàng loạt tác vụ đa dạng. Như các tác giả nhấn mạnh: “mỗi token được gán một biểu diễn là một hàm số phụ thuộc vào toàn bộ câu đầu vào.”
ELMo và ULMFiT đại diện cho hai trường phái khai thác mô hình ngôn ngữ tiền huấn luyện mà kỷ nguyên Transformer sau này kế thừa trọn vẹn. ELMo đóng băng mô hình ngôn ngữ và trích xuất các trạng thái của nó làm đặc trưng đầu vào cho một mạng nơ-ron khác được huấn luyện riêng cho bài toán đích. Ngược lại, ULMFiT tinh chỉnh trực tiếp chính mô hình ngôn ngữ đó và chỉ gắn thêm một đầu dự đoán mỏng ở trên cùng. Mô hình BERT mà chúng ta sẽ gặp ở mục 10.2 có thể được sử dụng theo cả hai cách, và tại đó chúng ta sẽ trực tiếp so sánh các vector mà BERT tạo ra cho từ “bank” trong những câu viết về dòng sông và những câu viết về tiền bạc.
Nếu muốn đào sâu hơn, bạn có thể thử sức với một số bài tập mở rộng dưới đây.
Đi tìm nơ-ron cảm xúc? Trong mô hình ngôn ngữ nhỏ đã huấn luyện ở bài tập 8.1, hãy tìm kiếm xem đơn vị (unit) đơn lẻ nào trong vector trạng thái cuối cùng có khả năng tự mình phân tách tốt nhất các bài đánh giá tích cực khỏi tiêu cực (sử dụng ngưỡng cắt tại giá trị trung vị – median). Độ chính xác của đơn vị tốt nhất đó cách mức 92.3% của “nơ-ron cảm xúc” trong công trình của Radford và cộng sự (Radford et al., 2017) bao xa?
Mô hình ngôn ngữ lớn hơn. Hãy tiền huấn luyện các mô hình ngôn ngữ lớn hơn với và , hoặc huấn luyện trong nhiều kỷ nguyên hơn, rồi chạy lại bộ hồi quy logistic của bài tập 8.1 trên trạng thái ẩn cuối cùng của chúng. Liệu trạng thái ẩn có học được nhiều thông tin về cảm xúc hơn khi độ hỗn loạn (perplexity) giảm xuống không?
Sử dụng toàn bộ chuỗi trạng thái. Đầu dự đoán của ULMFiT không chỉ đọc trạng thái cuối cùng, mà đọc ghép nối cả trạng thái cuối cùng, trung bình cộng (average pooling) và cực đại (max pooling) của toàn bộ các trạng thái dọc theo bài đánh giá (Howard & Ruder, 2018). Hãy chạy bộ hồi quy logistic ở bài tập 8.1 trên vector trung bình cộng của tất cả các trạng thái thay vì chỉ lấy trạng thái cuối cùng (cho cả mô hình ngôn ngữ đã huấn luyện lẫn mạng LSTM chưa huấn luyện). Kết quả thay đổi như thế nào?
Rã đông dần dần (Gradual unfreezing). Hãy tinh chỉnh bộ mã hóa đã tiền huấn luyện ở bài tập 8.1 theo đúng chiến lược của ULMFiT: ban đầu chỉ huấn luyện riêng đầu dự đoán (giữ đóng băng bộ mã hóa), sau đó mở khóa mạng LSTM, rồi cuối cùng mới mở khóa tầng nhúng, đồng thời áp dụng tốc độ học nhỏ hơn cho các tầng bên dưới. Khi làm vậy, phần mạng LSTM được chuyển giao từ mô hình ngôn ngữ có phát huy tác dụng tốt hơn không?
Khi có đầy đủ nhãn dữ liệu. Hãy tinh chỉnh cả ba phương án khởi tạo ở bài tập 8.1 trên toàn bộ 20,000 bài đánh giá có nhãn trong 6 kỷ nguyên giống như bài tập 7.2b. Khi có nhiều dữ liệu có nhãn như vậy, việc tiền huấn luyện có còn tạo ra khác biệt đáng kể không?
Kiểm tra các vector theo ngữ cảnh. Sử dụng mô hình ngôn ngữ của bài tập 8.1, hãy tính vector trạng thái ẩn ngay sau từ "score" trong mười câu văn: năm câu nói về nhạc phim và năm câu nói về tỷ số trận đấu, sau đó tính ma trận độ tương đồng cosine giữa chúng. Hai nét nghĩa này có tách biệt nhau ra không? Hãy nhớ rằng mô hình ngôn ngữ một chiều này mới chỉ đọc các từ đứng trước từ "score".
9. Từ chuỗi sang chuỗi (Sequence-to-Sequence): Dịch máy và sự ra đời của cơ chế chú ý (Attention)
Hãy quay trở lại với bài toán thứ ba đã giới thiệu ở mục 1: dịch máy (machine translation). Tất cả các mô hình mà chúng ta xây dựng từ đầu chương đến giờ đều chỉ xuất ra một phân phối xác suất duy nhất cho mỗi văn bản đầu vào: hoặc là phân phối trên các nhãn lớp của một bài đánh giá, hoặc là phân phối trên từ tiếp theo. Trong khi đó, một bản dịch lại là cả một câu hoàn chỉnh — thường có độ dài khác với câu nguồn và các từ có thể sắp xếp theo một trật tự hoàn toàn khác, như hình minh họa ở mục 1.3 đã chỉ ra. Cho đến năm 2014, những hệ thống dịch máy tốt nhất đều là các hệ thống dịch máy thống kê (statistical machine translation – SMT) được lắp ghép từ rất nhiều bộ phận: các bảng dịch những cụm từ ngắn được học từ hàng triệu cặp câu song ngữ, kết hợp với một mô hình ngôn ngữ n-gram làm nhiệm vụ kiểm tra xem câu đầu ra có trôi chảy giống tiếng Pháp hay tiếng Anh tự nhiên hay không (chúng ta sẽ quay lại các hệ thống này ở mục 9.3). Thế rồi, chỉ trong vòng vài tháng của năm 2014, một vài bài báo khoa học đã chứng minh rằng chỉ cần hai mạng nơ-ron truy hồi (RNN) là có thể đảm đương toàn bộ quy trình đó, và một trong số các công trình ấy đã giới thiệu cơ chế chú ý (attention) — trái tim của kiến trúc Transformer ngày nay.
9.1 Kiến trúc Mã hóa – Giải mã (Encoder–decoder / seq2seq)
Ý tưởng cốt lõi là kết hợp hai mạng RNN với nhau. Mạng thứ nhất, gọi là bộ mã hóa (encoder), đọc câu nguồn từng từ một, giống hệt như cách bộ phân loại ở mục 7.2 đọc một bài đánh giá phim. Trạng thái ẩn cuối cùng của nó, , chính là vector biểu diễn có kích thước cố định của toàn bộ câu nguồn. Mạng thứ hai, gọi là bộ giải mã (decoder), bản chất là một mô hình ngôn ngữ giống như ở mục 7.3, làm nhiệm vụ viết ra câu dịch từng từ một; điểm khác biệt duy nhất là trạng thái ẩn ban đầu của nó được khởi tạo bằng chính thay vì vector không (). Nhờ vậy, mỗi từ mà bộ giải mã dự đoán vừa phụ thuộc vào những từ nó đã viết ra trước đó, vừa phụ thuộc vào câu nguồn thông qua vector . Bộ giải mã học phân phối xác suất có điều kiện ở mục 1.3, trong đó câu nguồn được thay thế bằng vector biểu diễn của nó:
Để bắt đầu quá trình dịch, bộ giải mã đọc một ký hiệu bắt đầu đặc biệt (start token), rồi lần lượt viết ra từng từ cho đến khi nó sinh ra ký hiệu kết thúc đặc biệt (end token). Trong quá trình huấn luyện, bộ giải mã được đọc các từ đúng thực tế phía trước của câu dịch chuẩn (ground-truth translation) — giống như cách một mô hình ngôn ngữ đọc văn bản huấn luyện — và hàm mất mát chính là entropy chéo (cross-entropy) trên từ đúng tiếp theo. Kỹ thuật này được gọi là cưỡng bức giáo viên (teacher forcing). Tuy nhiên, ở giai đoạn kiểm tra (test time), làm gì có bản dịch chuẩn nào có sẵn để đọc: bộ giải mã buộc phải tự đọc lại chính những từ mà nó vừa viết ra ở các bước trước. Cách đơn giản nhất để chọn từ ở mỗi bước là lấy ngay từ có xác suất dự đoán cao nhất — phương pháp này được gọi là giải mã tham lam (greedy decoding).
Đọc thêm Tìm kiếm chùm (Beam search): lựa chọn toàn bộ câu dịch tối ưu thay vì chọn tham lam từng từ một
Giải mã tham lam (greedy decoding) chọn từng từ một mà không hề nhìn xa hơn về phía trước. Thế nhưng, câu dịch có tổng xác suất cao nhất xét trên toàn câu đôi khi lại bắt đầu bằng một từ không phải là từ có xác suất cao nhất ở vị trí đầu tiên: việc chấp nhận một từ có xác suất thấp hơn một chút ở hiện tại có thể mở đường cho những từ có xác suất cao vượt trội ở các bước sau. Việc tìm kiếm chính xác câu dịch có xác suất cao nhất là bất khả thi về mặt tính toán, bởi số lượng câu khả dĩ tăng lên theo hàm mũ theo độ dài câu. Tìm kiếm chùm (beam search) là một giải pháp dung hòa hiệu quả: thuật toán luôn duy trì phần mở đầu câu dịch có xác suất cao nhất tại mỗi thời điểm. Ở mỗi bước tiếp theo, nó mở rộng từng câu trong số câu đang giữ bằng tất cả các từ có trong từ vựng, rồi chỉ lọc giữ lại phương án mở rộng có xác suất tích lũy cao nhất, cứ thế lặp lại cho đến khi các câu gặp thẻ kết thúc (end token). Khi đặt , thuật toán suy biến về đúng giải mã tham lam. Sutskever và cộng sự đã sử dụng (Sutskever et al., 2014): với tổ hợp (ensemble) gồm 5 mô hình của họ, điểm số dịch thuật BLEU (sẽ giải thích ở mục 9.3) tăng từ 33.0 (khi giải mã tham lam) lên 34.5 chỉ với , và đạt 34.8 với .
Kyunghyun Cho cùng các đồng nghiệp tại Montreal đã giới thiệu kiến trúc mã hóa – giải mã (encoder–decoder) này vào tháng 6 năm 2014, ngay trong chính bài báo đề xuất kiến trúc GRU mà chúng ta đã gặp ở mục 7.2 (Cho et al., 2014). Tuy nhiên, ở thời điểm đó họ mới chỉ dùng mạng này để chấm điểm các cặp cụm từ ngắn bên trong một hệ thống dịch máy thống kê truyền thống. Đến tháng 9 cùng năm, Ilya Sutskever, Oriol Vinyals và Quoc Le (Lê Viết Quốc) tại Google đã dịch trọn vẹn cả câu từ tiếng Anh sang tiếng Pháp bằng một mô hình rất tương đồng được phát triển song song. Bộ mã hóa và bộ giải mã của họ là các mạng LSTM sâu 4 tầng, mỗi tầng 1,000 đơn vị ẩn, được huấn luyện trong khoảng mười ngày trên 12 triệu cặp câu song ngữ. Một tổ hợp (ensemble) gồm năm mô hình như vậy đã chính thức đánh bại hệ thống dịch máy thống kê chuẩn thời bấy giờ với điểm BLEU đạt 34.8 so với 33.3 (BLEU là thang đo chất lượng dịch thuật từ 0 đến 100, sẽ được giải thích ở mục 9.3). Như các tác giả tự hào viết: “đây là lần đầu tiên một hệ thống dịch thuật thuần mạng nơ-ron vượt qua một hệ thống dịch máy thống kê dựa trên cụm từ (phrase-based SMT) trên một tác vụ dịch máy quy mô lớn với cách biệt đáng kể”. Chính tiêu đề bài báo của họ đã đặt cái tên quen thuộc cho kiến trúc này: sequence to sequence (từ chuỗi sang chuỗi), hay viết tắt là seq2seq.
Hãy nhìn lại sơ đồ kiến trúc một lần nữa: toàn bộ thông tin của câu nguồn bắt buộc phải chui qua — một vector có kích thước cố định — bất kể câu đó chỉ có 5 từ hay dài tới 50 từ. Cho và cộng sự đã đo lường hệ quả trực tiếp của thiết kế này trong một bài báo tiếp theo: chất lượng bản dịch của mô hình mã hóa – giải mã rất tốt đối với những câu ngắn, nhưng “suy giảm nhanh chóng khi độ dài câu và số lượng từ lạ tăng lên”. Giả thuyết của họ rất rõ ràng: “biểu diễn vector có độ dài cố định không đủ dung lượng để mã hóa một câu dài với cấu trúc và ngữ nghĩa phức tạp”. Trạng thái cuối cùng của bộ mã hóa chính là một nút thắt cổ chai (bottleneck): mọi thứ mà bộ giải mã biết được về câu nguồn đều phải nhồi nhét vừa vào vector duy nhất đó.
Đọc thêm Một mẹo kỳ lạ: đảo ngược thứ tự câu nguồn giúp cải thiện đáng kể chất lượng dịch
Sutskever và cộng sự còn phát hiện ra một mẹo vô cùng kỳ lạ: đảo ngược thứ tự các từ trong câu nguồn trước khi đưa vào bộ mã hóa. Chẳng hạn, để dịch câu "I loved this great movie", bộ mã hóa sẽ đọc chuỗi đảo ngược "movie great this loved I". Chỉ với mẹo đơn giản này, độ hỗn loạn (perplexity) trên tập kiểm tra của mô hình đã giảm từ 5.8 xuống 4.7, và điểm BLEU tăng vọt từ 25.9 lên 30.6! Lời giải thích của nhóm tác giả như sau: nếu giữ nguyên thứ tự bình thường, mỗi từ ở câu nguồn sẽ cách bản dịch tương ứng của nó một khoảng bước thời gian xấp xỉ bằng độ dài của cả câu. Việc đảo ngược câu nguồn không làm thay đổi khoảng cách trung bình giữa các từ gốc và từ dịch, nhưng “vài từ đầu tiên trong ngôn ngữ nguồn giờ đây nằm ngay sát vài từ đầu tiên trong ngôn ngữ đích, nhờ đó độ trễ thời gian tối thiểu (minimal time lag) của bài toán được rút ngắn đáng kể”. Mạng nơ-ron có thể khởi đầu thuận lợi bằng cách học những mối phụ thuộc tầm ngắn này thông qua tín hiệu gradient chỉ cần truyền ngược vài bước — một việc rất dễ dàng như mục 7.2 đã chỉ ra. Mẹo đảo câu thực chất chính là một triệu chứng phơi bày nút thắt cổ chai: mức độ một mảnh thông tin ở câu nguồn truyền tới được bộ giải mã phụ thuộc nặng nề vào số bước thời gian ngăn cách nó với vị trí từ đích đang cần nó. Nhờ mẹo đảo ngược này cộng với kích thước mạng khổng lồ (8,000 biến trạng thái), Sutskever và cộng sự hầu như không thấy sự sụt giảm chất lượng trên các câu dài như nhóm của Cho. Một vector lớn hơn tất nhiên chứa được nhiều thông tin hơn, nhưng kích thước của nó suy cho cùng vẫn là cố định.
Để tận mắt chứng kiến nút thắt cổ chai này hoạt động ra sao mà không cần tải một bộ dữ liệu dịch thuật lớn, chúng ta hãy dùng một bài toán mô phỏng gọn nhẹ: đảo ngược các chuỗi chữ số. “Bản dịch” của chuỗi 3 9 1 4 sẽ là 4 1 9 3. Với bài toán này, ta có thể tự sinh ra bao nhiêu cặp chuỗi tùy thích ở bất kỳ độ dài nào, và vì biết trước đáp án tuyệt đối chính xác nên ta có thể đo đạc chuẩn xác độ chính xác biến thiên theo độ dài chuỗi ra sao. Thứ tự đầu ra bị đảo ngược hoàn toàn — giống như cách tiếng Thổ Nhĩ Kỳ đảo ngược trật tự từ của tiếng Anh trong hình ở mục 1.3. Hơn nữa, bài toán đảo chuỗi này đã sẵn ở chiều thuận lợi theo mẹo của Sutskever và cộng sự: chữ số đầu tiên cần viết ra chính là chữ số cuối cùng vừa được đọc vào!
Bài tập 9.1★ Đảo ngược chuỗi chữ số bằng mô hình mã hóa – giải mã
Hãy huấn luyện một mô hình mã hóa – giải mã sử dụng mạng GRU để đảo ngược các chuỗi chữ số. Bộ mã hóa đọc lần lượt các chữ số, trạng thái cuối cùng của nó được truyền làm trạng thái đầu tiên của bộ giải mã, và bộ giải mã viết ra các chữ số theo thứ tự ngược lại, từng chữ số một (, ). Hãy huấn luyện mô hình trên các chuỗi có độ dài từ 5 đến 30 chữ số. Sau đó, ứng với từng độ dài, hãy đo tỷ lệ chuỗi mà mô hình đảo ngược hoàn hảo không sai một chữ số nào, cùng tỷ lệ chữ số riêng lẻ được dự đoán đúng, rồi vẽ đồ thị cả hai tỷ lệ này theo độ dài chuỗi.
# Các chữ số từ 0 đến 9 là các token của chính chúng. Bộ giải mã
# đọc một token bắt đầu (10) trước khi viết chữ số đầu tiên.
START = 10

# Một lô gồm n chuỗi chữ số ngẫu nhiên có cùng độ dài và các
# "bản dịch" của chúng: chính các chữ số đó theo thứ tự đảo ngược
import torch

def make_batch(n, length):
    sources = torch.randint(0, 10, (n, length))
    targets = sources.flip(1)   # đảo ngược thứ tự các cột
    return sources, targets

torch.manual_seed(0)
sources, targets = make_batch(3, 8)
for source, target in zip(sources.tolist(), targets.tolist()):
    source_text = "".join(str(d) for d in source)
    target_text = "".join(str(d) for d in target)
    print(f"{source_text}  ->  {target_text}")
49303973  ->  37930394
73166986  ->  68966137
68436914  ->  41963486
Hint
Hãy viết mô hình dưới dạng một lớp con của nn.Module gồm hai tầng nhúng: nn.Embedding(10, D) cho chuỗi nguồn và nn.Embedding(11, D) cho bộ giải mã (do bộ giải mã cần đọc thêm cả ký hiệu bắt đầu – start token); hai mạng GRU nn.GRU(D, H, batch_first=True); và một tầng tuyến tính nn.Linear(H, 10) để tính điểm số cho chữ số tiếp theo. Lớp GRU trả về chuỗi trạng thái sau mỗi bước cùng với trạng thái cuối cùng có kích thước (1, batch, H). Hãy truyền trạng thái cuối cùng của bộ mã hóa làm đối số thứ hai khi gọi bộ giải mã để bộ giải mã khởi đầu từ trạng thái đó.
Hint
Với kỹ thuật cưỡng bức giáo viên (teacher forcing), bộ giải mã đọc ký hiệu bắt đầu theo sau bởi các chữ số mục tiêu (trừ chữ số cuối cùng): torch.cat([starts, targets[:, :-1]], dim=1), trong đó starts là một cột gồm toàn ký hiệu bắt đầu. Tại mỗi vị trí, điểm số đầu ra được so sánh với chữ số mục tiêu thông qua hàm mất mát F.cross_entropy tính trên tất cả các vị trí cùng lúc, giống như ở bài tập 7.3. Ở mỗi lô (batch), hãy rút ngẫu nhiên một độ dài mới bằng random.randint(5, 30) để mọi chuỗi trong cùng một lô có độ dài bằng nhau và không cần phải đệm (padding).
Hint
Hãy huấn luyện với bộ tối ưu hóa Adam (tốc độ học 0.001) qua 20,000 lô, mỗi lô gồm 64 chuỗi, và cắt tỉa gradient ở mức 1.0. Quá trình huấn luyện mất khoảng hai phút rưỡi trên CPU laptop.
Hint
Để thực hiện giải mã tham lam (greedy decoding) khi kiểm tra, hãy bắt đầu từ một cột gồm các ký hiệu bắt đầu. Ở mỗi bước, đưa chuỗi nguồn và các chữ số đã viết được tính đến lúc đó vào mô hình, lấy chữ số có điểm số cao nhất tại vị trí cuối cùng (argmax), rồi nối thêm chữ số đó vào chuỗi kết quả. Sau bước, biểu thức correct = outputs == targets tạo ra một ma trận logic (boolean), và correct.all(dim=1) sẽ cho biết những chuỗi nào được đảo ngược đúng hoàn toàn không có lấy một lỗi sai.
Điểm kiểm tra kết quả bạn cần đạt được
Sau 20,000 lô huấn luyện, mô hình đảo ngược hoàn hảo 100% các chuỗi dài 10 chữ số, 91.7% các chuỗi dài 15 chữ số, 51.8% các chuỗi dài 20 chữ số, và 0% (không đúng trọn vẹn một chuỗi nào) đối với các chuỗi dài 30 chữ số. Tỷ lệ chữ số riêng lẻ đoán đúng giảm chậm hơn, từ 100% ở độ dài 10 chữ số xuống còn 53.8% ở độ dài 30 chữ số. Biểu đồ trong notebook thể hiện rõ hai đường cong này. Lời giải chạy mất khoảng ba phút trên CPU laptop; kết quả của bạn có thể xê dịch vài điểm phần trăm.
batches 1 to 5000: loss 0.709
batches 5001 to 10000: loss 0.293
batches 10001 to 15000: loss 0.182
batches 15001 to 20000: loss 0.119

10 digits: 100.0% of the strings, 100.0% of the digits
15 digits: 91.7% of the strings, 98.7% of the digits
20 digits: 51.8% of the strings, 91.3% of the digits
25 digits: 5.6% of the strings, 73.3% of the digits
30 digits: 0.0% of the strings, 53.8% of the digits

target: 6525378564826761271358100
output: ......58........72.......
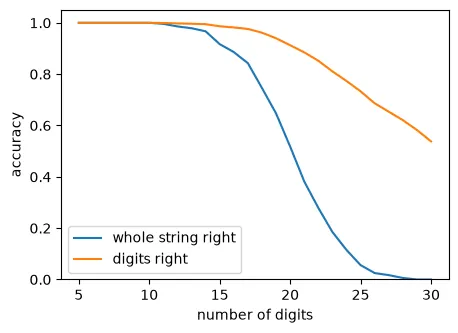
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
# Các chữ số từ 0 đến 9 là các token của chính chúng. Bộ giải mã
# đọc một token bắt đầu (10) trước khi viết chữ số đầu tiên.
START = 10

# Một lô gồm n chuỗi chữ số ngẫu nhiên có cùng độ dài và các
# "bản dịch" của chúng: chính các chữ số đó theo thứ tự đảo ngược
import torch

def make_batch(n, length):
    sources = torch.randint(0, 10, (n, length))
    targets = sources.flip(1)   # đảo ngược thứ tự các cột
    return sources, targets

torch.manual_seed(0)
sources, targets = make_batch(3, 8)
for source, target in zip(sources.tolist(), targets.tolist()):
    source_text = "".join(str(d) for d in source)
    target_text = "".join(str(d) for d in target)
    print(f"{source_text}  ->  {target_text}")
49303973  ->  37930394
73166986  ->  68966137
68436914  ->  41963486
# (1) Mô hình. Một mạng GRU mã hóa đọc các chữ số nguồn, và trạng
# thái cuối cùng của nó làm trạng thái đầu tiên của mạng GRU giải mã.
# Bộ giải mã đọc token bắt đầu cùng các chữ số đã viết cho đến hiện
# tại, rồi đưa ra điểm số cho chữ số tiếp theo ở mỗi vị trí.
from torch import nn
import torch.nn.functional as F

class EncoderDecoder(nn.Module):
    def __init__(self, D, H):
        super().__init__()
        self.source_embedding = nn.Embedding(10, D)
        self.encoder = nn.GRU(D, H, batch_first=True)
        self.target_embedding = nn.Embedding(11, D)  # có thêm START
        self.decoder = nn.GRU(D, H, batch_first=True)
        self.output = nn.Linear(H, 10)

    def forward(self, sources, decoder_inputs):
        e = self.source_embedding(sources)          # (batch, L, D)
        _, h = self.encoder(e)       # trạng thái cuối: (1, batch, H)
        d = self.target_embedding(decoder_inputs)   # (batch, N, D)
        states, _ = self.decoder(d, h)              # (batch, N, H)
        return self.output(states)                  # (batch, N, 10)


# (2) Huấn luyện với cưỡng bức giáo viên (teacher forcing): bộ giải mã
# đọc các chữ số đích thực sự, dịch sang phải một vị trí sau token
# bắt đầu. Mỗi lô có độ dài riêng từ 5 đến 30 nên không cần đệm.
# Viết thành hàm vì bài 9.2 sẽ huấn luyện thêm một mô hình nữa.
import random

def train(model, steps=20_000, batch_size=64):
    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
    total_loss = 0
    for step in range(steps):
        length = random.randint(5, 30)
        sources, targets = make_batch(batch_size, length)
        starts = torch.full((batch_size, 1), START)
        decoder_inputs = torch.cat([starts, targets[:, :-1]], dim=1)
        scores = model(sources, decoder_inputs)
        loss = F.cross_entropy(scores.reshape(-1, 10),
                               targets.reshape(-1))
        optimizer.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        total_loss += loss.item()
        if (step + 1) % 5000 == 0:   # trung bình của 5.000 lô
            print(f"batches {step - 4998} to {step + 1}: "
                  f"loss {total_loss / 5000:.3f}")
            total_loss = 0

torch.manual_seed(0)
random.seed(0)
model = EncoderDecoder(D=32, H=128)
train(model)


# (3) Giải mã tham lam: bắt đầu từ token START và viết ra chữ số có
# điểm số cao nhất, từng chữ số một. Ở mỗi bước, mô hình đọc lại
# toàn bộ các chữ số đã viết: hơi lãng phí nhưng đơn giản và đủ
# nhanh cho 30 chữ số.
def translate(model, sources):
    decoder_inputs = torch.full((len(sources), 1), START)
    with torch.no_grad():
        for _ in range(sources.shape[1]):
            scores = model(sources, decoder_inputs)  # (batch, N, 10)
            next_digits = scores[:, -1].argmax(dim=1)
            decoder_inputs = torch.cat(
                [decoder_inputs, next_digits[:, None]], dim=1)
    return decoder_inputs[:, 1:]   # bỏ token bắt đầu


# (4) Với mỗi độ dài, tính tỷ lệ chuỗi hoàn toàn không sai và tỷ lệ
# chữ số đúng trên 1.000 chuỗi mới
lengths = list(range(5, 31))

def accuracy_by_length(model):
    string_accuracy, digit_accuracy = [], []
    for length in lengths:
        sources, targets = make_batch(1000, length)
        correct = translate(model, sources) == targets  # (1000, L)
        whole = correct.all(dim=1)   # một giá trị cho mỗi chuỗi
        string_accuracy.append(whole.float().mean().item())
        digit_accuracy.append(correct.float().mean().item())
    return string_accuracy, digit_accuracy

torch.manual_seed(1)
string_accuracy, digit_accuracy = accuracy_by_length(model)
print()
for length in [10, 15, 20, 25, 30]:
    i = lengths.index(length)
    print(f"{length} digits: "
          f"{string_accuracy[i]:.1%} of the strings, "
          f"{digit_accuracy[i]:.1%} of the digits")


# (5) Một chuỗi 25 chữ số, chuỗi đảo ngược của nó và kết quả của
# mô hình, với dấu chấm cho mỗi chữ số đúng
sources, targets = make_batch(1, 25)
output = translate(model, sources)
target_text = "".join(str(d) for d in targets[0].tolist())
output_text = "".join(str(o) if o != t else "."
                      for o, t in zip(output[0].tolist(),
                                      targets[0].tolist()))
print(f"\ntarget: {target_text}\noutput: {output_text}")


# (6) Vẽ biểu đồ cả hai độ chính xác theo độ dài chuỗi
import matplotlib.pyplot as plt

plt.figure(figsize=(5, 3.5))
plt.plot(lengths, string_accuracy, label="whole string right")
plt.plot(lengths, digit_accuracy, label="digits right")
plt.ylim(0, 1.05)
plt.xlabel("number of digits")
plt.ylabel("accuracy")
plt.legend()
plt.show()
batches 1 to 5000: loss 0.709
batches 5001 to 10000: loss 0.293
batches 10001 to 15000: loss 0.182
batches 15001 to 20000: loss 0.119

10 digits: 100.0% of the strings, 100.0% of the digits
15 digits: 91.7% of the strings, 98.7% of the digits
20 digits: 51.8% of the strings, 91.3% of the digits
25 digits: 5.6% of the strings, 73.3% of the digits
30 digits: 0.0% of the strings, 53.8% of the digits

target: 6525378564826761271358100
output: ......58........72.......
Mô hình đã học được quy tắc của bài toán một cách hoàn hảo đối với các chuỗi ngắn: nó đảo ngược đúng toàn bộ các chuỗi dài 10 chữ số mà không mắc một lỗi nào. Thế nhưng ngay sau đó, độ chính xác sụp đổ nhanh chóng: một nửa số chuỗi dài 20 chữ số bị sai ít nhất một chỗ, và gần như toàn bộ các chuỗi dài 25 chữ số đều có lỗi. Mặc dù về mặt bản chất, việc đảo ngược một chuỗi 25 chữ số chẳng có gì phức tạp hơn một chuỗi 10 chữ số: mô hình chỉ việc đọc lại những gì nó vừa nhìn thấy. Sự khác biệt nằm ở chỗ trạng thái cuối cùng của bộ mã hóa — một vector gồm đúng 128 con số thực — buộc phải gánh toàn bộ các chữ số của chuỗi đầu vào; chuỗi càng có nhiều chữ số thì mỗi chữ số càng bị lưu giữ kém chính xác đi. Hãy nhìn kỹ vào ví dụ chuỗi dài 25 chữ số trong notebook. Những chữ số đầu tiên được bộ giải mã viết ra (vốn là những chữ số cuối cùng vừa được bộ mã hóa đọc vào) đều hoàn toàn chính xác — đúng như hiện tượng ở các câu đảo ngược của Sutskever và cộng sự. Các lỗi sai chỉ xuất hiện ở phần sau của chuỗi đầu ra, và chúng không hề sai một cách ngẫu nhiên: có tới hai lần mô hình viết nhầm vị trí của hai chữ số đứng cạnh nhau, viết "58" thay vì "85". Trạng thái ẩn vẫn nhớ được những chữ số nào đã xuất hiện, nhưng không còn nhớ chính xác vị trí tương đối giữa chúng. Nếu huấn luyện lâu hơn nữa, các đường cong có dịch sang phải đôi chút (chẳng hạn sau 10,000 lô thay vì 20,000 lô, mới chỉ có 28% chuỗi 20 chữ số đạt độ chính xác tuyệt đối), nhưng quy luật tụt dốc theo độ dài câu thì không thay đổi. Trạng thái cuối cùng của bộ mã hóa chỉ chứa được một lượng thông tin hữu hạn cố định, do đó chuỗi nguồn càng dài thì thông tin bị rơi rớt càng nhiều.
9.2 Cơ chế chú ý (Attention)
Tháng 9 năm 2014, chỉ vài ngày trước khi bài báo của nhóm Sutskever được công bố, Dzmitry Bahdanau, Kyunghyun Cho và Yoshua Bengio đã đề xuất một giải pháp tháo bỏ hoàn toàn nút thắt cổ chai này (Bahdanau et al., 2014). Ý tưởng của họ cực kỳ tự nhiên: hãy giữ lại tất cả các trạng thái của bộ mã hóa. Như chúng ta đã thấy ở mục 7.1, bộ mã hóa tạo ra một vector trạng thái sau mỗi từ của câu nguồn:
và bộ giải mã hoàn toàn có thể tham khảo toàn bộ chuỗi trạng thái đó, thay vì chỉ nhìn vào duy nhất trạng thái cuối cùng :
Tuy nhiên, tại mỗi bước sinh từ, bộ giải mã vẫn cần một vector đầu vào có kích thước cố định, trong khi số lượng trạng thái của bộ mã hóa lại thay đổi tùy theo độ dài câu nguồn. Giải pháp là tính một trung bình cộng có trọng số của các trạng thái bộ mã hóa — gọi là vector ngữ cảnh (context vector) — được tính toán lại tươi mới cho từng từ thứ mà bộ giải mã chuẩn bị viết ra:
Các trọng số cho biết những từ nào trong câu nguồn đang đóng vai trò quan trọng để viết ra từ đích tiếp theo. Để tính các trọng số này, bộ giải mã đem trạng thái hiện tại của chính nó so sánh với từng trạng thái của bộ mã hóa để thu được một điểm số tương hợp , sau đó đưa các điểm số này qua hàm softmax để chuẩn hóa thành các trọng số nằm trong khoảng từ 0 đến 1 và có tổng bằng 1:
Cách tính điểm số đơn giản nhất chính là tích vô hướng (dot product) giữa hai vector: ; tích này sẽ mang giá trị lớn đối với những trạng thái của bộ mã hóa có cùng hướng với trạng thái hiện tại của bộ giải mã. Sau đó, đầu dự đoán (head) sẽ đọc cả trạng thái của bộ giải mã lẫn vector ngữ cảnh để đưa ra phân phối xác suất cho từ tiếp theo. Trong công trình nguyên bản, Bahdanau và cộng sự tính điểm số bằng một mạng nơ-ron nhỏ từ trạng thái trước đó của bộ giải mã, đồng thời truyền vector ngữ cảnh vào cả bước cập nhật RNN của bộ giải mã. Một năm sau, Luong, Pham và Manning (Lương Minh Thắng, Phạm Hiếu và Christopher Manning) đã so sánh nhiều biến thể khác nhau và chỉ ra rằng phép tính tích vô hướng đơn giản hoạt động vô cùng hiệu quả (Luong et al., 2015): đây cũng chính là phiên bản mà chúng ta sẽ cài đặt trong bài tập dưới đây.
Không có ai chỉ dạy trước cho mạng biết từ nào ở câu nguồn tương ứng với từ nào ở câu dịch. Các trọng số được mạng tự tính toán và được học hoàn toàn tự động thông qua hàm mất mát của bài toán dịch máy bằng thuật toán lan truyền ngược, giống như mọi tham số khác trong mạng. Cơ chế này được đặt tên là cơ chế chú ý (attention): để viết ra mỗi từ đích, bộ giải mã chủ động quyết định xem cần “chú ý” (nhìn) vào những từ nào của câu nguồn. Với cơ chế chú ý, không còn một chiếc hộp đơn lẻ cố định nào chắn ngang giữa bộ mã hóa và bộ giải mã nữa: mỗi từ của bản dịch đều có thể đọc trực tiếp trạng thái của tất cả các từ trong câu nguồn, bất kể chúng nằm ở vị trí nào. Hãy di chuột qua các từ của câu dịch trong hình tương tác dưới đây để quan sát các trọng số chú ý ở từng bước.
Trong bài báo của mình, Bahdanau và cộng sự đã so sánh trực tiếp hai mô hình có cùng 1,000 đơn vị ẩn và được huấn luyện trên cùng một tập các cặp câu: mô hình mã hóa – giải mã thuần túy (RNNencdec) và mô hình có gắn cơ chế chú ý (RNNsearch). Khi huấn luyện trên các câu dài tới 50 từ, mô hình mã hóa – giải mã chỉ đạt điểm BLEU là 17.8, trong khi mô hình có cơ chế chú ý đạt tới 26.8 (và lên tới 28.5 khi huấn luyện lâu hơn). Sự chênh lệch lớn này đến từ chính những câu dài: “hiệu năng của RNNencdec sụt giảm thê thảm khi độ dài câu tăng lên”, trái lại mô hình có cơ chế chú ý “không hề cho thấy sự suy giảm hiệu năng nào ngay cả với những câu dài từ 50 từ trở lên”. Bộ mã hóa của họ là một mạng RNN hai chiều (bidirectional RNN – mục 7.1), nhờ đó trạng thái tại mỗi từ nắm giữ cả thông tin của những từ đứng sau nó; theo lời các tác giả: “chú giải (annotation) chứa đựng bản tóm tắt của cả các từ đứng trước lẫn các từ đứng sau”.
Bản thân các trọng số chú ý cũng có thể được trích xuất ra để quan sát trực quan. Đối với một cặp câu nguồn – đích, các trọng số này hợp thành một ma trận trong đó mỗi hàng ứng với một từ của bản dịch và mỗi cột ứng với một từ của câu nguồn: đó chính là bảng căn chỉnh từ (word alignment) mà chúng ta từng thấy ở hình minh họa mục 1.3, nhưng được mạng tự học hoàn toàn mà không cần bất kỳ một ví dụ gán nhãn căn chỉnh nào! Khi dịch câu tiếng Anh "The agreement on the European Economic Area was signed in August 1992." sang tiếng Pháp "L'accord sur la zone économique européenne a été signé en août 1992.", trọng số chú ý bám sát từng từ theo đúng thứ tự, ngoại trừ cụm tính từ được tiếng Pháp đảo ra sau danh từ: mô hình “đã có thể căn chỉnh chính xác từ [zone] với [Area], nhảy cóc qua hai từ ([European] và [Economic]), rồi sau đó lùi lại từng từ một để hoàn thiện trọn vẹn cụm từ [zone économique européenne]”.
Bây giờ, hãy bổ sung cơ chế chú ý vào mô hình đảo ngược chuỗi chữ số ở bài tập 9.1. Đối với bài toán đảo chuỗi, quy luật căn chỉnh chuẩn xác đã quá rõ ràng: để viết ra chữ số thứ , bộ giải mã cần sao chép chữ số thứ tính từ cuối chuỗi nguồn đếm ngược lại — và đó chính là nơi cơ chế chú ý cần nhìn vào.
Bài tập 9.2★ Bổ sung cơ chế chú ý vào mô hình mã hóa – giải mã
Hãy thêm cơ chế chú ý (attention) vào mô hình mã hóa – giải mã của bài tập 9.1. Tại mỗi vị trí của bộ giải mã, hãy tính tích vô hướng giữa trạng thái bộ giải mã với tất cả các trạng thái của bộ mã hóa, chuyển chúng thành các trọng số bằng hàm softmax, rồi đưa trung bình có trọng số của các trạng thái bộ mã hóa (vector ngữ cảnh) ghép cạnh trạng thái bộ giải mã vào tầng tuyến tính đầu ra. Hãy huấn luyện mô hình giống hệt bài tập 9.1, và vẽ đường cong độ chính xác theo độ dài chuỗi trên cùng biểu đồ với mô hình không có chú ý. Sau đó, hãy vẽ ma trận trọng số chú ý cho một chuỗi gồm 20 chữ số (mỗi hàng ứng với một chữ số được viết ra, mỗi cột ứng với một chữ số được đọc vào). Bộ giải mã đã nhìn vào chữ số nào của chuỗi nguồn để viết ra từng chữ số đích?
Mã khởi đầu đã chạy lại phần khởi tạo và các bước từ (1) đến (4) trong lời giải của bài tập 9.1 (huấn luyện lại mô hình không có chú ý mất khoảng ba phút trên CPU laptop). Mã cung cấp sẵn lớp EncoderDecoder cùng các hàm train, translate và accuracy_by_length để bạn tái sử dụng trực tiếp cho mô hình có cơ chế chú ý.
# Các chữ số từ 0 đến 9 là các token của chính chúng. Bộ giải mã
# đọc một token bắt đầu (10) trước khi viết chữ số đầu tiên.
# [Sao chép từ phần khởi đầu bài 9.1]
START = 10

# Một lô gồm n chuỗi chữ số ngẫu nhiên có cùng độ dài và các
# "bản dịch" của chúng: chính các chữ số đó theo thứ tự đảo ngược
# [Sao chép từ phần khởi đầu bài 9.1]
import torch

def make_batch(n, length):
    sources = torch.randint(0, 10, (n, length))
    targets = sources.flip(1)   # đảo ngược thứ tự các cột
    return sources, targets

torch.manual_seed(0)
sources, targets = make_batch(3, 8)
for source, target in zip(sources.tolist(), targets.tolist()):
    source_text = "".join(str(d) for d in source)
    target_text = "".join(str(d) for d in target)
    print(f"{source_text}  ->  {target_text}")


# (1) Mô hình. Một mạng GRU mã hóa đọc các chữ số nguồn, và trạng
# thái cuối cùng của nó làm trạng thái đầu tiên của mạng GRU giải mã.
# Bộ giải mã đọc token bắt đầu cùng các chữ số đã viết cho đến hiện
# tại, rồi đưa ra điểm số cho chữ số tiếp theo ở mỗi vị trí.
# [Sao chép từ lời giải bài 9.1, bước (1)]
from torch import nn
import torch.nn.functional as F

class EncoderDecoder(nn.Module):
    def __init__(self, D, H):
        super().__init__()
        self.source_embedding = nn.Embedding(10, D)
        self.encoder = nn.GRU(D, H, batch_first=True)
        self.target_embedding = nn.Embedding(11, D)  # có thêm START
        self.decoder = nn.GRU(D, H, batch_first=True)
        self.output = nn.Linear(H, 10)

    def forward(self, sources, decoder_inputs):
        e = self.source_embedding(sources)          # (batch, L, D)
        _, h = self.encoder(e)       # trạng thái cuối: (1, batch, H)
        d = self.target_embedding(decoder_inputs)   # (batch, N, D)
        states, _ = self.decoder(d, h)              # (batch, N, H)
        return self.output(states)                  # (batch, N, 10)


# (2) Huấn luyện với cưỡng bức giáo viên (teacher forcing): bộ giải mã
# đọc các chữ số đích thực sự, dịch sang phải một vị trí sau token
# bắt đầu. Mỗi lô có độ dài riêng từ 5 đến 30 nên không cần đệm.
# Viết thành hàm vì bài 9.2 sẽ huấn luyện thêm một mô hình nữa.
# [Sao chép từ lời giải bài 9.1, bước (2)]
import random

def train(model, steps=20_000, batch_size=64):
    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
    total_loss = 0
    for step in range(steps):
        length = random.randint(5, 30)
        sources, targets = make_batch(batch_size, length)
        starts = torch.full((batch_size, 1), START)
        decoder_inputs = torch.cat([starts, targets[:, :-1]], dim=1)
        scores = model(sources, decoder_inputs)
        loss = F.cross_entropy(scores.reshape(-1, 10),
                               targets.reshape(-1))
        optimizer.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        total_loss += loss.item()
        if (step + 1) % 5000 == 0:   # trung bình của 5.000 lô
            print(f"batches {step - 4998} to {step + 1}: "
                  f"loss {total_loss / 5000:.3f}")
            total_loss = 0

torch.manual_seed(0)
random.seed(0)
model = EncoderDecoder(D=32, H=128)
train(model)


# (3) Giải mã tham lam: bắt đầu từ token START và viết ra chữ số có
# điểm số cao nhất, từng chữ số một. Ở mỗi bước, mô hình đọc lại
# toàn bộ các chữ số đã viết: hơi lãng phí nhưng đơn giản và đủ
# nhanh cho 30 chữ số.
# [Sao chép từ lời giải bài 9.1, bước (3)]
def translate(model, sources):
    decoder_inputs = torch.full((len(sources), 1), START)
    with torch.no_grad():
        for _ in range(sources.shape[1]):
            scores = model(sources, decoder_inputs)  # (batch, N, 10)
            next_digits = scores[:, -1].argmax(dim=1)
            decoder_inputs = torch.cat(
                [decoder_inputs, next_digits[:, None]], dim=1)
    return decoder_inputs[:, 1:]   # bỏ token bắt đầu


# (4) Với mỗi độ dài, tính tỷ lệ chuỗi hoàn toàn không sai và tỷ lệ
# chữ số đúng trên 1.000 chuỗi mới
# [Sao chép từ lời giải bài 9.1, bước (4)]
lengths = list(range(5, 31))

def accuracy_by_length(model):
    string_accuracy, digit_accuracy = [], []
    for length in lengths:
        sources, targets = make_batch(1000, length)
        correct = translate(model, sources) == targets  # (1000, L)
        whole = correct.all(dim=1)   # một giá trị cho mỗi chuỗi
        string_accuracy.append(whole.float().mean().item())
        digit_accuracy.append(correct.float().mean().item())
    return string_accuracy, digit_accuracy

torch.manual_seed(1)
string_accuracy, digit_accuracy = accuracy_by_length(model)
print()
for length in [10, 15, 20, 25, 30]:
    i = lengths.index(length)
    print(f"{length} digits: "
          f"{string_accuracy[i]:.1%} of the strings, "
          f"{digit_accuracy[i]:.1%} of the digits")
49303973  ->  37930394
73166986  ->  68966137
68436914  ->  41963486
batches 1 to 5000: loss 0.709
batches 5001 to 10000: loss 0.293
batches 10001 to 15000: loss 0.182
batches 15001 to 20000: loss 0.119

10 digits: 100.0% of the strings, 100.0% of the digits
15 digits: 91.7% of the strings, 98.7% of the digits
20 digits: 51.8% of the strings, 91.3% of the digits
25 digits: 5.6% of the strings, 73.3% of the digits
30 digits: 0.0% of the strings, 53.8% of the digits
Hint
Mạng GRU của bộ mã hóa trả về chuỗi trạng thái sau mỗi chữ số có kích thước (batch, L, H), còn mạng GRU của bộ giải mã trả về chuỗi trạng thái có kích thước (batch, N, H). Phép nhân ma trận theo lô states @ encoder_states.transpose(1, 2) sẽ tính toàn bộ các tích vô hướng cùng một lúc, trả về một tensor có kích thước (batch, N, L): mỗi vị trí của bộ giải mã có một hàng gồm điểm số. Hàm torch.softmax(scores, dim=2) sẽ biến mỗi hàng đó thành các trọng số có tổng bằng 1, và phép nhân weights @ encoder_states sẽ cho ra ngay các vector ngữ cảnh có kích thước (batch, N, H).
Hint
Hãy viết mô hình mới dưới dạng một lớp con kế thừa từ EncoderDecoder: trong phương thức __init__, chỉ cần thay tầng đầu ra bằng nn.Linear(2 * H, 10); và trong phương thức forward, truyền cho tầng đầu ra tensor ghép nối torch.cat([states, contexts], dim=2). Khi đó, toàn bộ các hàm train, translate và accuracy_by_length của bài tập 9.1 sẽ hoạt động trơn tru mà không cần sửa đổi gì.
Hint
Để vẽ ma trận trọng số chú ý, hãy lưu trọng số vào một thuộc tính của mô hình ngay trong hàm forward (self.weights = weights). Sau khi gọi hàm translate, lần gọi mô hình cuối cùng đã đọc ký hiệu bắt đầu cùng toàn bộ các chữ số vừa viết ra (trừ chữ số cuối cùng), nên self.weights sẽ có đúng một hàng cho mỗi chữ số được viết ra. Dùng plt.imshow(weights) để vẽ ma trận nhiệt, và đánh dấu chữ thập (+) lên vị trí chữ số cần sao chép ở mỗi hàng bằng plt.scatter để kiểm tra xem trọng số lớn nhất có rơi đúng vào đó hay không.
Điểm kiểm tra kết quả bạn cần đạt được
Khi có thêm cơ chế chú ý, mô hình đảo ngược hoàn hảo 99.9% các chuỗi dài 10 chữ số, 93.8% các chuỗi dài 20 chữ số, và 82.1% các chuỗi dài 30 chữ số (với 95.3% số chữ số riêng lẻ được viết đúng). Trên biểu đồ, hai đường nét đứt của mô hình không có chú ý tụt lại rất xa phía dưới. Trong ma trận trọng số chú ý, mỗi hàng đều nổi bật lên một ô màu sẫm duy nhất, và các ô sẫm này xếp thành một đường chéo phụ (anti-diagonal) sắc nét. Tuy nhiên, các dấu chữ thập cho thấy: ngoại trừ hàng đầu tiên, ô màu sẫm ở tất cả các hàng còn lại đều nằm lệch sang bên phải một cột so với chữ số cần sao chép (19 trên 20 hàng đạt cực đại tại chữ số đứng ngay sau chữ số cần chép). Toàn bộ lời giải mất khoảng sáu phút trên CPU laptop (do mã khởi đầu huấn luyện lại cả mô hình bài 9.1). Kết quả của bạn có thể chênh lệch vài điểm phần trăm.
batches 1 to 5000: loss 0.113
batches 5001 to 10000: loss 0.011
batches 10001 to 15000: loss 0.007
batches 15001 to 20000: loss 0.004

10 digits: 99.9% of the strings, 100.0% of the digits
15 digits: 99.2% of the strings, 99.7% of the digits
20 digits: 93.8% of the strings, 98.2% of the digits
25 digits: 79.2% of the strings, 93.8% of the digits
30 digits: 82.1% of the strings, 95.3% of the digits
rows that peak on the digit to copy: 1 of 20
rows that peak on the digit just after it: 19 of 20
Lời giải 3 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
# Các chữ số từ 0 đến 9 là các token của chính chúng. Bộ giải mã
# đọc một token bắt đầu (10) trước khi viết chữ số đầu tiên.
# [Sao chép từ phần khởi đầu bài 9.1]
START = 10

# Một lô gồm n chuỗi chữ số ngẫu nhiên có cùng độ dài và các
# "bản dịch" của chúng: chính các chữ số đó theo thứ tự đảo ngược
# [Sao chép từ phần khởi đầu bài 9.1]
import torch

def make_batch(n, length):
    sources = torch.randint(0, 10, (n, length))
    targets = sources.flip(1)   # đảo ngược thứ tự các cột
    return sources, targets

torch.manual_seed(0)
sources, targets = make_batch(3, 8)
for source, target in zip(sources.tolist(), targets.tolist()):
    source_text = "".join(str(d) for d in source)
    target_text = "".join(str(d) for d in target)
    print(f"{source_text}  ->  {target_text}")


# (1) Mô hình. Một mạng GRU mã hóa đọc các chữ số nguồn, và trạng
# thái cuối cùng của nó làm trạng thái đầu tiên của mạng GRU giải mã.
# Bộ giải mã đọc token bắt đầu cùng các chữ số đã viết cho đến hiện
# tại, rồi đưa ra điểm số cho chữ số tiếp theo ở mỗi vị trí.
# [Sao chép từ lời giải bài 9.1, bước (1)]
from torch import nn
import torch.nn.functional as F

class EncoderDecoder(nn.Module):
    def __init__(self, D, H):
        super().__init__()
        self.source_embedding = nn.Embedding(10, D)
        self.encoder = nn.GRU(D, H, batch_first=True)
        self.target_embedding = nn.Embedding(11, D)  # có thêm START
        self.decoder = nn.GRU(D, H, batch_first=True)
        self.output = nn.Linear(H, 10)

    def forward(self, sources, decoder_inputs):
        e = self.source_embedding(sources)          # (batch, L, D)
        _, h = self.encoder(e)       # trạng thái cuối: (1, batch, H)
        d = self.target_embedding(decoder_inputs)   # (batch, N, D)
        states, _ = self.decoder(d, h)              # (batch, N, H)
        return self.output(states)                  # (batch, N, 10)


# (2) Huấn luyện với cưỡng bức giáo viên (teacher forcing): bộ giải mã
# đọc các chữ số đích thực sự, dịch sang phải một vị trí sau token
# bắt đầu. Mỗi lô có độ dài riêng từ 5 đến 30 nên không cần đệm.
# Viết thành hàm vì bài 9.2 sẽ huấn luyện thêm một mô hình nữa.
# [Sao chép từ lời giải bài 9.1, bước (2)]
import random

def train(model, steps=20_000, batch_size=64):
    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
    total_loss = 0
    for step in range(steps):
        length = random.randint(5, 30)
        sources, targets = make_batch(batch_size, length)
        starts = torch.full((batch_size, 1), START)
        decoder_inputs = torch.cat([starts, targets[:, :-1]], dim=1)
        scores = model(sources, decoder_inputs)
        loss = F.cross_entropy(scores.reshape(-1, 10),
                               targets.reshape(-1))
        optimizer.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        total_loss += loss.item()
        if (step + 1) % 5000 == 0:   # trung bình của 5.000 lô
            print(f"batches {step - 4998} to {step + 1}: "
                  f"loss {total_loss / 5000:.3f}")
            total_loss = 0

torch.manual_seed(0)
random.seed(0)
model = EncoderDecoder(D=32, H=128)
train(model)


# (3) Giải mã tham lam: bắt đầu từ token START và viết ra chữ số có
# điểm số cao nhất, từng chữ số một. Ở mỗi bước, mô hình đọc lại
# toàn bộ các chữ số đã viết: hơi lãng phí nhưng đơn giản và đủ
# nhanh cho 30 chữ số.
# [Sao chép từ lời giải bài 9.1, bước (3)]
def translate(model, sources):
    decoder_inputs = torch.full((len(sources), 1), START)
    with torch.no_grad():
        for _ in range(sources.shape[1]):
            scores = model(sources, decoder_inputs)  # (batch, N, 10)
            next_digits = scores[:, -1].argmax(dim=1)
            decoder_inputs = torch.cat(
                [decoder_inputs, next_digits[:, None]], dim=1)
    return decoder_inputs[:, 1:]   # bỏ token bắt đầu


# (4) Với mỗi độ dài, tính tỷ lệ chuỗi hoàn toàn không sai và tỷ lệ
# chữ số đúng trên 1.000 chuỗi mới
# [Sao chép từ lời giải bài 9.1, bước (4)]
lengths = list(range(5, 31))

def accuracy_by_length(model):
    string_accuracy, digit_accuracy = [], []
    for length in lengths:
        sources, targets = make_batch(1000, length)
        correct = translate(model, sources) == targets  # (1000, L)
        whole = correct.all(dim=1)   # một giá trị cho mỗi chuỗi
        string_accuracy.append(whole.float().mean().item())
        digit_accuracy.append(correct.float().mean().item())
    return string_accuracy, digit_accuracy

torch.manual_seed(1)
string_accuracy, digit_accuracy = accuracy_by_length(model)
print()
for length in [10, 15, 20, 25, 30]:
    i = lengths.index(length)
    print(f"{length} digits: "
          f"{string_accuracy[i]:.1%} of the strings, "
          f"{digit_accuracy[i]:.1%} of the digits")
49303973  ->  37930394
73166986  ->  68966137
68436914  ->  41963486
batches 1 to 5000: loss 0.709
batches 5001 to 10000: loss 0.293
batches 10001 to 15000: loss 0.182
batches 15001 to 20000: loss 0.119

10 digits: 100.0% of the strings, 100.0% of the digits
15 digits: 91.7% of the strings, 98.7% of the digits
20 digits: 51.8% of the strings, 91.3% of the digits
25 digits: 5.6% of the strings, 73.3% of the digits
30 digits: 0.0% of the strings, 53.8% of the digits
# (1) Mô hình ở bài 9.1 có thêm cơ chế chú ý (attention). Tầng đầu ra
# đọc trạng thái của bộ giải mã cùng một vector ngữ cảnh: trung bình
# của tất cả trạng thái bộ mã hóa, có trọng số là softmax của tích vô
# hướng giữa chúng với trạng thái bộ giải mã. Chỉ thay đổi tầng đầu
# ra và hàm forward().
class AttentionEncoderDecoder(EncoderDecoder):
    def __init__(self, D, H):
        super().__init__(D, H)
        self.output = nn.Linear(2 * H, 10)   # trạng thái và ngữ cảnh

    def forward(self, sources, decoder_inputs):
        e = self.source_embedding(sources)          # (batch, L, D)
        encoder_states, h = self.encoder(e)         # (batch, L, H)
        d = self.target_embedding(decoder_inputs)   # (batch, N, D)
        states, _ = self.decoder(d, h)              # (batch, N, H)
        # Mỗi trạng thái giải mã nhân với mỗi trạng thái mã hóa: (batch, N, L)
        scores = states @ encoder_states.transpose(1, 2)
        weights = torch.softmax(scores, dim=2)  # mỗi hàng có tổng bằng 1
        contexts = weights @ encoder_states         # (batch, N, H)
        self.weights = weights   # lưu lại để vẽ ở bước (4)
        both = torch.cat([states, contexts], dim=2)   # (batch, N, 2H)
        return self.output(both)                    # (batch, N, 10)


# (2) Huấn luyện giống hệt như mô hình không có cơ chế chú ý
torch.manual_seed(0)
random.seed(0)
attention_model = AttentionEncoderDecoder(D=32, H=128)
train(attention_model)


# (3) Độ chính xác của mô hình, vẽ trên cùng biểu đồ với mô hình
# không có chú ý (đường nét đứt)
torch.manual_seed(1)
accuracies = accuracy_by_length(attention_model)
attention_string_accuracy, attention_digit_accuracy = accuracies
print()
for length in [10, 15, 20, 25, 30]:
    i = lengths.index(length)
    print(f"{length} digits: "
          f"{attention_string_accuracy[i]:.1%} of the strings, "
          f"{attention_digit_accuracy[i]:.1%} of the digits")

import matplotlib.pyplot as plt

plt.figure(figsize=(5, 3.5))
plt.plot(lengths, attention_string_accuracy, color="C0",
         label="whole string, attention")
plt.plot(lengths, attention_digit_accuracy, color="C1",
         label="digits, attention")
plt.plot(lengths, string_accuracy, color="C0", linestyle="--",
         label="whole string, no attention")
plt.plot(lengths, digit_accuracy, color="C1", linestyle="--",
         label="digits, no attention")
plt.ylim(0, 1.05)
plt.xlabel("number of digits")
plt.ylabel("accuracy")
plt.legend()
plt.show()
batches 1 to 5000: loss 0.113
batches 5001 to 10000: loss 0.011
batches 10001 to 15000: loss 0.007
batches 15001 to 20000: loss 0.004

10 digits: 99.9% of the strings, 100.0% of the digits
15 digits: 99.2% of the strings, 99.7% of the digits
20 digits: 93.8% of the strings, 98.2% of the digits
25 digits: 79.2% of the strings, 93.8% of the digits
30 digits: 82.1% of the strings, 95.3% of the digits
# (4) Trọng số chú ý cho một chuỗi 20 chữ số. Lần gọi mô hình cuối
# cùng trong translate() đọc 19 chữ số đã viết trước chữ số cuối nên
# lưu giữ trọng số của cả 20 vị trí: mỗi hàng ứng với một chữ số
# được viết, mỗi cột ứng với một chữ số được đọc.
torch.manual_seed(2)
sources, targets = make_batch(1, 20)
output = translate(attention_model, sources)
weights = attention_model.weights[0]    # (20, 20)

# Chữ số thứ k được viết sẽ sao chép chữ số thứ k tính từ cuối chuỗi
# nguồn: ở hàng k, chữ số cần sao chép nằm tại cột 19 - k
to_copy = torch.arange(19, -1, -1)
peaks = weights.argmax(dim=1)   # cột có trọng số lớn nhất
print(f"rows that peak on the digit to copy: "
      f"{(peaks == to_copy).sum().item()} of 20")
print(f"rows that peak on the digit just after it: "
      f"{(peaks == to_copy + 1).sum().item()} of 20")

# Vẽ ma trận, đánh dấu nhân (x) vào chữ số cần sao chép ở mỗi hàng
plt.figure(figsize=(4.5, 4.5))
plt.imshow(weights, cmap="Blues")
plt.scatter(to_copy, range(20), marker="x", color="C1", s=15)
plt.xticks(range(20), sources[0].tolist())
plt.yticks(range(20), output[0].tolist())
plt.xlabel("digit read by the encoder")
plt.ylabel("digit written by the decoder")
plt.show()
rows that peak on the digit to copy: 1 of 20
rows that peak on the digit just after it: 19 of 20
Với cùng số lượng đơn vị ẩn và cùng số bước huấn luyện, cơ chế chú ý đã thay đổi cục diện hoàn toàn: đối với các chuỗi dài 30 chữ số, mô hình đảo đúng trọn vẹn 82% số chuỗi thay vì 0% như trước, và viết đúng 95% số chữ số thay vì 54%. Mô hình không còn phải ép toàn bộ chuỗi nguồn vào một vector duy nhất nữa: để viết ra mỗi chữ số, nó đọc trực tiếp từ các trạng thái của bộ mã hóa. Ma trận trọng số chú ý cho thấy rõ cách nó vận hành. Mỗi hàng chỉ có một ô sẫm màu duy nhất, nghĩa là ở mỗi bước viết, bộ giải mã tập trung nhìn vào đúng một vị trí trong chuỗi nguồn, và các vị trí này tạo thành đường chéo phụ đặc trưng của phép đảo chuỗi — một sự căn chỉnh tự nhiên mà không ai lập trình sẵn cho mô hình. Tuy nhiên, hãy quan sát thật kỹ một chi tiết thú vị: bộ giải mã không nhìn vào trạng thái của bộ mã hóa ngay tại chữ số mà nó đang cần sao chép, mà lại nhìn vào trạng thái ngay kế tiếp (sau chữ số đứng liền sau trong chuỗi nguồn)! Vì mạng GRU có khả năng nhớ các chữ số vừa đi qua trước đó, nên trạng thái kế tiếp này vẫn lưu giữ đầy đủ thông tin về chữ số cần chép. Hơn nữa, trạng thái kế tiếp đó có lẽ dễ được tìm thấy hơn nhiều, bởi nó vừa mới đọc xong chính chữ số mà bộ giải mã vừa viết ra ở bước ngay trước đó (hai trạng thái vừa xử lý cùng một chữ số nên dễ có tích vô hướng lớn). Hãy nhớ rằng các trọng số chú ý trỏ vào các trạng thái ẩn, chứ không phải trỏ vào bản thân các từ rời rạc, và trạng thái của một mạng RNN thì chứa nhiều thông tin hơn là chỉ riêng từ tại vị trí đó. Nhờ cơ chế chú ý, mỗi chữ số ở đầu ra được đọc trực tiếp từ chuỗi nguồn, giúp độ chính xác ít bị phụ thuộc vào độ dài chuỗi hơn hẳn.
Trong các mô hình dịch máy thế hệ này, cơ chế chú ý đóng vai trò trợ lực cho các mạng RNN: bộ mã hóa vẫn đọc câu nguồn lần lượt từng từ một, và bộ giải mã vẫn viết bản dịch lần lượt từng từ một. Ba năm sau, kiến trúc Transformer đã giữ lại cơ chế chú ý và loại bỏ hoàn toàn các mạng RNN — đó chính là chủ đề của mục 10.
9.3 Đo lường chất lượng bản dịch (BLEU và Dịch máy thống kê)
Làm sao để đánh giá một bản dịch là tốt hay dở? Đối với bài toán đảo chuỗi chữ số của chúng ta, chỉ có duy nhất một đáp án đúng tuyệt đối nên ta có thể đếm lỗi dễ dàng. Nhưng với ngôn ngữ tự nhiên, một câu văn có vô vàn cách dịch hay khác nhau, và những giám khảo tốt nhất chính là những người đọc bằng xương bằng thịt. Thế nhưng, như Kishore Papineni cùng các đồng nghiệp tại IBM đã viết vào năm 2002: “Đánh giá bằng con người có thể mất hàng tháng trời để hoàn thành và tiêu tốn sức lao động không thể tái sử dụng cho lần sau”. Vì vậy, họ đã đề xuất một thước đo tự động mang tên BLEU (viết tắt của bilingual evaluation understudy – Trợ lý đánh giá song ngữ), dựa trên một nguyên lý cốt lõi: “Một bản dịch máy càng gần với bản dịch của biên dịch viên con người chuyên nghiệp thì bản dịch đó càng tốt” (Papineni et al., 2002). Thước đo BLEU đem bản dịch ứng viên của máy (candidate) so sánh với một hoặc nhiều bản dịch mẫu do con người viết sẵn (references), rồi đếm xem có bao nhiêu cụm n-gram (với từ 1 đến 4) trong bản dịch máy cũng xuất hiện trong bản dịch mẫu.
Hãy thử dịch ngược câu tiếng Pháp trong hình minh họa trước đó về lại tiếng Anh. Giả sử câu mẫu tham chiếu (reference) là "I loved this great movie", khi đó bản dịch ứng viên của máy "I loved this great film" sẽ đạt các độ chuẩn xác (precisions) sau đây — tức tỷ lệ các cụm n-gram của câu ứng viên có xuất hiện trong câu tham chiếu:
| Các cụm n-gram của bản dịch ứng viên | Số cụm có trong câu tham chiếu | Độ chuẩn xác () | |
|---|---|---|---|
| 1 | I, loved, this, great, film | 4 trên 5 | 0.80 |
| 2 | I loved, loved this, this great, great film | 3 trên 4 | 0.75 |
| 3 | I loved this, loved this great, this great film | 2 trên 3 | 0.67 |
| 4 | I loved this great, loved this great film | 1 trên 2 | 0.50 |
Điểm BLEU cơ sở chính là trung bình nhân (geometric mean) của bốn độ chuẩn xác này: , thường được viết theo thang phần trăm là 66.9. Để ngăn các hệ thống dịch máy “gian lận” điểm số, công thức BLEU áp dụng thêm hai hiệu chỉnh quan trọng. Thứ nhất, mỗi cụm n-gram trong bản dịch ứng viên chỉ được đếm tối đa bằng số lần cụm đó xuất hiện trong bản dịch tham chiếu: nếu không có quy tắc cắt trần này, một câu vô nghĩa lặp đi lặp lại như "the the the the the the the" sẽ đạt độ chuẩn xác unigram tuyệt đối 7/7 khi so với câu mẫu "The cat is on the mat.", thay vì mức hợp lý là 2/7. Thứ hai, một câu dịch cụt ngủn kiểu như "I loved" sẽ dễ dàng đạt độ chuẩn xác 100% ở các từ nó viết ra; do đó BLEU nhân trung bình nhân ở trên với một hệ số phạt câu ngắn (brevity penalty – BP) có giá trị nhỏ hơn 1 khi bản dịch ứng viên ngắn hơn bản dịch tham chiếu:
trong đó là độ chuẩn xác của các cụm n-gram, là tổng số từ của bản dịch ứng viên, và là tổng số từ của bản dịch tham chiếu.
Ví dụ nhỏ trên đây cũng phơi bày luôn hạn chế cố hữu của thước đo BLEU: nó chỉ đếm sự trùng khớp bề mặt của từ ngữ chứ không hiểu ngữ nghĩa. Từ "film" rõ ràng là một cách dịch hoàn toàn chuẩn xác của từ tiếng Pháp "film", thế nhưng việc dùng từ "film" thay vì "movie" như câu tham chiếu đã làm bản dịch ứng viên bị mất đứt một phần ba tổng điểm số! Đó là lý do các bộ dữ liệu kiểm tra chất lượng dịch thuật thường cung cấp nhiều bản dịch tham chiếu khác nhau cho mỗi câu, và cũng là lý do điểm BLEU luôn được tính gộp trên toàn bộ tập kiểm tra (corpus-level): các cụm n-gram của tất cả các câu được cộng dồn lại rồi mới tính các tỷ lệ chuẩn xác . Các tác giả của BLEU cũng cảnh báo rằng nếu chỉ tính trên từng câu đơn lẻ, “điểm số trên từng câu riêng biệt sẽ thường xuyên sai lệch so với đánh giá của con người”. Ngược lại, khi tính trên toàn bộ một tập kiểm tra lớn, điểm số BLEU của năm hệ thống dịch thuật (gồm hai dịch giả con người và ba hệ thống dịch máy) bám sát điểm chấm của các giám khảo con người với hệ số tương quan lên tới 0.99. Nhờ vậy, BLEU đã trở thành thước đo tiêu chuẩn thống trị ngành dịch máy trong suốt hai thập kỷ tiếp theo.
Các hệ thống dịch máy thống kê dựa trên cụm từ (phrase-based statistical systems) chính là cột mốc tham chiếu mà những bài báo dịch máy nơ-ron đầu tiên phải đối đầu. Dòng mô hình này bắt nguồn từ chuỗi công trình tiên phong tại IBM vào cuối những năm 1980. Để dịch một câu tiếng Pháp sang tiếng Anh, Brown và cộng sự tìm kiếm câu tiếng Anh làm cực đại hóa tích xác suất : bao gồm một mô hình ngôn ngữ (chẳng hạn như các mô hình n-gram ở mục 2) và một mô hình dịch thuật được học từ các cặp câu song ngữ thông qua việc căn chỉnh (alignment) các từ giữa hai câu. Sau đó, Koehn, Och và Marcu đã thay thế đơn vị từ đơn lẻ bằng các cụm từ (phrases) — ở đây hiểu đơn giản là các chuỗi từ liên tiếp bất kỳ chứ không nhất thiết phải là cụm từ theo ngữ pháp học — được trích xuất tự động từ kết quả căn chỉnh từ kèm theo xác suất dịch tương ứng (Koehn et al., 2003). Đáng ngạc nhiên là “việc giới hạn độ dài tối đa chỉ ở mức ba từ mỗi cụm đã đạt được hiệu năng đỉnh cao”, và việc ép hệ thống chỉ giữ lại những cụm từ đúng cấu trúc ngữ pháp thậm chí còn làm cho chất lượng bản dịch tệ đi! Một hệ thống dịch dựa trên cụm từ hoàn chỉnh sẽ kết hợp một bảng tra cứu gồm hàng triệu cụm từ, một mô hình ngôn ngữ n-gram, một mô hình đổi chỗ (reordering model) các cụm từ cùng một vài điểm số phụ trợ khác, với các trọng số được tinh chỉnh để tối đa hóa điểm BLEU. Bộ công cụ mã nguồn mở Moses đã đưa các hệ thống này trở thành tiêu chuẩn công nghiệp trong suốt nhiều năm.
Trên bộ dữ liệu chuẩn được các bài báo dịch nơ-ron đầu tiên sử dụng — tác vụ dịch từ tiếng Anh sang tiếng Pháp thuộc khuôn khổ cuộc thi dịch máy thường niên WMT’14 — hệ thống Moses đạt điểm BLEU là 33.3, còn hệ thống tốt nhất toàn cuộc thi năm đó (cũng dựa trên cụm từ) đạt 37.0 khi chấm theo cùng quy chuẩn. Tổ hợp mô hình (ensemble) của Sutskever và cộng sự đạt 34.8 khi tự dịch độc lập, và tăng lên 36.5 khi được dùng để xếp hạng lại (re-rank) 1,000 bản dịch tốt nhất do Moses đề xuất. Mô hình có cơ chế chú ý của Bahdanau và cộng sự đạt 28.5 trên toàn bộ tập kiểm tra, nhưng nếu chỉ xét trên những câu không chứa từ lạ ngoài từ vựng thì nó đạt tới 36.2 so với 35.6 của Moses: với bộ từ vựng giới hạn ở 30,000 từ, các từ hiếm chính là gót chân Achilles của dịch máy nơ-ron thế hệ đầu, cho đến khi kỹ thuật tách từ phụ (subwords – hộp thông tin ở mục 7.3) ra đời (Sennrich et al., 2016). Hai năm sau, hệ thống dịch máy nơ-ron của Google (GNMT) đã kết hợp 8 tầng LSTM ở cả bộ mã hóa lẫn bộ giải mã, cơ chế chú ý và bộ từ vựng từ phụ; một tổ hợp gồm 8 mô hình như vậy đã vọt lên mức 41.2 điểm BLEU. Tháng 9 năm 2016, nó chính thức thay thế hệ thống dịch dựa trên cụm từ lâu năm của Google Translate cho cặp ngôn ngữ Trung – Anh.
Nếu muốn tìm hiểu sâu hơn, bạn có thể thử sức với một số bài tập mở rộng dưới đây.
Sao chép thay vì đảo ngược. Hãy huấn luyện mô hình mã hóa – giải mã ở bài tập 9.1 để sao chép nguyên vẹn các chuỗi chữ số theo đúng thứ tự từ trái sang phải. Tác vụ sao chép xuôi này dễ hơn hay khó hơn so với đảo ngược chuỗi? Hãy giải thích sự khác biệt đó bằng liên hệ với mẹo đảo câu nguồn của Sutskever và cộng sự.
Những chuỗi dài hơn tập huấn luyện. Hãy đem hai mô hình đã huấn luyện ở bài tập 9.1 và 9.2 chạy kiểm tra trên các chuỗi có độ dài từ 31 đến 50 chữ số — tức dài hơn bất kỳ chuỗi nào chúng từng gặp trong quá trình huấn luyện. Cơ chế chú ý có còn giữ được hiệu quả vượt trội không? Hãy vẽ và quan sát các trọng số chú ý từ sau chữ số thứ 30 trở đi.
Sắp xếp các chữ số. Hãy huấn luyện mô hình có cơ chế chú ý ở bài tập 9.2 để sắp xếp các chữ số theo thứ tự tăng dần thay vì đảo ngược chúng. Khi đó, ma trận trọng số chú ý sẽ có hình dạng như thế nào?
Cộng hai số tự nhiên. Hãy huấn luyện mô hình ở bài tập 9.2 thực hiện phép cộng hai số được viết dưới dạng chuỗi ký tự, ví dụ như "4817+305" → "5122". Gợi ý: việc cho bộ giải mã viết các chữ số của tổng theo thứ tự từ hàng đơn vị ngược lên (giống như cách chúng ta đặt tính cộng bằng tay) có thể giúp mô hình học dễ hơn nhiều. Khi đó, cơ chế chú ý sẽ nhìn vào những vị trí nào ở mỗi bước?
Hàm tính điểm của Bahdanau và cộng sự. Hãy thay thế phép tính tích vô hướng trong bài tập 9.2 bằng mạng nơ-ron nhỏ của Bahdanau và cộng sự: , trong đó và là các ma trận kích thước còn là vector kích thước (Bahdanau et al., 2014). Mô hình có học nhanh hơn không?
Dịch máy thực thụ. Hãy huấn luyện mô hình mã hóa – giải mã có cơ chế chú ý để dịch từ tiếng Anh sang tiếng Pháp trên tập dữ liệu các cặp câu song ngữ sentence-transformers/parallel-sentences-tatoeba (cấu hình en-fr, gồm 273,270 cặp câu ngắn với độ dài trung vị là 7 từ tiếng Anh), rồi đo điểm BLEU của mô hình bằng thư viện sacrebleu. Một số bộ dữ liệu khác bạn có thể thử: bentrevett/multi30k (chỉ gồm tiếng Anh và tiếng Đức), hoặc Helsinki-NLP/opus_books (cấu hình en-fr, gồm các câu dài hơn trích từ sách văn học).
10. Lời kết: Kiến trúc Transformer kế thừa câu chuyện lịch sử như thế nào?
Ở cuối mục 9, cơ chế chú ý (attention) đóng vai trò hỗ trợ cho hai mạng RNN: bộ mã hóa vẫn đọc câu nguồn lần lượt từng từ một, và bộ giải mã vẫn viết ra bản dịch lần lượt từng từ một. Thế nhưng vào tháng 6 năm 2017, một nhóm nghiên cứu tại Google đã mạnh dạn loại bỏ hoàn toàn các mạng RNN và chỉ giữ lại duy nhất cơ chế chú ý. Kiến trúc của họ — Transformer — đã trở thành nền tảng cốt lõi của tất cả các mô hình ngôn ngữ lớn (LLM) ngày nay.
Mặc dù chúng ta sẽ chưa đi sâu vào chi tiết toán học của Transformer ngay tại đây (đó là nội dung của các chương sau), nhưng có một sự thật lịch sử rất đáng nhấn mạnh: trước năm 2019 (trước khi GPT-2 ra đời), kiến trúc Transformer không hề được tạo ra với mục đích xây dựng các mô hình LLM sinh văn bản hay các chatbot hội thoại như chúng ta thấy ngày nay, mà đơn thuần chỉ là một công cụ tốt hơn để giải quyết hai bài toán NLP kinh điển: phân loại văn bản và dịch máy! Hãy cùng nhìn lại xem câu chuyện ấy đã khởi đầu như thế nào.
10.1 Transformer thay thế cho RNN
Trong các mạng RNN, tính chất truy hồi tuần tự gây ra hai cái giá rất đắt. Cái giá thứ nhất nằm ở dòng chảy đạo hàm (gradient flow). Như chúng ta đã kiểm chứng ở bài tập 7.2a, giữa hai từ đứng cách xa nhau, cả thông tin lẫn tín hiệu gradient đều phải đi qua mọi bước trung gian ở giữa; ngay cả trong mạng LSTM, độ lớn của gradient truyền về tới một từ vẫn suy giảm dần theo khoảng cách từ từ đó đến cuối văn bản. Cái giá thứ hai là thời gian tính toán tuần tự. Để tính được trạng thái ẩn sau từ thứ , mạng RNN bắt buộc phải chờ tính xong trạng thái sau từ thứ ; do đó, trạng thái của một văn bản chỉ có thể được tính nối tiếp nhau từng bước một.
Một bộ xử lý đồ họa (GPU) sở dĩ cực nhanh là nhờ nó có thể thực hiện hàng nghìn phép tính cùng một lúc, nhưng bên trong một đoạn văn bản cho trước, mạng RNN lại không thể giao cho GPU nhiều phép tính độc lập để làm song song. Như Vaswani và cộng sự đã viết: “Bản chất tuần tự cố hữu này ngăn cản việc tính toán song song bên trong từng mẫu huấn luyện, một rào cản trở nên đặc biệt nghiêm trọng khi độ dài chuỗi tăng lên” (Vaswani et al., 2017).
Ý tưởng đột phá của Transformer là thay thế phép truy hồi tuần tự bằng cơ chế chú ý diễn ra ngay bên trong bản thân văn bản đó. Ở mục 9.2, bộ giải mã đem trạng thái của nó so sánh với trạng thái của tất cả các từ trong câu nguồn. Còn trong cơ chế tự chú ý (self-attention), mỗi từ trong một văn bản cũng thực hiện đúng phép so sánh đó nhưng là với tất cả các từ thuộc chính văn bản ấy (bao gồm cả chính nó).
Mỗi từ sẽ chấm một điểm số tương hợp cho mọi từ khác trong văn bản thông qua phép tích vô hướng giống như ở mục 9.2 (được tính sau khi các vector đã đi qua các phép biến đổi tuyến tính học được — chi tiết này sẽ được học kỹ ở chương Transformer). Hàm softmax chuyển các điểm số đó thành các trọng số cộng lại bằng 1, và vector biểu diễn mới của từ đang xét sẽ là trung bình cộng có trọng số của các vector thuộc tất cả các từ trong câu. Cơ chế này xóa bỏ hoàn toàn cả hai gánh nặng của mạng truy hồi. Hai từ bất kỳ trong văn bản giờ đây được kết nối trực tiếp với nhau chỉ trong một bước duy nhất, bất kể chúng đứng cách xa nhau bao nhiêu từ — nhờ vậy thông tin và tín hiệu gradient không còn phải chen chúc đi qua các từ trung gian ở giữa nữa. Đồng thời, vector mới của tất cả các từ trong câu đều được tính toán cùng một lúc chỉ bằng một vài phép nhân ma trận — đúng sở trường mạnh nhất của GPU. Một mạng Transformer xếp chồng nhiều tầng như vậy lên nhau: mỗi tầng tiếp theo lại tính ra các vector biểu diễn mới tinh tế hơn từ các vector của tầng ngay bên dưới.
Tuy nhiên, một phép lấy trung bình có trọng số tự bản thân nó hoàn toàn không phụ thuộc vào thứ tự của các từ; nếu chỉ dùng cơ chế tự chú ý thuần túy, mạng sẽ lại nhìn văn bản giống như một túi từ (bag of words) không hơn không kém, y hệt như các mạng lấy trung bình ở mục 4.3. Đó là lý do tại sao ở đầu vào của Transformer, vector của mỗi từ được tính bằng tổng của vector nhúng từ (word embedding) cộng với một vector mã hóa vị trí của từ đó trong văn bản (positional encoding / positional embedding).
Mô hình Transformer nguyên bản của Vaswani và cộng sự là một kiến trúc mã hóa – giải mã (encoder–decoder) giống như các mô hình ở mục 9, được thiết kế cho bài toán dịch máy. Chắc hẳn bạn đã từng nhìn thấy sơ đồ kiến trúc nổi tiếng trích từ bài báo gốc được hiển thị dưới đây, và có thể thấy nó trông khá rườm rà so với các mô hình chỉ dùng bộ giải mã (decoder-only) phổ biến ngày nay. Quả thực, ngày nay khi nhắc đến “mô hình Transformer”, người ta gần như mặc định đánh đồng nó với “mô hình ngôn ngữ lớn tự hồi quy (autoregressive LLM)”, mà quên mất rằng bài toán khai sinh ra kiến trúc Transformer chính là dịch máy!
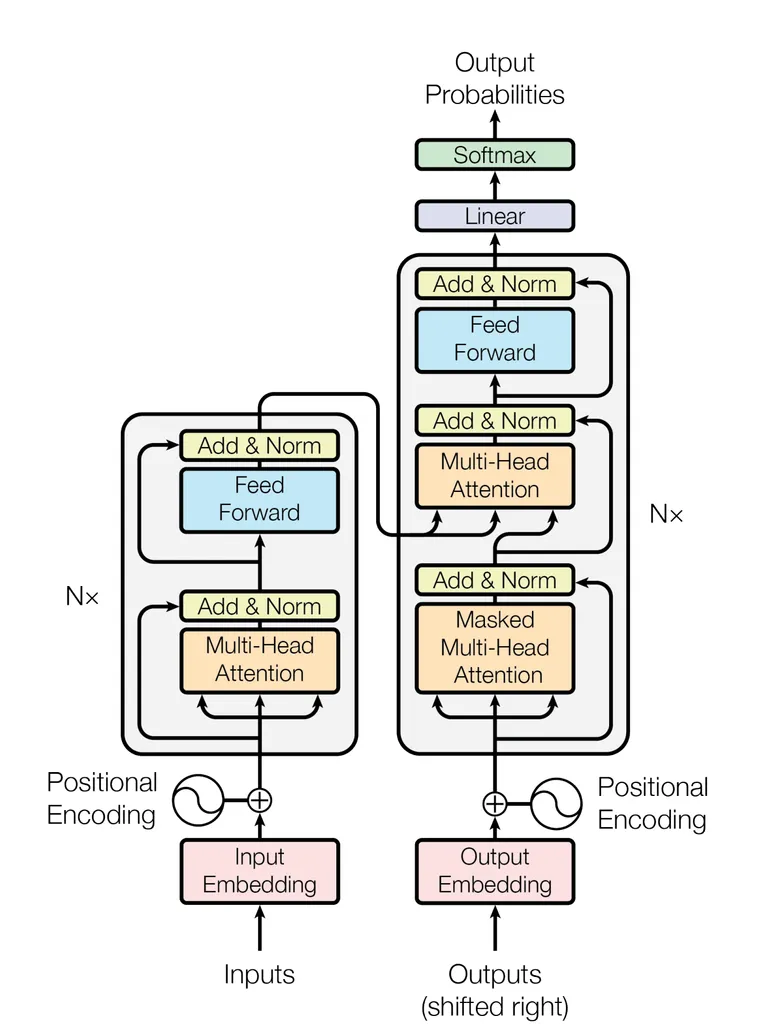
Bộ mã hóa (encoder) nằm ở nhánh bên trái của sơ đồ là một chồng các tầng tự chú ý làm nhiệm vụ đọc câu nguồn. Bộ giải mã (decoder) nằm ở nhánh bên phải vừa chú ý (attend) sang các vector của bộ mã hóa giống như bộ giải mã ở mục 9.2, vừa áp dụng cơ chế tự chú ý lên phần bản dịch đã được viết ra tính đến thời điểm đó. Trong quá trình huấn luyện, bộ giải mã tính toán dự đoán cho tất cả các vị trí của câu dịch cùng một lúc, do đó tầng tự chú ý của nó bắt buộc phải có một mặt nạ che (mask) (khối "Masked Multi-Head Attention" trong sơ đồ): mỗi vị trí chỉ được phép chú ý vào chính nó và các vị trí đứng trước nó, tuyệt đối không được nhìn trộm vào các từ đứng sau mà nó đang phải dự đoán. Như bài báo giải thích, mặt nạ này có mặt ở đó “nhằm ngăn các vị trí chú ý vào những vị trí xuất hiện sau chúng”.
10.2 BERT
Kiến trúc Transformer vốn được chế tạo để dịch máy, nhưng nếu chúng ta chỉ tách riêng nhánh bộ mã hóa (encoder) của nó ra, thì bộ mã hóa này làm được chính xác điều mà chúng ta hằng tìm kiếm ở mục 8: đó là một mạng nơ-ron đọc toàn bộ văn bản và cung cấp cho mỗi từ một vector biểu diễn phụ thuộc vào tất cả các từ khác trong câu (lại còn huấn luyện nhanh hơn mạng LSTM gấp nhiều lần!). Tháng 10 năm 2018, Jacob Devlin cùng các đồng nghiệp tại Google đã tiền huấn luyện một bộ mã hóa Transformer trên kho văn bản thô khổng lồ, sau đó đem tinh chỉnh (fine-tune) nó cho từng tác vụ cụ thể, giống hệt chiến lược mà ULMFiT đã làm với mạng LSTM (Devlin et al., 2019). Họ đặt tên cho mô hình này là BERT, viết tắt của bidirectional encoder representations from transformers (Biểu diễn bộ mã hóa hai chiều từ Transformer). Một lần nữa, cần nhấn mạnh rằng họ không hề có ý định tạo ra một mô hình LLM tự hồi quy để sinh văn bản; họ chỉ đơn giản là đang tìm kiếm một bộ mã hóa văn bản ưu việt hơn để giải quyết các bài toán NLP hạ nguồn (downstream tasks) truyền thống.
Nhưng làm thế nào để tiền huấn luyện một bộ mã hóa như vậy? Nói cách khác, bài toán tự giám sát nào có thể huấn luyện được một bộ mã hóa trên văn bản thô? Một mô hình ngôn ngữ truyền thống dự đoán từ tiếp theo dựa trên các từ đứng trước nó, nghĩa là nó bỏ qua hoàn toàn các từ đứng ở phía sau. Đây là một sự lãng phí lớn đối với một bộ mã hóa — vốn có nhiệm vụ đọc hiểu toàn bộ văn bản: như nhóm tác giả nhận xét, “Hạn chế lớn nhất là các mô hình ngôn ngữ tiêu chuẩn chỉ hoạt động một chiều (unidirectional)”. Trước đó, ELMo đã lách qua hạn chế này bằng cách ghép hai mô hình ngôn ngữ đọc hai chiều ngược nhau (mục 8.2), nhưng bản thân mỗi mô hình thành phần vẫn chỉ nhìn thấy một phía của từ. Hơn nữa, một bộ mã hóa Transformer không thể nào huấn luyện theo kiểu mô hình ngôn ngữ thông thường được: bởi ở mỗi tầng, mọi từ đều chú ý tới mọi từ khác, nên qua nhiều tầng, từ cần dự đoán sẽ tự nhìn thấy chính nó trong dữ liệu đầu vào!
Giải pháp của BERT là che giấu các từ đi (masking). Trong mỗi văn bản đầu vào, 15% số token được chọn ra một cách ngẫu nhiên và bị thay thế bằng một ký hiệu đặc biệt là [MASK]; nhiệm vụ của BERT là phải đoán lại đúng các token bị che đó dựa vào tất cả các token còn lại ở cả hai phía trái và phải. (Để tránh tạo ra sự lệch pha với giai đoạn tinh chỉnh — nơi không có token [MASK] nào xuất hiện — trong số 15% token được chọn ra đó, chỉ có 80% thời gian chúng bị thay bằng thẻ [MASK], 10% thời gian bị thay bằng một từ ngẫu nhiên khác, và 10% thời gian được giữ nguyên không đổi.) Mục tiêu mô hình hóa ngôn ngữ có mặt nạ che (masked language model – MLM) này được “lấy cảm hứng từ bài kiểm tra Cloze” — một bài trắc nghiệm đánh giá độ hiểu văn bản ra đời từ năm 1953, trong đó người đọc phải điền từ còn thiếu vào chỗ trống. Thực chất, đây cũng chính là bài toán của mô hình CBOW mà chúng ta đã học ở mục 5.2 (dự đoán một từ ở giữa từ các từ xung quanh nó), chỉ khác ở chỗ ngữ cảnh giờ đây mở rộng ra toàn bộ văn bản, và mô hình dự đoán là một mạng Transformer sâu thay vì chỉ lấy trung bình cộng các vector nhúng.
BERT được tiền huấn luyện trên một kho ngữ liệu gồm 3.3 tỷ từ: bao gồm BooksCorpus (800 triệu từ trích từ các cuốn sách chưa xuất bản) và toàn bộ Wikipedia tiếng Anh (2,500 triệu từ). Bộ từ vựng của nó gồm 30,000 mảnh WordPiece — tức các từ phụ (subwords) giống như đã giải thích trong hộp thông tin ở mục 7.3 — nhờ đó không còn bất kỳ từ nào bị coi là từ lạ ngoài từ vựng. BERT được công bố với hai kích thước. Phiên bản BERT base có 12 tầng, kích thước vector ẩn 768 và 12 đầu chú ý, tổng cộng 110 triệu tham số. Phiên bản BERT large có 24 tầng, kích thước vector ẩn 1,024 và 16 đầu chú ý, tổng cộng 340 triệu tham số. Mỗi quá trình tiền huấn luyện như vậy chỉ mất 4 ngày chạy trên các vi mạch chuyên dụng TPU của Google.
Giờ đây, với một bộ mã hóa Transformer, ta thu được một vector biểu diễn ẩn cho mỗi từ trong văn bản. Nhưng nếu muốn thực hiện bài toán phân loại văn bản, thứ chúng ta cần lại là một vector biểu diễn có kích thước cố định duy nhất đại diện cho toàn bộ văn bản đó. Làm thế nào BERT biến một văn bản có độ dài bất kỳ thành một vector có kích thước cố định? Bằng một mẹo thiết kế khéo léo đưa chúng ta quay trở lại với sơ đồ chiếc hộp ở mục 3: một ký hiệu đặc biệt là [CLS] (viết tắt của classification – phân loại) được gắn thêm vào ngay đầu mỗi văn bản, và BERT tính toán một vector mới cho nó qua từng tầng giống hệt như mọi token khác:
Bản thân thẻ [CLS] không phải là một từ mang nghĩa riêng trong văn bản, nên vector của nó không bị ràng buộc phải biểu diễn một từ cụ thể nào: thông qua cơ chế tự chú ý xuyên suốt 12 tầng mạng, nó tự do thu thập và tổng hợp mọi thông tin cần thiết từ tất cả các từ trong câu. Để dạy cho thẻ [CLS] biết cách tổng hợp thông tin toàn cục ngay từ lúc tiền huấn luyện, nhóm tác giả bổ sung một tác vụ tiền huấn luyện thứ hai (Next Sentence Prediction – NSP): BERT đọc một cặp hai câu văn nối tiếp nhau, và phải dựa vào vector để phán đoán xem câu thứ hai có thực sự là câu đứng liền sau câu thứ nhất trong văn bản gốc hay chỉ là một câu ngẫu nhiên ghép vào. Như bài báo mô tả: “Trạng thái ẩn cuối cùng tương ứng với token này được sử dụng làm biểu diễn tổng hợp của cả chuỗi cho các tác vụ phân loại.” Vector của token [CLS] chính là biểu diễn kích thước cố định của toàn bộ văn bản, và đầu dự đoán (head) của bộ phân loại chỉ việc đọc vector này.
Để tinh chỉnh (fine-tune) BERT cho một bài toán phân loại cụ thể, ta chỉ cần gắn thêm một đầu dự đoán đọc vector , rồi huấn luyện toàn bộ mạng trên các mẫu có nhãn trong khoảng từ 2 đến 4 kỷ nguyên (epochs) với một tốc độ học rất nhỏ: các tác giả khuyến nghị giá trị nằm trong khoảng từ 2e-5 đến 5e-5. Đây chính là công thức của ULMFiT nhưng đơn giản hơn nhiều vì không cần đến quy trình rã đông dần dần từng tầng. Ngay khi ra mắt, BERT đã xô đổ kỷ lục và thiết lập đỉnh cao mới (state of the art) trên 11 bài toán NLP chuẩn. Trên bảng xếp hạng GLUE — một bộ chuẩn gồm 9 bài toán đánh giá năng lực hiểu ngôn ngữ tự nhiên — điểm số trung bình đã nhảy vọt từ 72.8 của GPT (mục 10.3) lên tới 80.5 với BERT large. Ngoài ra, BERT cũng có thể được sử dụng theo đúng cách của ELMo: giữ đóng băng hoàn toàn và trích xuất các vector của nó làm đặc trưng đầu vào cho một mạng khác. Trên bài toán nhận diện thực thể có tên (named entity recognition – NER), việc ghép nối các vector từ bốn tầng cuối cùng của BERT đóng băng chỉ “kém hơn 0.3 điểm F1 so với việc tinh chỉnh toàn bộ mô hình”.
Các vector đầu ra còn lại của BERT, , chính là các vector nhúng theo ngữ cảnh (contextual embeddings) giống như của ELMo ở mục 8.2, nhưng ưu việt hơn ở chỗ mỗi vector đều phụ thuộc vào toàn bộ các từ ở cả hai phía trái phải ngay tại mọi tầng của mạng. Hãy cùng kiểm tra lại từ đa nghĩa "bank" trên mô hình BERT.
Bài tập 10.2a So sánh các vector của từ “bank” trong mô hình BERT
Hãy lấy mười câu văn có sẵn trong mã khởi đầu: ở năm câu đầu tiên, từ "bank" mang nghĩa là bờ sông; còn ở năm câu cuối, "bank" mang nghĩa là ngân hàng giữ tiền. Trong bộ nhúng tĩnh GloVe, từ "bank" có cùng một vector duy nhất ở tất cả mười câu này. Hãy tính vector của từ "bank" trong từng câu tại hai vị trí: ngay ở đầu vào của BERT và sau tầng cuối cùng của BERT. Tiếp theo, hãy tính độ tương đồng cosine giữa mười vector đó với nhau (ở đầu vào và ở sau tầng cuối), rồi vẽ hai ma trận tương đồng nhiệt tương ứng. Cuối cùng, hãy tính độ tương đồng trung bình giữa hai câu có từ "bank" mang cùng nghĩa, và giữa hai câu có từ "bank" mang khác nghĩa.
from transformers import AutoTokenizer, AutoModel

# BERT base, huấn luyện trên văn bản chữ thường: 12 tầng, vector 768 chiều
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
model = AutoModel.from_pretrained("bert-base-uncased")

# Mười câu chứa từ "bank": 5 câu đầu mang nghĩa bờ sông, 5 câu sau
# mang nghĩa ngân hàng giữ tiền. Ở một số câu, chỉ những từ đứng sau
# "bank" mới cho biết nghĩa của nó.
sentences = [
    "We had a picnic on the bank of the river.",
    "The boat drifted slowly toward the muddy bank.",
    "Fishermen sat along the bank, waiting for a bite.",
    "After the flood, the river overflowed its bank.",
    "The bank was steep and covered with reeds.",
    "I opened an account at the bank.",
    "The bank raised its interest rates again.",
    "She went to the bank to deposit her salary.",
    "The robbers broke into the bank at night.",
    "The bank refused to give him a loan.",
]
meanings = ["river"] * 5 + ["money"] * 5

# Bộ tách từ cắt câu thành các token, đồng thời thêm [CLS] vào đầu
# câu và [SEP] vào cuối câu
encoding = tokenizer(sentences[0])
print(tokenizer.convert_ids_to_tokens(encoding["input_ids"]))
['[CLS]', 'we', 'had', 'a', 'picnic', 'on', 'the', 'bank', 'of', 'the', 'river', '.', '[SEP]']
Hint
Lời gọi model(**encoding, output_hidden_states=True) sẽ trả về các vector của mọi tầng nằm trong thuộc tính hidden_states: đó là một bộ (tuple) gồm 13 tensor, mỗi tensor có kích thước (1, số lượng token, 768). Phần tử đầu tiên (hidden_states[0]) là vector đầu vào của BERT, và phần tử cuối cùng (hidden_states[-1]) là đầu ra sau tầng thứ 12 (tầng cuối cùng). Phương thức tokens.index("bank") sẽ cho biết vị trí của token "bank" trong danh sách token của từng câu.
Hint
Giống như ở bài tập 6, hãy chia mỗi vector cho độ dài (chuẩn Euclid) của chính nó: khi đó, tích giữa ma trận chứa 10 vector đã chuẩn hóa với ma trận chuyển vị của nó sẽ cho ra ngay toàn bộ ma trận tương đồng cosine cùng một lúc. Hàm plt.imshow giúp vẽ ma trận này thành biểu đồ nhiệt trực quan.
Điểm kiểm tra kết quả bạn cần đạt được
Ngay tại đầu vào của BERT, tất cả các vector của từ "bank" ở cả mười câu gần như giống hệt nhau: độ tương đồng trung bình là 0.95 đối với hai câu cùng nghĩa, và 0.96 đối với hai câu khác nghĩa. Thế nhưng sau khi đi qua tầng cuối cùng của BERT, độ tương đồng trung bình giữa các câu cùng nghĩa giữ ở mức cao 0.77, trong khi giữa hai câu khác nghĩa giảm mạnh xuống chỉ còn 0.49: ma trận nhiệt hiện lên hai khối vuông tách biệt rõ rệt. Lời giải chỉ mất khoảng mười lăm giây để chạy xong.
input of BERT: same meaning 0.95, different meanings 0.96
last layer: same meaning 0.77, different meanings 0.49
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from transformers import AutoTokenizer, AutoModel

# BERT base, huấn luyện trên văn bản chữ thường: 12 tầng, vector 768 chiều
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
model = AutoModel.from_pretrained("bert-base-uncased")

# Mười câu chứa từ "bank": 5 câu đầu mang nghĩa bờ sông, 5 câu sau
# mang nghĩa ngân hàng giữ tiền. Ở một số câu, chỉ những từ đứng sau
# "bank" mới cho biết nghĩa của nó.
sentences = [
    "We had a picnic on the bank of the river.",
    "The boat drifted slowly toward the muddy bank.",
    "Fishermen sat along the bank, waiting for a bite.",
    "After the flood, the river overflowed its bank.",
    "The bank was steep and covered with reeds.",
    "I opened an account at the bank.",
    "The bank raised its interest rates again.",
    "She went to the bank to deposit her salary.",
    "The robbers broke into the bank at night.",
    "The bank refused to give him a loan.",
]
meanings = ["river"] * 5 + ["money"] * 5

# Bộ tách từ cắt câu thành các token, đồng thời thêm [CLS] vào đầu
# câu và [SEP] vào cuối câu
encoding = tokenizer(sentences[0])
print(tokenizer.convert_ids_to_tokens(encoding["input_ids"]))
['[CLS]', 'we', 'had', 'a', 'picnic', 'on', 'the', 'bank', 'of', 'the', 'river', '.', '[SEP]']
# (1) Vector của từ "bank" trong mỗi câu: tại đầu vào của BERT
# (hidden_states[0], gồm vector nhúng của token cộng với vector
# nhúng vị trí của nó) và sau tầng cuối cùng (hidden_states[12])
import torch

input_vectors, output_vectors = [], []
for sentence in sentences:
    encoding = tokenizer(sentence, return_tensors="pt")
    tokens = tokenizer.convert_ids_to_tokens(encoding["input_ids"][0])
    position = tokens.index("bank")
    with torch.no_grad():
        outputs = model(**encoding, output_hidden_states=True)
    input_vectors.append(outputs.hidden_states[0][0, position])
    output_vectors.append(outputs.hidden_states[12][0, position])


# (2) Độ tương đồng cosine giữa mười vector, vẽ dưới dạng ma trận:
# mỗi câu ứng với một hàng và một cột
import matplotlib.pyplot as plt

def cosine_similarities(vectors):
    V = torch.stack(vectors)
    V = V / V.norm(dim=1, keepdim=True)
    return V @ V.T   # (10, 10)

similarities = {
    "input of BERT": cosine_similarities(input_vectors),
    "last layer": cosine_similarities(output_vectors),
}
fig, axes = plt.subplots(1, 2, figsize=(8, 3.8), layout="constrained")
for ax, (name, S) in zip(axes, similarities.items()):
    image = ax.imshow(S, cmap="Blues", vmin=0, vmax=1)
    ax.set_title(name)
    ax.set_xticks(range(10), meanings, rotation=90)
    ax.set_yticks(range(10), meanings)
fig.colorbar(image, ax=axes, label="cosine similarity")
plt.show()


# (3) Độ tương đồng trung bình giữa hai câu khác nhau có cùng nghĩa
# và có nghĩa khác nhau
for name, S in similarities.items():
    same, different = [], []
    for i in range(10):
        for j in range(i + 1, 10):
            if meanings[i] == meanings[j]:
                same.append(S[i, j].item())
            else:
                different.append(S[i, j].item())
    print(f"{name}: same meaning {sum(same) / len(same):.2f}, "
          f"different meanings {sum(different) / len(different):.2f}")
input of BERT: same meaning 0.95, different meanings 0.96
last layer: same meaning 0.77, different meanings 0.49
Tại đầu vào của BERT, vector của từ "bank" đơn thuần là tổng của vector nhúng tĩnh của token đó cộng với vector nhúng vị trí của nó trong câu: vì vậy nó vẫn mang bản chất tĩnh giống như trong GloVe, và chút khác biệt nhỏ giữa các câu chỉ đến từ việc từ "bank" đứng ở vị trí thứ mấy trong câu mà thôi. Nhưng sau khi đi qua 12 tầng tự chú ý, các vector đã tự động dịch chuyển tách xa nhau ra theo đúng nét nghĩa thực sự của từ trong câu: hai “bờ sông” có vector tương đồng với nhau hơn hẳn so với một “ngân hàng giữ tiền”. Đây chính là điều mà GloVe hoàn toàn bất lực ở bài tập 6 — nơi từ "bank" bị đóng khung trong một vector duy nhất nghiêng hẳn về tài chính. Đặc biệt, hãy chú ý đến những câu mở đầu bằng cụm "The bank...", chẳng hạn như "The bank was steep and covered with reeds." (Bờ sông dốc đứng và phủ đầy lau sậy) và "The bank refused to give him a loan." (Ngân hàng từ chối cho anh ta vay tiền). Trong các câu này, chỉ những từ xuất hiện phía sau từ "bank" mới tiết lộ nghĩa của nó, và BERT đã xếp chúng vào đúng khối nghĩa một cách hoàn hảo! Mô hình ngôn ngữ một chiều ở bài tập 8.1 (vốn chỉ đọc từ trái sang phải) tuyệt đối không thể làm được điều này. Trong mô hình BERT, vector của một từ phụ thuộc vào toàn bộ các từ khác trong văn bản ở cả hai phía, nhờ đó cùng một từ sẽ nhận được các vector khác nhau ứng với các nét nghĩa khác nhau.
Bây giờ, chúng ta hãy tinh chỉnh BERT trên tập dữ liệu đánh giá phim IMDB. Nếu chạy trên toàn bộ 20,000 bài đánh giá có nhãn, quá trình huấn luyện sẽ mất hơn một giờ đồng hồ trên CPU laptop. Nhưng như bài tập 5.5b và 8.1 đã chứng minh, giá trị của việc tiền huấn luyện tỏa sáng rực rỡ nhất khi dữ liệu có nhãn khan hiếm. Vì vậy, hãy sử dụng đúng tập 1,000 bài đánh giá có nhãn của bài tập 8.1: trên tập dữ liệu ít ỏi này, các mạng LSTM ở bài tập 8.1 chỉ đạt độ chính xác từ 65% đến 70%, còn mạng lấy trung bình sâu ở bài tập 5.5b đạt 82.5%.
Bài tập 10.2b Tinh chỉnh mô hình BERT trên 1,000 bài đánh giá
Hãy gắn thêm một đầu dự đoán (head) vào BERT để đọc vector đầu ra của token [CLS], rồi tinh chỉnh toàn bộ mạng trên 1,000 bài đánh giá có nhãn (sử dụng lần rút mẫu đầu tiên trong ba lần rút của bài tập 8.1) trong 3 kỷ nguyên (epochs), lấy tối đa 256 token đầu tiên của mỗi bài đánh giá. Hãy đo độ chính xác của mô hình trên tập kiểm tra và so sánh với các bộ phân loại ở bài tập 5.5b và 8.1 (vốn được huấn luyện trên cùng số lượng nhãn). Cuối cùng, hãy chạy kiểm tra mô hình trên tập các bài đánh giá khó của bài tập 3.4.
Mã khởi đầu đã thực hiện sẵn bước (1) trong lời giải của bài tập 3.2, liệt kê các bài đánh giá khó của bài tập 3.4, và rút ra đúng 1,000 bài đánh giá giống hệt bài tập 8.1 (biến chosen lưu vị trí của chúng trong train_texts). Mã cũng đã tải sẵn bộ tách từ (tokenizer) của BERT.
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
# [Sao chép từ phần khởi đầu bài 3.4]
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")


# ----------------------
#  Mới trong bài tập này
# ----------------------
# 1.000 bài đánh giá có nhãn từ lần lấy mẫu đầu tiên của bài 8.1
import random

random.seed(0)
chosen = random.sample(range(len(train_labels)), 1000)

# Bộ tách từ của BERT cắt những từ mà nó không biết thành các mảnh
# đã biết: ký hiệu ## đánh dấu một mảnh nối tiếp của từ
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
print(f"\n{tokenizer.tokenize(hard_reviews[12][0])}")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews

['a', 'fl', '##ab', '##berg', '##ast', '##ing', ',', 'me', '##sm', '##eri', '##zing', 'tour', 'de', 'force', '.']
Hint
Hãy tải mô hình BERT bằng lệnh AutoModel.from_pretrained("bert-base-uncased"). Bộ tách từ sẽ chuẩn bị sẵn một lô các bài đánh giá cho mô hình: tokenizer(texts, truncation=True, max_length=256, padding=True, return_tensors="pt"). Khi chạy trên lô dữ liệu này, BERT trả về thuộc tính last_hidden_state chứa các vector ở tầng cuối cùng với kích thước (batch, tokens, 768). Vector của token [CLS] nằm ngay ở vị trí đầu tiên (chỉ số 0).
Hint
Hãy huấn luyện bằng bộ tối ưu hóa torch.optim.AdamW (một biến thể cải tiến của Adam) với tốc độ học 2e-5 theo đúng khuyến nghị của các tác giả BERT, sử dụng kích thước lô gồm 16 bài đánh giá. Nếu dùng tốc độ học lớn như mức 1e-3 ở các bài tập trước, các bước cập nhật quá mạnh sẽ phá hỏng các trọng số đã tiền huấn luyện của BERT.
Hint
Hàm from_pretrained mặc định trả về mô hình ở chế độ suy luận (các tầng dropout bị tắt). Hãy nhớ gọi model.train() trước khi bắt đầu huấn luyện để bật dropout lên, và gọi model.eval() sau khi huấn luyện xong để đánh giá. Trên CPU laptop, 3 kỷ nguyên huấn luyện mất khoảng năm phút, và bước chạy dự đoán trên 25,000 bài đánh giá kiểm tra mất khoảng mười phút.
Điểm kiểm tra kết quả bạn cần đạt được
Sau 3 kỷ nguyên tinh chỉnh trên chỉ 1,000 bài đánh giá, BERT dự đoán đúng tới 89.2% trên tập kiểm tra. Nó giải quyết đúng 10 trên 13 bài đánh giá khó: chỉ còn đoán sai câu "Not bad at all, actually." và hai câu mỉa mai. Toàn bộ lời giải mất khoảng 15 phút trên CPU laptop (hai phần ba thời gian là để chạy dự đoán trên 25,000 bài kiểm tra). Kết quả của bạn có thể xê dịch khoảng 1 điểm phần trăm.
test accuracy: 0.892

label     p(positive)  right  review
positive  0.297        NO     Not bad at all, actually.
negative  0.036        yes    Nothing about this movie is good.
positive  0.910        yes    I wouldn't call it a masterpiece, b…
negative  0.027        yes    Great acting, great lighting and a …
positive  0.987        yes    The first hour is slow and the dial…
negative  0.041        yes    Everyone told me it would be the fi…
negative  0.984        NO     Wow, what a masterpiece. Two hours …
negative  0.952        NO     Brilliant. Another sequel nobody as…
positive  0.981        yes    I expected it to be terrible, but i…
negative  0.029        yes    I expected it to be great, but it w…
positive  0.992        yes    Excellent movie, awesome soundtrack.
positive  0.991        yes    Superb film, wonderful score.
positive  0.896        yes    A flabbergasting, mesmerizing tour …

10 right out of 13
Lời giải 2 ô mã
Chạy các ô mã theo đúng thứ tự này trong một notebook mới: chúng đã bao gồm các lệnh import, bước tải dữ liệu và khởi tạo hạt giống ngẫu nhiên (random seed).
from datasets import load_dataset

imdb = load_dataset("stanfordnlp/imdb")


# (1) Giữ lại 5.000 bài đánh giá huấn luyện làm tập xác thực và
# thay thế các thẻ ngắt dòng HTML bằng khoảng trắng
# [Sao chép từ lời giải bài 3.2, bước (1)]

def clean(texts):
    return [text.replace("<br />", " ") for text in texts]

split = imdb["train"].train_test_split(test_size=5000, seed=0)
train_texts = clean(split["train"]["text"])
val_texts = clean(split["test"]["text"])
test_texts = clean(imdb["test"]["text"])
train_labels = split["train"]["label"]
val_labels = split["test"]["label"]
test_labels = imdb["test"]["label"]

print(f"train: {len(train_texts)} reviews")
print(f"validation: {len(val_texts)} reviews")
print(f"test: {len(test_texts)} reviews")


# Các bài đánh giá khó: (bài đánh giá, nhãn), với 1 là tích cực
# [Sao chép từ phần khởi đầu bài 3.4]
hard_reviews = [
    # Phủ định
    ("Not bad at all, actually.", 1),
    ("Nothing about this movie is good.", 0),
    ("I wouldn't call it a masterpiece, but I didn't regret "
     "a minute.", 1),
    # Tương phản
    ("Great acting, great lighting and a flabbergasting soundtrack, "
     "but not even Zendaya could save this boring, boring plot.", 0),
    ("The first hour is slow and the dialogue is clumsy, but the "
     "ending makes it all worth it.", 1),
    ("Everyone told me it would be the film of the year: great "
     "cast, amazing trailer, brilliant director. What a "
     "disappointment.", 0),
    # Mỉa mai
    ("Wow, what a masterpiece. Two hours of pure brilliance, and I "
     "only checked my watch twenty times. The acting was so "
     "convincing that I truly believed the actors wanted to be "
     "somewhere else. A perfect film if you love naps.", 0),
    ("Brilliant. Another sequel nobody asked for, with the same "
     "jokes as the first one.", 0),
    # Cùng các từ nhưng khác thứ tự
    ("I expected it to be terrible, but it was great.", 1),
    ("I expected it to be great, but it was terrible.", 0),
    # Từ đồng nghĩa, không có từ chung
    ("Excellent movie, awesome soundtrack.", 1),
    ("Superb film, wonderful score.", 1),
    # Từ hiếm
    ("A flabbergasting, mesmerizing tour de force.", 1),
]

print(f"{len(hard_reviews)} hard reviews")


# ----------------------
#  Mới trong bài tập này
# ----------------------
# 1.000 bài đánh giá có nhãn từ lần lấy mẫu đầu tiên của bài 8.1
import random

random.seed(0)
chosen = random.sample(range(len(train_labels)), 1000)

# Bộ tách từ của BERT cắt những từ mà nó không biết thành các mảnh
# đã biết: ký hiệu ## đánh dấu một mảnh nối tiếp của từ
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
print(f"\n{tokenizer.tokenize(hard_reviews[12][0])}")
train: 20000 reviews
validation: 5000 reviews
test: 25000 reviews
13 hard reviews

['a', 'fl', '##ab', '##berg', '##ast', '##ing', ',', 'me', '##sm', '##eri', '##zing', 'tour', 'de', 'force', '.']
# (1) Bộ phân loại: BERT cùng một đầu phân loại đọc vector mới của
# token [CLS] ở vị trí 0. Bộ tách từ đệm các bài đánh giá trong lô
# về cùng độ dài và giữ lại 256 token đầu tiên của các bài dài. Mặt
# nạ chú ý (attention mask) báo cho BERT bỏ qua phần đệm.
import torch
from torch import nn
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "cpu"

class BERTClassifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.bert = AutoModel.from_pretrained("bert-base-uncased")
        self.head = nn.Linear(768, 1)   # p(positive) = sigmoid

    def forward(self, texts):
        batch = tokenizer(texts, truncation=True, max_length=256,
                          padding=True, return_tensors="pt")
        states = self.bert(**batch.to(device)).last_hidden_state
        return self.head(states[:, 0])[:, 0]   # (batch,)

torch.manual_seed(0)
model = BERTClassifier().to(device)


# (2) Tinh chỉnh toàn bộ mạng trên 1.000 bài đánh giá trong 3 epoch,
# theo lô 16 bài với tốc độ học nhỏ. train() bật dropout của BERT,
# còn eval() tắt nó đi.
y_train = torch.tensor(train_labels, dtype=torch.float32)
optimizer = torch.optim.AdamW(model.parameters(), lr=2e-5)
loss_function = nn.BCEWithLogitsLoss()   # sigmoid + cross-entropy
model.train()
random.seed(0)
for epoch in range(3):
    order = list(chosen)
    random.shuffle(order)
    for start in range(0, len(order), 16):
        batch = order[start:start + 16]
        scores = model([train_texts[i] for i in batch])
        loss = loss_function(scores, y_train[batch].to(device))
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
model.eval()


# (3) Độ chính xác trên tập kiểm tra, tính mỗi lần 64 bài đánh giá
def predict(texts):
    probabilities = []
    with torch.no_grad():
        for start in range(0, len(texts), 64):
            scores = model(texts[start:start + 64])
            probabilities.append(torch.sigmoid(scores).cpu())
    return torch.cat(probabilities)

correct = (predict(test_texts) > 0.5) == torch.tensor(test_labels)
test_accuracy = correct.float().mean().item()
print(f"test accuracy: {test_accuracy:.3f}")


# (4) Các bài đánh giá khó, tương tự bài 3.4
p_positive = predict([review for review, label in hard_reviews])

names = ["negative", "positive"]
print("\nlabel     p(positive)  right  review")
right_count = 0
for (review, label), p in zip(hard_reviews, p_positive.tolist()):
    right = (p > 0.5) == (label == 1)
    if right:
        right_count += 1
    mark = "yes" if right else "NO"
    short = review if len(review) <= 36 else review[:35] + "…"
    print(f"{names[label]:9} {p:.3f}        {mark:5}  {short}")
print(f"\n{right_count} right out of {len(hard_reviews)}")
test accuracy: 0.892

label     p(positive)  right  review
positive  0.297        NO     Not bad at all, actually.
negative  0.036        yes    Nothing about this movie is good.
positive  0.910        yes    I wouldn't call it a masterpiece, b…
negative  0.027        yes    Great acting, great lighting and a …
positive  0.987        yes    The first hour is slow and the dial…
negative  0.041        yes    Everyone told me it would be the fi…
negative  0.984        NO     Wow, what a masterpiece. Two hours …
negative  0.952        NO     Brilliant. Another sequel nobody as…
positive  0.981        yes    I expected it to be terrible, but i…
negative  0.029        yes    I expected it to be great, but it w…
positive  0.992        yes    Excellent movie, awesome soundtrack.
positive  0.991        yes    Superb film, wonderful score.
positive  0.896        yes    A flabbergasting, mesmerizing tour …

10 right out of 13
Chỉ với 1,000 bài đánh giá có nhãn, BERT đã đạt độ chính xác 89.2% trên tập kiểm tra: cao hơn 24 điểm phần trăm so với mạng LSTM huấn luyện từ đầu ở bài tập 8.1 trên cùng tập dữ liệu đó, cao hơn 19 điểm phần trăm so với mạng LSTM tiền huấn luyện tốt nhất của bài 8.1, và cao hơn từ 6 đến 8 điểm phần trăm so với các mạng lấy trung bình sâu ở bài tập 5.5b. Thậm chí, chỉ học từ 1,000 nhãn nhưng BERT đã đánh bại tất cả các bộ phân loại mà chúng ta từng huấn luyện trên toàn bộ 20,000 nhãn ở các mục trước (vốn cao nhất chỉ đạt 88.4%)! Mặc dù công thức thực hiện ở đây giống hệt như bài tập 8.1: tiền huấn luyện bộ mã hóa trên văn bản thô, gắn thêm một đầu dự đoán, rồi tinh chỉnh toàn bộ mạng. Thứ tạo nên sự khác biệt một trời một vực chính là quy mô của quá trình tiền huấn luyện: 3.3 tỷ từ và 110 triệu tham số của BERT, đối đầu với 10 triệu từ và khoảng 1 triệu tham số của mạng LSTM nhỏ. Tập các bài đánh giá khó cho thấy rõ sức mạnh mà BERT mang lại. Nó hiểu chính xác cấu trúc phủ định trong "Nothing about this movie is good." và "I wouldn't call it a masterpiece, but I didn't regret a minute.", xử lý đúng cả ba câu có cấu trúc tương phản, cũng như phân biệt rành mạch hai câu có cùng tập từ vựng nhưng đảo vị trí. Nó chỉ còn bỏ sót câu "Not bad at all, actually." cùng hai câu mỉa mai (mà nó dự đoán nhầm là tích cực với xác suất trên 0.95): một nghìn bài đánh giá phim vẫn chưa đủ để dạy cho mô hình biết rằng câu “Tôi chỉ phải nhìn đồng hồ có hai mươi lần thôi” không phải là một lời khen. Một bộ mã hóa lớn đã qua tiền huấn luyện chuyển giao được nhiều tri thức về ngôn ngữ đến mức chỉ cần một nghìn bài đánh giá có nhãn là đã quá đủ.
Nếu được tinh chỉnh trên toàn bộ 20,000 bài đánh giá có nhãn và đọc tối đa 510 token ở mỗi bài, mô hình BERT base đạt độ chính xác 94.6% trên tập IMDB. Con số này còn vọt lên tới 95.6% nếu trước khi tinh chỉnh phân loại, ta tiếp tục tiền huấn luyện BERT (với mục tiêu điền từ bị che MLM) trên chính các bài đánh giá của IMDB — tương tự như giai đoạn thứ hai trong quy trình của ULMFiT (Sun et al., 2019).
10.3 Từ GPT-1 đến GPT-3, rồi đến InstructGPT
Vài tháng trước khi BERT ra đời, vào tháng 6 năm 2018, Alec Radford cùng các đồng nghiệp tại OpenAI đã lựa chọn nửa còn lại của kiến trúc Transformer: bộ giải mã (decoder) (Radford et al., 2018). Bản thân một bộ giải mã Transformer chính là một mô hình ngôn ngữ tự nhiên: nhờ có mặt nạ che (mask) ở mục 10.1, mỗi token chỉ được phép chú ý vào các token đứng trước nó; vì vậy mạng có thể được huấn luyện trực tiếp trên văn bản thô để dự đoán token tiếp theo giống hệt như mạng LSTM ở mục 7.3, nhưng ưu việt hơn ở chỗ tất cả các vị trí trong văn bản đều được tính toán song song cùng một lúc. Mô hình của họ — ngày nay được gọi là GPT-1 (viết tắt của generative pre-training – Tiền huấn luyện sinh) — gồm 12 tầng, kích thước vector 768, 12 đầu chú ý, và đọc tối đa 512 token một lúc. Mạng được tiền huấn luyện trên kho dữ liệu BooksCorpus gồm hơn 7,000 cuốn sách chưa xuất bản, được lựa chọn bởi “nó chứa những đoạn văn bản liền mạch dài, cho phép mô hình sinh học cách phụ thuộc vào thông tin ở khoảng cách xa”.
Sau khi tiền huấn luyện, GPT-1 cũng được tinh chỉnh cho từng bài toán đích bằng cách gắn thêm một đầu dự đoán tuyến tính, giống như ULMFiT và BERT. Tuy nhiên, bên trong một bộ giải mã có mặt nạ che một chiều, vector của mỗi token chỉ phụ thuộc vào các token đứng trước nó, nên token đầu tiên không thể nào tóm tắt được toàn bộ văn bản như cách thẻ [CLS] làm trong BERT. Token duy nhất đã đọc qua toàn bộ văn bản chính là token nằm ở vị trí cuối cùng! Vì vậy, GPT-1 gắn thêm một ký hiệu đặc biệt vào cuối văn bản — gọi là token trích xuất (extract token) — và đầu dự đoán sẽ đọc vector tại vị trí cuối cùng này:
Được tinh chỉnh theo cách này, GPT-1 đã phá kỷ lục (state of the art) trên 9 trong tổng số 12 bài toán được khảo sát trong bài báo. Đáng chú ý hơn, nhóm tác giả còn nhận ra một hiện tượng thú vị khác: ngay cả khi không hề qua bước tinh chỉnh nào, chỉ riêng mô hình ngôn ngữ gốc cũng đã tự giải được một số bài toán ở mức độ nhất định. Chẳng hạn, để xác định cảm xúc của một câu văn, họ chỉ việc nối thêm từ "very" vào cuối câu đó, rồi so sánh xác suất mà mô hình ngôn ngữ gán cho hai từ tiếp theo là "positive" và "negative". Những mẹo nhỏ như vậy hoạt động ngày càng hiệu quả hơn khi quá trình tiền huấn luyện diễn ra lâu hơn (Hình 2 trong bài báo của họ).
Tháng 2 năm 2019, GPT-2 đã đẩy ý tưởng táo bạo này đi đến tận cùng (Radford et al., 2019). Kiến trúc mạng vẫn giữ nguyên như GPT-1 nhưng được phóng đại quy mô lên gấp bội: sâu tới 48 tầng với 1.5 tỷ tham số, và mở rộng cửa sổ ngữ cảnh lên 1,024 token. Mô hình được huấn luyện trên WebText — một kho ngữ liệu nặng 40 GB thu thập từ 8 triệu trang web được dẫn link từ mạng xã hội Reddit thông qua các bài đăng có ít nhất 3 điểm bình chọn (karma), như một bộ lọc tự nhiên cho thấy có người đọc thực sự thấy trang web đó hữu ích. Và điểm đột phá về mặt tư duy là: GPT-2 hoàn toàn không cần tinh chỉnh (fine-tune) bất kỳ tham số nào. Luận điểm cốt lõi của bài báo được tuyên bố ngay trong phần tóm tắt: “các mô hình ngôn ngữ bắt đầu tự học các tác vụ này mà không cần bất kỳ sự giám sát tường minh nào”. Mọi bài toán xử lý ngôn ngữ thực chất đều có thể diễn đạt thành văn bản thuần túy — chẳng hạn một yêu cầu dịch thuật có thể viết thành chuỗi "(translate to french, english text, french text)" — và một mô hình ngôn ngữ được huấn luyện trên kho văn bản đủ lớn ắt hẳn đã từng bắt gặp những chuỗi tương tự như vậy trên Internet, nên nó tự khắc học được cách viết tiếp phần trả lời bởi việc đó giúp dự đoán chính xác các từ tiếp theo! Để yêu cầu tóm tắt một bài báo, người ta chỉ việc cho GPT-2 đọc bài báo đó kèm theo cụm ký hiệu "TL;DR:" ở cuối (cách viết tắt quen thuộc trên mạng Internet trước một đoạn tóm tắt). Để yêu cầu dịch câu, người ta cho nó đọc một vài cặp câu mẫu viết theo định dạng "câu tiếng Anh = câu tiếng Pháp", rồi đưa câu tiếng Anh cần dịch kèm theo dấu "=". Kết quả trên các tác vụ này lúc bấy giờ còn khá khiêm tốn (ví dụ đạt 11.5 điểm BLEU khi dịch từ Pháp sang Anh). Thế nhưng trên bài toán mô hình hóa ngôn ngữ, kết quả của GPT-2 thực sự gây chấn động.
Không cần bất kỳ một bước cập nhật trọng số nào trên tập dữ liệu WikiText-2 (zero-shot), GPT-2 đã đánh bại mọi mô hình từng được huấn luyện chuyên biệt trên tập dữ liệu này: phiên bản nhỏ nhất của nó (có kích thước ngang với GPT-1) đạt mức perplexity trên tập kiểm tra là 29.41 (so với kỷ lục tốt nhất trước đó là 39.14), còn phiên bản GPT-2 lớn nhất kéo con số này xuống chỉ còn 18.34!
Phần còn lại của câu chuyện lịch sử này hẳn bạn đã biết rất rõ. Tháng 5 năm 2020, GPT-3 ra đời — thực chất chính là kiến trúc GPT-2 được phóng đại quy mô lên gấp hơn một trăm lần (Brown et al., 2020): 175 tỷ tham số, 96 tầng mạng, kích thước vector ẩn 12,288, độ dài ngữ cảnh 2,048 token, và được huấn luyện trên 300 tỷ token thu thập từ mạng Internet, sách và Wikipedia. Bài báo GPT-3 đã chính thức đặt tên cho phương thức hoạt động của GPT-2 là học trong ngữ cảnh (in-context learning): bài toán cần giải quyết được mô tả trực tiếp ngay trong đoạn văn bản đầu vào đưa cho mô hình — gọi là lời nhắc (prompt) — kèm theo một vài ví dụ mẫu (few-shot examples), và mô hình chỉ việc sinh tiếp các từ kế tiếp.
Đây chính là điểm đích cuối cùng cho câu hỏi lớn thứ hai xuyên suốt chương học của chúng ta. Từ mục 2 đến mục 4, chẳng có tri thức nào được chuyển giao từ bài toán này sang bài toán khác. Mục 5 chuyển giao được tầng vector nhúng; mục 8 chuyển giao toàn bộ bộ mã hóa; rồi đến BERT và GPT-1 chuyển giao mọi thứ ngoại trừ đầu dự đoán (head). Đến GPT-3, ngay cả đầu dự đoán riêng biệt cũng biến mất hoàn toàn! Câu trả lời cho mọi bài toán giờ đây chính là những từ tiếp theo của văn bản, do đó tầng đầu ra dự đoán từ của mô hình ngôn ngữ — thứ từng bị mục 8 vứt bỏ đi khi chuyển sang phân loại — nay nghiễm nhiên trở thành đầu dự đoán vạn năng cho mọi bài toán, và không còn bất kỳ tham số nào cần phải huấn luyện lại cho từng bài toán riêng lẻ nữa. Bài toán được viết ngay trong lời nhắc (prompt), và mô hình ngôn ngữ tiền huấn luyện tự mình đảm đương tất cả.
Dẫu vậy, lúc đó vẫn còn thiếu một mảnh ghép cuối cùng. Một mô hình ngôn ngữ thuần túy chỉ học cách viết tiếp văn bản sao cho giống với những gì thường thấy trên mạng Internet — mà điều đó hoàn toàn không đồng nghĩa với việc làm đúng theo yêu cầu của người dùng. Như nhóm tác giả của InstructGPT đã chỉ rõ: mục tiêu “dự đoán token tiếp theo trên một trang web từ Internet […] khác hẳn với mục tiêu ‘làm theo chỉ dẫn của người dùng một cách hữu ích và an toàn’” (Ouyang et al., 2022). Tháng 3 năm 2022, họ đã huấn luyện tiếp GPT-3 để dạy nó biết làm theo chỉ dẫn của con người thông qua quy trình ba bước kinh điển: (1) tinh chỉnh có giám sát trên các câu trả lời mẫu do con người biên soạn (SFT), (2) huấn luyện một mô hình phần thưởng (reward model) dựa trên việc con người chấm điểm xếp hạng giữa nhiều câu trả lời khác nhau, và (3) tối ưu hóa mô hình ngôn ngữ theo mô hình phần thưởng đó bằng học tăng cường (RLHF). Kết quả đạt được vô cùng ấn tượng: “câu trả lời từ mô hình InstructGPT chỉ có 1.3 tỷ tham số lại được người đánh giá ưa chuộng hơn hẳn câu trả lời từ mô hình GPT-3 khổng lồ 175 tỷ tham số, mặc dù có số lượng tham số ít hơn gấp hơn 100 lần”. Giai đoạn huấn luyện sau cùng này — được gọi là hậu huấn luyện (post-training) — chính là bước biến một mô hình ngôn ngữ đơn thuần thành một trợ lý AI thông minh. Đó sẽ là chủ đề của một chương khác trong khóa học này.
Nếu muốn đào sâu hơn nữa, bạn có thể thử sức với các bài tập mở rộng dưới đây.
Khám phá từng tầng của BERT. Hãy lặp lại thí nghiệm ở bài tập 10.2a cho từng tensor trong số 13 tensor thuộc hidden_states, rồi vẽ đồ thị biểu diễn độ tương đồng trung bình giữa các câu cùng nghĩa và giữa các câu khác nghĩa biến thiên theo thứ tự tầng (từ tầng 0 đến tầng 12). Bắt đầu từ tầng thứ mấy thì hai nét nghĩa của từ "bank" tách biệt rõ rệt khỏi nhau?
Điền vào chỗ trống. Hãy tải mô hình BERT kèm theo đầu dự đoán điền từ tiền huấn luyện bằng lệnh AutoModelForMaskedLM.from_pretrained("bert-base-uncased"), và in ra 5 token có xác suất cao nhất mà BERT dự đoán cho vị trí [MASK] trong một vài câu văn tự chọn, chẳng hạn như "The movie was [MASK]." hoặc "I went to the [MASK] to deposit my salary.".
Sử dụng BERT làm bộ trích xuất đặc trưng. Hãy đóng băng (freeze) toàn bộ mô hình BERT, tính vector của token [CLS] cho từng bài đánh giá, rồi huấn luyện một bộ hồi quy logistic trên các vector đó giống như ở bài tập 8.1 (thử nghiệm với cả 1,000 nhãn và 20,000 nhãn). Độ chính xác theo cách này kém việc tinh chỉnh toàn bộ mạng (fine-tuning) bao xa? Hãy thử thay vector [CLS] bằng vector trung bình cộng của tất cả các token trong bài đánh giá xem kết quả có cải thiện thêm không.
Tinh chỉnh BERT trên toàn bộ tập nhãn. Hãy tinh chỉnh BERT trên toàn bộ 20,000 bài đánh giá có nhãn trong 2 kỷ nguyên trên GPU (bạn có thể dùng GPU miễn phí của Google Colab là đủ), và so sánh kết quả với con số 94.6% của Sun và cộng sự (Sun et al., 2019). Trong bài báo đó, đối với những bài đánh giá dài, nhóm tác giả đã giữ lại 128 token đầu tiên và 382 token cuối cùng (thay vì chỉ cắt lấy phần đầu): chi tiết xử lý này có tạo ra khác biệt lớn không?
Phân tích cảm xúc không cần huấn luyện (Zero-shot sentiment). Hãy áp dụng mẹo của GPT-1 trên phiên bản GPT-2 nhỏ nhất (gpt2): nối thêm chuỗi " very" vào cuối mỗi bài đánh giá, rồi so sánh xác suất mà mô hình gán cho hai token tiếp theo là " positive" và " negative". Cách làm không cần huấn luyện này đoán đúng được bao nhiêu câu trong tập bài đánh giá khó, và đạt độ chính xác bao nhiêu trên 1,000 bài đánh giá kiểm tra?
Đo Perplexity của GPT-2 trên WikiText-2. Hãy đo độ hỗn loạn (perplexity) của cả bốn phiên bản mô hình GPT-2 (gpt2, gpt2-medium, gpt2-large và gpt2-xl) trên tập kiểm tra của WikiText-2, và vẽ đồ thị biểu diễn perplexity theo số lượng tham số của mô hình. Lưu ý: hãy nối các từ kiểm tra của bài tập 2.2 lại bằng khoảng trắng, và tính perplexity theo đơn vị từ (word-level perplexity): bằng hàm mũ () của trừ tổng log-xác suất của tất cả các token chia cho tổng số từ (chứ không phải chia cho số lượng token từ phụ), để kết quả có thể so sánh trực tiếp công bằng với các mô hình từ đầu chương. Vì GPT-2 chỉ đọc tối đa 1,024 token một lúc, hãy trượt một cửa sổ dài 1,024 token dọc theo văn bản với bước nhảy 512 token, và ở mỗi cửa sổ chỉ tính điểm cho những token mới chưa được cửa sổ trước đó tính điểm. Hãy đối chiếu kết quả thu được với Bảng 3 trong bài báo gốc (Radford et al., 2019).
Bộ phát hiện văn bản do AI viết. Hãy tinh chỉnh mô hình BERT để phân biệt các bài đánh giá phim do con người thật viết với các bài đánh giá do một mô hình ngôn ngữ tự động sinh ra — giống như nguyên lý của các công cụ phát hiện văn bản AI hiện nay.
Tự tạo một bản sao JEV giá rẻ. Gần đây, JEV rất được chú ý như một “bộ phân loại đa năng tổng quát” (general purpose classifier). Nhiều dự án mã nguồn mở đã cố gắng tái tạo lại kết quả của nó, chẳng hạn bằng cách xuất phát từ một mô hình họ BERT. Bạn hoàn toàn có thể thử tự xây dựng một phiên bản của riêng mình!
Tài liệu tham khảo
- 1913 An Example of Statistical Investigation of the Text Eugene Onegin Concerning the Connection of Samples in Chains. Bulletin of the Imperial Academy of Sciences of St. Petersburg. English translation: Science in Context, 2006. 2
- 1948 A Mathematical Theory of Communication. Bell System Technical Journal. 2.1
- 1951 Prediction and Entropy of Printed English. Bell System Technical Journal. 2.2
- 1954 Distributional Structure. Word. 5.1
- 1957 A Synopsis of Linguistic Theory, 1930–1955. Studies in Linguistic Analysis. 5.1
- 1972 A Statistical Interpretation of Term Specificity and Its Application in Retrieval. Journal of Documentation. 3.3
- 1975 A Vector Space Model for Automatic Indexing. Communications of the ACM. 3.2
- 1986 Learning Distributed Representations of Concepts. Annual Conference of the Cognitive Science Society. 4.1
- 1987 Estimation of Probabilities from Sparse Data for the Language Model Component of a Speech Recognizer. IEEE Transactions on Acoustics, Speech, and Signal Processing. 2.3
- 1990 Indexing by Latent Semantic Analysis. Journal of the American Society for Information Science. 4.1
- 1990 Finding Structure in Time. Cognitive Science. 7.1
- 1990 Backpropagation Through Time: What It Does and How to Do It. Proceedings of the IEEE. 7.2
- 1991 Untersuchungen zu dynamischen neuronalen Netzen. Diploma thesis, Technische Universität München. 7.2
- 1993 The Mathematics of Statistical Machine Translation: Parameter Estimation. Computational Linguistics. 9.3
- 1994 Learning Long-Term Dependencies with Gradient Descent is Difficult. IEEE Transactions on Neural Networks. 7.2
- 1997 Long Short-Term Memory. Neural Computation. 7.2
- 1999 An Empirical Study of Smoothing Techniques for Language Modeling. Computer Speech & Language. 2.3
- 2002 Thumbs up? Sentiment Classification using Machine Learning Techniques. EMNLP. 3.2, 3.4
- 2002 BLEU: a Method for Automatic Evaluation of Machine Translation. ACL. 9.3
- 2003 A Neural Probabilistic Language Model. Journal of Machine Learning Research. 4.2
- 2003 Statistical Phrase-Based Translation. NAACL. 9.3
- 2010 Recurrent Neural Network Based Language Model. Interspeech. 7.3
- 2011 Natural Language Processing (Almost) from Scratch. Journal of Machine Learning Research. 5.1, 7
- 2011 Learning Word Vectors for Sentiment Analysis. ACL. giới thiệu, 3.3
- 2012 Baselines and Bigrams: Simple, Good Sentiment and Topic Classification. ACL. 3.3, 3.4, 6
- 2013 Generating Sequences With Recurrent Neural Networks. arXiv. 7.3
- 2013 Efficient Estimation of Word Representations in Vector Space. ICLR 2013, workshop. 5.2, 5.4
- 2013 Distributed Representations of Words and Phrases and their Compositionality. NeurIPS. 5.2, 5.4
- 2013 Linguistic Regularities in Continuous Space Word Representations. NAACL-HLT. 5.4
- 2013 On the Difficulty of Training Recurrent Neural Networks. ICML. 7.2
- 2013 Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank. EMNLP. 5.5
- 2014 Neural Machine Translation by Jointly Learning to Align and Translate. arXiv (ICLR 2015). 9.2, 9.3
- 2014 Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation. EMNLP. 7.2, 9.1
- 2014 On the Properties of Neural Machine Translation: Encoder–Decoder Approaches. Workshop on Syntax, Semantics and Structure in Statistical Translation. 9.1
- 2014 Convolutional Neural Networks for Sentence Classification. EMNLP. 5.5, 7, 7.3
- 2014 Neural Word Embedding as Implicit Matrix Factorization. NeurIPS. 5.3, 5.5
- 2014 GloVe: Global Vectors for Word Representation. EMNLP. 5.3
- 2014 Sequence to Sequence Learning with Neural Networks. NeurIPS. 9.1
- 2014 Recurrent Neural Network Regularization. arXiv. 7.3
- 2015 Semi-supervised Sequence Learning. NeurIPS. 7.2, 8.1
- 2015 Deep Unordered Composition Rivals Syntactic Methods for Text Classification. ACL. 4.3, 5.5
- 2015 An Empirical Exploration of Recurrent Network Architectures. ICML. 7.2, 7.3
- 2015 The Unreasonable Effectiveness of Recurrent Neural Networks. Blog post. 7.3
- 2015 Effective Approaches to Attention-based Neural Machine Translation. EMNLP. 9.2
- 2016 Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings. NeurIPS. 5.4
- 2016 A Theoretically Grounded Application of Dropout in Recurrent Neural Networks. NeurIPS. 7.3
- 2016 Pointer Sentinel Mixture Models. arXiv (ICLR 2017). giới thiệu, 7.3
- 2016 Neural Machine Translation of Rare Words with Subword Units. ACL. 7.3, 9.3
- 2016 Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translation. arXiv. 9.3
- 2017 Enriching Word Vectors with Subword Information. Transactions of the ACL. 7.3
- 2017 Bag of Tricks for Efficient Text Classification. EACL. 4.3
- 2017 Learned in Translation: Contextualized Word Vectors. NeurIPS. 8.2
- 2017 Semi-supervised Sequence Tagging with Bidirectional Language Models. ACL. 8.2
- 2017 Learning to Generate Reviews and Discovering Sentiment. arXiv. 8.1, 8.2
- 2017 Attention Is All You Need. NeurIPS. 10.1
- 2018 Linear Algebraic Structure of Word Senses, with Applications to Polysemy. TACL. 6
- 2018 BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL 2019 (arXiv 2018). 10.2
- 2018 Universal Language Model Fine-tuning for Text Classification. ACL. 8.1, 8.2
- 2018 Regularizing and Optimizing LSTM Language Models. ICLR. 8.1
- 2018 Deep Contextualized Word Representations. NAACL. 8.2
- 2018 Improving Language Understanding by Generative Pre-Training. OpenAI report. 10.3
- 2019 Language Models are Unsupervised Multitask Learners. OpenAI report. 10.3
- 2019 How to Fine-Tune BERT for Text Classification?. CCL 2019. 10.2, 10.3
- 2020 Language Models are Few-Shot Learners. NeurIPS. 10.3
- 2020 Fair is Better than Sensational: Man is to Doctor as Woman is to Doctor. Computational Linguistics. 5.4, 5.5
- 2022 Training Language Models to Follow Instructions with Human Feedback. NeurIPS. 10.3
- 2023 Advancing State of the Art in Language Modeling. arXiv. 2.2, 2.3, 6